Del 1
Bakgrunn og analyse
2 Høyere utdanning i Norge
2.1 Innledning
Dette kapittelet beskriver vårt system for høyere utdanning og gir en overordnet analyse av hvilken betydning kunstig intelligens (KI) har for høyere utdanning. Først gis en beskrivelse av høyere utdannings formål (2.2); relevante aktører i systemet, med nøkkeltall (2.3); et utvalg av betydningsfulle lov- og forskriftsbestemmelser (2.4) og viktige arenaer og rammer for internasjonalt samarbeid (2.5). Deretter gir kapittelet en analyse av de utdanningsfaglige problemstillingene KI reiser for høyere utdanning (2.6) og en analyse av hvordan KI utfordrer universitetenes og høyskolenes rolle som utdanningstilbydere (2.7).
2.2 Formål
Høyere utdanning er utdanning ved universiteter og høyskoler. Sammen med høyere yrkesfaglig utdanning (fagskoleutdanning) utgjør høyere utdanning den øverste delen av det norske utdanningssystemet. Universitets- og høyskoleloven (uhl.) slår fast at høyere utdanning skal være basert på «det fremste innenfor forskning, faglig og kunstnerisk utviklingsarbeid og erfaringskunnskap» (uhl. § 2-1 bokstav a).
I tråd med mandatet retter utvalgets arbeid seg etter etablerte formål for høyere utdanning, slik de kommer til uttrykk i regjeringens Langtidsplan for forskning og høyere utdanning (Meld. St. 5 (2022–2023), s. 9 og 22–23) og universitets- og høyskoleloven. Utvalgets vurderinger av hvordan høyere utdanning påvirkes av KI tar derfor utgangspunkt i disse formålene.
Høyere utdanning skal gi studenter kompetanse til både å møte dagens og fremtidens behov og å bidra til utvikling og endring. Dette har verdi både for den enkelte og for samfunnet: Det legger grunnlaget for arbeidsmuligheter, individuell og kollektiv verdiskapning og for at vi som samfunn får løst viktige oppgaver, også under endrede teknologiske forutsetninger (Meld. St. 5 (2022–2023), s. 9, 23 og 66).
Videre skal høyere utdanning være en kilde til personlig utvikling, frigjøring og dannelse (Meld. St. 5 (2022–2023), s. 9 og 22–23). Gjennom å utvikle ferdigheter i kritisk og kreativ tenkning, å bli integrert i fagfellesskap og få kjennskap til akademiske tenkemåter og tradisjoner, skal studenter kunne utvikle og realisere sitt potensial som individer. På samfunnsnivå legger slike ferdigheter og kunnskap grunnlaget for et fungerende demokrati og en bærekraftig samfunnsutvikling (jf. uhl. § 1-1 bokstav d). Det er også et fastsatt mål at høyere utdanning skal bidra til å bevare og styrke norsk språk (jf. uhl. § 2-3), og enkelte institusjoner er gitt et særlig ansvar for samisk forskning, utdanning og fagspråk.
Et tema som ligger implisitt i formålene, er at man i høyere utdanning skal lære å lære. Dette er noe som over et livsløp kommer både individet og samfunnet til gode (jf. uhl. § 2-1 bokstav d om livslang læring).
Blant kjerneverdiene for høyere utdanning i Norge er en fri og kritisk utveksling av tanker og ideer. Herunder ligger den lovfestede akademiske friheten for institusjonene og individet, verdien av dannelse, av sannhetssøking og av en tett kobling mellom utdanning og forskning.
I tillegg til de lovfestede formålene for høyere utdanning vil utvalget fremheve universitetenes og høyskolenes sertifiseringsfunksjon. Gjennom grader, vitnemål og karakterer stadfester institusjonene at studentene har oppnådd bestemte læringsutbytter, og gir samfunnet et grunnlag for å vurdere kompetanse. God sertifisering og rangering bidrar til riktig, effektiv og rettferdig fordeling av muligheter til arbeid, videre utdanning, verv mv. Sertifiseringen fungerer slik som en betingelse for at verdien av høyere utdanning blir anerkjent og realisert.
2.3 Aktører og nøkkeltall
For å gjøre gode vurderinger av hvilke problemstillinger KI reiser for høyere utdanning og hvilke tiltak som kan være best egnet til å svare på disse, har utvalget orientert seg nærmere om hovedaktørene innen høyere utdanning i Norge. De følgende underkapitlene redegjør for noen av de viktigste trekkene av relevans for utredningen. Innholdet er organisert rundt studentene (2.3.1), universiteter og høyskoler (2.3.2), samarbeids- og interesseorganisasjoner (2.3.3), sentrale myndigheter (2.3.4) og arbeids- og næringslivet (2.3.5).
2.3.1 Studenter
Studentene skal ha nytte av de individrettede formålene med høyere utdanning, og det er gjennom studentene og deres læringsutbytte at samfunnsgevinstene av høyere utdanning realiseres.
Høyere utdanning har vært i sterk vekst i Norge over lang tid. I 1960 var det færre enn 10 000 studenter i høyere utdanning (Myhre, 2013). Da kvalitetsreformen ble innført i 2003, var antallet over 200 000, og høsten 2025 var det nærmere 310 000 studenter, ikke medregnet doktorgradsstudenter (DBH, 2025a). Antall registrerte studenter i Norge har aldri vært høyere. Utdanning har gått fra å være et gode få hadde del i, til at over halvparten fra hvert årskull fullfører en høyere utdanning (Statistisk sentralbyrå, 2025b).
Denne veksten innebærer også at studentgruppen over tid er blitt mer mangfoldig og sammensatt med hensyn til kjønn, alder, livssituasjon og sosioøkonomisk og kulturell bakgrunn. Andelen kvinnelige studenter har vært stadig økende og er nå over 60 prosent. Andelen innvandrere og norskfødte med innvandrerforeldre har på ti år økt fra 13 til nærmere 19 prosent av studentene (HK-dir, 2026c). Stadig flere unge med foreldre uten høyere utdanning tar selv høyere utdanning (Grendal, 2022). Samtidig har sosial bakgrunn fortsatt betydning for studievalg og gjennomføring i hele utdanningsløpet (HK-dir, 2024a). Andelen studenter som har en synlig eller usynlig funksjonsnedsettelse har også økt de senere årene, og det samme har antallet studenter på opplæringstiltak støttet av Nav (HK-dir, 2025a).
Bruken av KI-systemer har ulik betydning for ulike fag. Figur 2.1 viser en prosentvis fordeling av studenter på fagområder i tråd med den groveste inndelingen av fagområder i høyere utdanning i Norsk standard for utdanningsgruppering (NUS) fra Statistisk sentralbyrå (SSB).
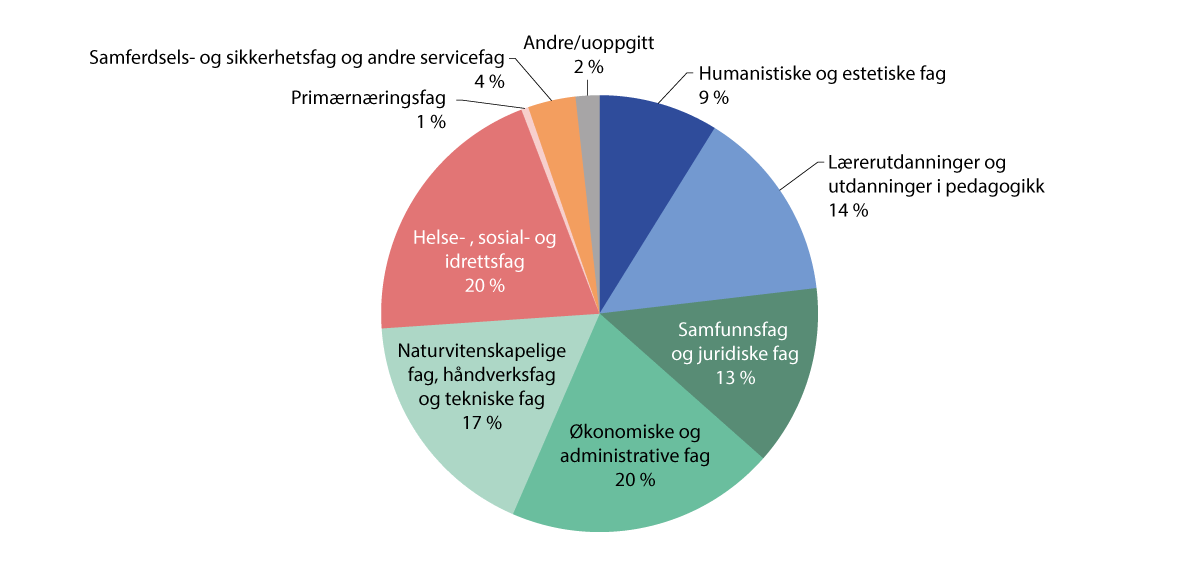
Figur 2.1 Studenter i høyere utdanning 2025, prosentvis fordeling på fagområder
Kilde: Statistisk sentralbyrå (2026a)
Innenfor disse fagområdene er det mange ulike fag og studietilbud. Per 2025 finnes det over 5000 studieprogrammer i sektoren samlet sett, herunder årsenheter, bachelorprogrammer, masterprogrammer og profesjonsstudier (DBH, 2025b).
Mellom en firedel og en tredel av studentene i høyere utdanning er på rammeplanstyrte utdanninger i helse- og sosialfag og lærerutdanninger (DBH, 2025a). Disse utdanningene er underlagt en sterkere sentral styring enn andre utdanninger, med formål om blant annet å sikre likeverdige tjenestetilbud. Rammeplanenes regulering av læringsinnhold er beskrevet i kapittel 5.
Stadig flere kombinerer studier med betalt arbeid, og mange balanserer studier med familie- og omsorgsansvar. Dette har betydning for hvordan institusjonene organiserer undervisning, veiledning, vurdering, digitale tjenester og arbeid med læringsmiljøet. I 2004 var over 98 prosent av alle studenter på tradisjonelle, campusbaserte studietilbud. Siden da har andelen som tar fleksible (desentraliserte, samlings- og nettbaserte) utdanninger økt betydelig. Som illustrert i Figur 2.2 er det særlig nettbaserte utdanninger som i dag står for et utbredt alternativ til campusbaserte utdanninger, med 12,1 prosent av studentene i høyere utdanning i 2025.
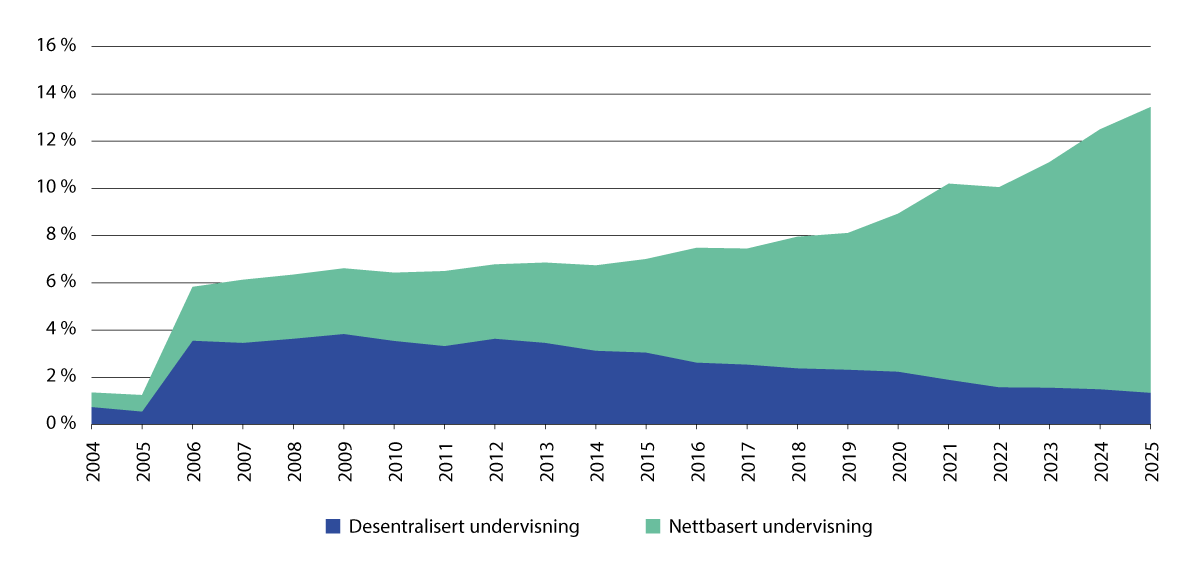
Figur 2.2 Andel studenter på desentraliserte og nettbaserte studietilbud, 2004–2025
Desentraliserte studier foregår ved fysiske samlingssteder som ikke er universitets- eller høyskolecampus. Nettbaserte tilbud kan være heldigitale eller kombinert med fysiske samlinger.
Kilde: DBH, 2025a
2.3.2 Universiteter og høyskoler
Universitetene og høyskolene har som lovfestet formål å tilby høyere utdanning, utføre forskning, formidle kunnskap og bidra til en miljømessig sosialt og økonomisk bærekraftig utvikling (jf. uhl. § 1-1).
En institusjon kan være akkreditert som høyskole, vitenskapelig høyskole eller universitet. Det gir institusjonen myndighet til å akkreditere egne studietilbud, i samsvar med uhl. § 3-4. I Norge finnes det 11 universiteter, 9 vitenskapelige høyskoler, 15 høyskoler med institusjonsakkreditering og ytterligere 13 høyskoler med akkrediterte studietilbud (NOKUT, u.å.). Institusjoner som ikke selv har myndighet til å akkreditere sine studietilbud, må søke NOKUT om dette.
De fleste studenter er på statlige universiteter og høyskoler. Rundt en seksdel er på private høyskoler (DBH, 2025a). Universitetene, som alle er statlige, står for over halvparten av alle studenter.
Alle typer institusjoner kan i prinsippet tilby alle typer utdanning. Sammenslåinger av høyskoler og universiteter, og akkreditering av høyskoler som universiteter og vitenskapelige høyskoler, har gitt et institusjonslandskap preget av få forskjeller mellom hva slags utdanninger som blir tilbudt ved ulike institusjonskategorier (jf. HK-dir, 2025c).
Den store andelen statlig eierskap i universitets- og høyskolesektoren er kombinert med en høy grad av institusjonelt selvstyre. Sentral regulering og styringspraksis etterlater mye rom for hvordan utdanningene skal utformes, innholdet i undervisningen og hvordan studentene skal prøves.
Det institusjonelle selvstyret, forstått som selvbestemmelsesrett overfor eiere og eksterne finansieringskilder, kan sees på som ett aspekt ved den akademiske friheten (NOU 2022: 2, s. 21). Den individuelle akademiske friheten til vitenskapelig ansatte og studenter er også sentral, både som et rådende ideal og et lovfestet prinsipp (jf. uhl. § 2-2). Den innebærer et faglig vern mot utilbørlig innblanding i forskning, undervisning og faglig utviklingsarbeid, innenfor de rammene institusjonen fastsetter gjennom styring og ansettelsesvilkår, eller som følger av lovverket.
Universitets- og høyskolesektoren hadde i 2024 rundt 62 milliarder kroner i inntekter (HK-dir, 2025c). Mesteparten, cirka 46 milliarder, er statlige bevilgninger. Studieavgift står for en stor andel av de private institusjonenes inntekter. De statlige midlene gis som rammebevilgninger med få detaljerte føringer på hvordan de skal disponeres, men med forventninger til hvilke resultater de skal oppnå. Den relative størrelsen på rammebevilgningen til den enkelte institusjon er i hovedsak et resultat av historisk størrelse. Over tid endrer den seg med resultatbasert uttelling for produksjon av studiepoeng og doktorgrader, omfordeling mellom institusjoner og tildeling av studieplassmidler. Noen budsjettmidler kan også være øremerket bestemte formål.
En OECD-sammenlikning viser at vi i Norge bruker mer på høyere utdanning per student enn de fleste andre land, men likevel vesentlig mindre enn USA og Storbritannia, som topper statistikken (OECD, 2025a, s. 286).
I 2025 ble det utført 41 200 årsverk i sektoren, en nedgang på 5 prosent fra toppåret 2023. Undervisnings, forsknings- og formidlingsstillinger (vitenskapelig ansatte) utgjør om lag 61 prosent av årsverkene, med resten fordelt på tekniske og administrative stillinger og andre støttefunksjoner (HK-dir, 2026c).
Hovedtyngden av sektorens virksomhet foregår i store og komplekse institusjoner. I 2025 var 86 prosent av årsverkene ved institusjoner med mer enn 1 000 årsverk (DBH, 2025a). De faglige årsverkene er fordelt mellom fakulteter, institutter og sentre. I tillegg kommer administrative og tekniske enheter. I tråd med denne kompleksiteten er mange beslutninger delegert til lavere nivåer, innenfor rammer satt av institusjonen. Institutter, fagmiljøer og den enkelte fagperson har ofte stort rom til å forme sine studietilbud, for eksempel i valg av undervisningsformer og læringsinnhold (jf. uhl. § 2-2), selv om dette varierer mellom fagområder.
2.3.3 Sektorsamarbeid og interesseorganisasjoner
I tillegg til de formelle styringslinjene finnes det en rekke nasjonale samarbeidsorganer og faglige nettverk som bidrar til koordinering og utvikling i universitets- og høyskolesektoren. En sentral arena for samarbeid i sektoren er Universitets- og høyskolerådet (UHR), som i tillegg representerer interessene til universiteter og høyskoler med institusjonsakkreditering, både statlige og private.
Norsk studentorganisasjon (NSO) er en nasjonal interesseorganisasjon for studenter i Norge, med de lokale studentdemokratiene ved 34 universiteter og høyskoler som medlemslag. Lokalt ved egen institusjon kan studentene opprette et studentorgan for å ivareta deres interesser (jf. uhl. § 10-11). Studenter skal utgjøre minst 20 prosent av medlemmene i alle kollegiale organer ved universiteter og høyskoler som har avgjørelsesmyndighet (jf. uhl. § 10-12).
Universitetene og høyskolene tar også del i den norske modellen for trepartssamarbeid mellom arbeidsgivere, arbeidstakere og myndigheter, både på nasjonalt og lokalt nivå. Arbeidstakerorganisasjoner deltar i drøftinger med arbeidsgiversiden om blant annet arbeidsvilkår, kompetanseutvikling, omstilling og organisering av virksomheten. Spørsmål knyttet til digitalisering og bruk av KI-systemer vil i mange tilfeller berøre arbeidsprosesser, oppgavefordeling, kompetansebehov og organisering av arbeidet.
2.3.4 Sentrale myndigheter
Kunnskapsdepartementet er øverste myndighet for høyere utdanning i Norge. Departementet forvalter statens eierskap av universiteter og høyskoler1, har ansvar for universitets- og høyskoleloven og tilhørende forskrifter, og er ansvarlig for utvikling av politikk for høyere utdanning.
Kunnskapsdepartementet har delegert ansvaret for flere av de nasjonale forvaltningsoppgavene:
-
Direktoratet for høyere utdanning og kompetanse (HK-dir) skal bidra til å utvikle kvaliteten i utdanning og opplæring, styrke internasjonalt samarbeid og støtte digital omstilling i universitets- og høyskolesektoren. HK-dir forvalter det samordnede opptaket, nasjonale og europeiske tilskuddsordninger og godkjenning av utenlandsk utdanning. Direktoratet utarbeider også statistikk og kunnskapsgrunnlag for departementet og utdanningsinstitusjonene. Det har videre ansvar for å følge opp sikkerhets- og beredskapsarbeidet i sektoren.
-
Nasjonalt organ for kvalitet i utdanningen (NOKUT) har ansvar for å akkreditere og føre tilsyn med studietilbud, samt for å evaluere studiekvalitet og stimulere til kvalitetsutvikling.
-
Sikt – Kunnskapssektorens tjenesteleverandør utvikler og tilbyr digitale løsninger og infrastruktur til kunnskapssektoren, herunder KI-systemer og regnekraft gjennom selskapet Sigma2; forhandler felles avtaler for universiteter og høyskoler og tilbyr veiledning og vurdering om personvern.
-
Statens lånekasse for utdanning forvalter utdanningsstøtteordninger (lån og stipend).
2.3.5 Arbeids- og næringsliv
Samarbeid mellom utdanningsinstitusjonene og arbeidslivet bidrar til at utdanningene er samfunns- og arbeidslivsrelevante, at studenter blir kjent med yrkesfeltet og utvikler profesjonsspesifikke ferdigheter, at institusjonene får kjennskap til forskning, faglig utvikling og nye arbeidsmetoder i virksomhetene, og at arbeidsgivere får tilgang til ny kunnskap og kompetanse som kan møte fremtidige utfordringer. Undersøkelser viser at samarbeid med virksomheter i studietiden har betydning for studiegjennomføring og overgang til arbeidsmarkedet (Næss et al., 2012).
Samarbeidet foregår i mange former, både med offentlig sektor, privat næringsliv og frivillig sektor. I mange profesjonsfag er praksisordninger en grunnleggende del av utdanningen. Også i disiplinfag og øvrige utdanninger er samarbeid med arbeidslivet utbredt, blant annet gjennom prosjektoppgaver, praksisopphold, gjesteforelesninger, læringsmateriell og utvikling av studietilbud.
Gjennom organisasjoner som Ungt Entreprenørskap og teknologioverføringsorganisasjoner (Technology Transfer Offices – TTO) bidrar universitetene og høyskolene dessuten til innovasjon og entreprenørskap i samarbeid med arbeidslivet. TTO-ene gir studenter, forskere og institusjoner støtte til å identifisere, utvikle og kommersialisere forskningsbasert kunnskap og teknologi, og fungerer på den måten som et bindeledd mellom akademia, næringsliv og offentlig sektor. De fleste universitetene og flere høyskoler har i tillegg egne enheter og møteplasser som støtter studenter og ansatte i tidlig fase av innovasjonsarbeid (Universitets- og høgskolerådet, 2024). Slik bidrar utdanningsinstitusjonene også til utvikling av nye løsninger, virksomheter og næringer.
2.4 Regulering av høyere utdanning
2.4.1 Universitets- og høyskoleloven
Norsk høyere utdanning er regulert av universitets- og høyskoleloven og tilhørende forskrifter. Loven fastsetter grunnleggende prinsipper for høyere utdanning, og gjelder for både statlige og private institusjoner. Mer detaljerte regler er blant annet fastsatt i forskrift til universitets- og høyskoleloven og forskrift om opptak til høyere utdanning.
I tillegg til de nasjonale reglene fastsetter høyere utdanningsinstitusjoner sine egne forskrifter. De fleste universiteter og høyskoler har fastsatt egne forskrifter om studier og eksamen. Ifølge Lovdata er nærmere to hundre forskrifter hjemlet i universitets- og høyskoleloven.
Utvalget beskriver og anvender lov- og forskriftsbestemmelsene der de har størst betydning, f.eks. regulering av læringsutbytte i kapittel 5 og regulering av eksamen og vurdering i kapittel 7. Noen bestemmelser er likevel verdt å beskrive innledningsvis, enten fordi de er helt grunnleggende eller har betydning for flere temaer. Se også beskrivelsen av formålene med høyere utdanning innledningsvis i dette kapittelet, akademisk frihet i kapittel 2.3.2 og akkrediteringsvilkår nedenfor.
-
Gratisprinsippet (uhl. § 2-5) innebærer at høyere utdanning ved statlige universiteter og høyskoler er gratis, med unntak for studenter fra utenfor EØS-området, og for studier uten studiepoenguttelling eller som i hovedsak retter seg mot arbeidslivet eller personer i arbeid (universitets- og høyskoleforskriften, kap. 4). Private universiteter og høyskoler kan kreve egenbetaling for studiene, men skal bruke egenbetalingen innenfor lovens formål.
-
Gradssystemet er regulert i uhl. § 3-7 med gradene bachelor, master og philosophiae doctor (ph.d.) eller ph.d. i kunstnerisk utviklingsarbeid som hovedalternativer. Loven trekker også et mye brukt skille mellom lavere grader, høyere grader og doktorgrader, som svarer til nivåene 6, 7 og 8 i Nasjonalt kvalifikasjonsrammeverk for livslang læring (forskrift om NKR og EQF).
-
Studentene har rett til et forsvarlig læringsmiljø og til å medvirke i saker som angår studiehverdagen. Fysiske og digitale læringsomgivelser skal være universelt utformet, og studenter med funksjonsnedsettelser eller særskilte behov har rett til individuell tilrettelegging (uhl. kap. 10).
-
Forsøkshjemmelen i uhl. § 17-1 åpner for at Kunnskapsdepartementet kan gi unntak fra loven til tidsavgrensede pedagogiske eller organisatoriske forsøk. Det gjør det mulig å prøve ut nye pedagogiske tilnærminger og tiltak som kan gi grunnlag for å vurdere om reglene bør endres.
2.4.2 Akkreditering av norsk høyere utdanning
Ethvert studietilbud i høyere utdanning må være akkreditert av NOKUT eller av institusjonen selv (universitets- og høyskoleloven, kap. 3; universitets- og høyskoleforskriften, kap. 1). Akkrediteringsvilkårene i universitets- og høyskoleforskriften § 1-11 stiller en rekke grunnleggende krav til studietilbudene. Med hensyn til KIs betydning for høyere utdanning er det relevant å trekke frem at:
-
studietilbudet skal være faglig oppdatert og ha tydelig relevans for videre studier eller arbeidsliv
-
læringsutbyttet til studiet skal være i samsvar med Nasjonalt kvalifikasjonsrammeverk for livslang læring
-
studietilbudets innhold, oppbygging og progresjon skal være tilpasset læringsutbyttet
-
undervisnings-, lærings- og vurderingsformer skal være tilpasset læringsutbyttet
-
studietilbudet skal være utformet slik at det legger til rette for at studentene tar en aktiv rolle i å skape læringsprosessen, og at dette reflekteres i en gjennomtenkt utforming av eksamens- og sensurordning
-
studietilbudet skal ha en relevant kobling til forskning eller kunstnerisk utviklingsarbeid og faglig utviklingsarbeid
-
studietilbudets organisering og infrastruktur skal være tilpasset læringsutbyttet og stå i forhold til antallet studenter
-
studietilbudet skal ha en tydelig faglig ledelse med et definert ansvar for kvalitetssikring og -utvikling av studiet
Universitets- og høyskoleforskriften stiller også krav til fagmiljøet ved studietilbudene: «Fagmiljøet skal ha relevant utdanningsfaglig kompetanse i universitets- og høyskolepedagogikk og -didaktikk, samt kompetanse til å utnytte digital teknologi for å fremme læring. Institusjonen skal legge til rette for oppdatering og utvikling av fagmiljøets kompetanse» (§ 1-12). Forskriften inneholder også særskilte krav til studietilbud på lavere og høyere grads nivå og til doktorgradsutdanninger (§§ 1-13 til 1-15).
2.5 Europeiske rammer og internasjonalt samarbeid
Norsk høyere utdanning inngår i et europeisk utdannings- og kunnskapsområde med felles regelverk som påvirker blant annet gradsstrukturen, kvalitetssikring, personvern, dataforvaltning og i økende grad også utvikling og bruk av KI-systemer. Det internasjonale samarbeidet gir norske institusjoner tilgang til større fagmiljøer, internasjonale samarbeidsprogrammer, forskningsinfrastruktur og digitale ressurser som er viktig for universitetenes og høyskolenes evne til å levere forskning og utdanning på høyt internasjonalt nivå. Samtidig innebærer integrasjonen at endringer i regulering og sikkerhetspolitikk utenfor Norge kan få direkte betydning for sektoren.
2.5.1 Bolognaprosessen
Det europeiske området for høyere utdanning (European Higher Education Area) er et resultat av Bolognaprosessen som ble satt i gang i 1999. Formålet er å oppnå mer sammenliknbare, kompatible og helhetlige høyere utdanningssystemer i Europa. Flere sentrale elementer i norsk høyere utdanning, som bachelor-, master- og ph.d.-strukturen, studiepoengsystemet, kvalifikasjonsrammeverket og standarder for kvalitetssikring, følger av denne samordningen.
2.5.2 Norges kunnskapssamarbeid med EU
For norske høyere utdanningsinstitusjoner er EU hovedarenaen for internasjonalt kunnskapssamarbeid. Norge deltar i Erasmus+ og Det europeiske utdanningsområdet (European Education Area), og i Horisont Europa og Det europeiske forskningsområdet (European Research Area). Dette kobler norsk høyere utdanning tett til europeiske prioriteringer innen innovasjon, bærekraft, kompetanseutvikling, digitalisering og KI. Europeisk samarbeid handler i økende grad også om felles digitale infrastrukturer, læringsressurser og administrative systemer.
De siste årene har EU utviklet et omfattende regelverk som påvirker universiteter og høyskoler direkte eller indirekte. Personvernforordningen, regler om deling og viderebruk av data og KI-forordningen har alle stor betydning for hvordan universiteter, høyskoler og andre aktører i sektoren kan anskaffe, utvikle og bruke KI-systemer. Se også kapittel 4.3.
2.5.3 Internasjonalt samarbeid utenfor EU
Norsk høyere utdanning inngår også i et bredere internasjonalt kunnskapssamarbeid, som inkluderer bilaterale avtaler med viktige samarbeidsland (Kunnskapsdepartementet, 2025a).
Flere internasjonale organisasjoner spiller dessuten en viktig rolle for å løse problemstillinger knyttet til KI. UNESCO arbeider med spørsmål om utdanning, vitenskap, kultur og etisk bruk av teknologi. OECD utvikler analyser og prinsipper for digitalisering, kompetanseutvikling og KI, mens Europarådet har utviklet konvensjoner og overvåkningsmekanismer som kan sikre at utvikling og bruk av KI skjer i tråd med menneskerettigheter, demokrati og rettsstatsprinsipper. Gjennom deltakelse i slike organisasjoner inngår norsk høyere utdanning i internasjonale diskusjoner om hvilke normer, verdier og rammer som bør ligge til grunn for KI-utviklingen.
2.6 Utdanningsfaglige problemstillinger i møte med KI
KI har i løpet av kort tid fått stor innflytelse på høyere utdanning, i Norge som i resten av verden. Studenter og undervisere har tilgang til stadig mer avanserte KI-systemer som kan utføre oppgaver de tidligere bare kunne løse manuelt. Teknologiutviklingen fører også med seg endringer i arbeidslivet studentene skal delta i, og i samfunnslivet ellers.
Generativ KI kan produsere innhold i ulike formater – som tekst eller tale i et naturlig språk, programmeringskode, matematikk, musikk, bilder og film – typisk som resultat av interaksjon med en bruker. Av ulike former for KI er det generativ KI og særlig store språkmodeller som på dette tidspunktet har størst påvirkning på innhold, undervisning, vurdering og læring i høyere utdanning. Til forskjell fra mange utdanningsteknologier har de store språkmodellene påvirket høyere utdanning uten å være utviklet eller anskaffet for formålet (Reich & Dukes, 2024). Kapittel 3 gir en nærmere beskrivelse av KI som teknologi.
KI-systemer kan både erstatte og supplere menneskelig intelligens. Med gjennombruddene innenfor generativ KI har studenter og undervisere fått tilgang på systemer som kan utføre mange av de oppgavene de sitter med, mer eller mindre selvstendig. Utvalget har lagt til grunn to arbeidshypoteser om hva KI-systemer vil være i stand til (se Boks 2.1).
Boks 2.1 Arbeidshypoteser
Teknologiområdet preges av en rask og uforutsigbar utvikling (jf. kap. 3). For å kunne gi langsiktige vurderinger og råd med dette som utgangspunkt, har utvalget funnet det hensiktsmessig å legge til grunn to arbeidshypoteser om hva KI-systemer vil være i stand til:
-
Vi antar at KI-systemer vil være i stand til å løse skriftlige oppgaver like godt eller bedre enn hva som kan forventes av studenter, til tross for at systemene i dag har varierende kapabilitet på tvers av fag og enkeltoppgaver.
-
Vi antar at KI-systemer vil være like godt i stand som de fleste undervisere til å lage undervisningsopplegg, fremstille læringsmateriale, forklare pensum, vurdere besvarelser og gi tilbakemeldinger på arbeid.
I en internasjonal undersøkelse publisert i juni 2026 svarer 88 prosent av studentene verden over at de bruker KI-systemer til læring (Digital Education Council, 2026a). 60 prosent av studentene er bekymret for at medstudentene deres misbruker KI-systemer på måter som gir dem urettferdige fordeler eller undergraver verdien av utdanningen deres. Blant underviserne er andelen som bruker KI-systemer ifølge samme undersøkelse 77 prosent, noe lavere enn blant studentene. Mange undervisere er optimistiske for hva KI kan bidra med, men mer enn én av tre ser på KI som en alvorlig trussel mot menneskelig, intellektuell utvikling (Digital Education Council, 2026a).
Det at vi har KI-systemer som er kapable til å utføre en gitt oppgave, betyr ikke nødvendigvis at det er klokt å overlate oppgaven til KI. Motsatt vei går man glipp av de betydelige mulighetene teknologien gir, om man konsekvent unnlater å ta i bruk KI-systemer. For de fleste oppgaver studenter og undervisere utfører, er det mulig å tenke seg at KI-systemer kan brukes for å støtte oppgaveløsningen på ulike måter, eller automatisere den. På dette analysenivået er ikke høyere utdanning i en særstilling: Aktører i alle sektorer må finne ut hvilke oppgaver som egner seg for bruk av KI-systemer, og hvordan systemene skal brukes.
Det spesielle med utdanning er at læring er det fremste målet. Den viktigste verdien i det studentene gjør i sine studier ligger ikke i produktene de leverer fra seg, som skriftlige, muntlige og praktiske oppgavebesvarelser. Verdien ligger i hva de lærer når de deltar i organisert undervisning og andre læringsaktiviteter, danner fagfellesskap med medstudenter og undervisere, gjennom fordypning og ved å utarbeide oppgavebesvarelser. Deretter skal de demonstrere oppnådd læringsutbytte. Det at læring er hovedformålet, til forskjell fra produktivitet, har implikasjoner for når og hvordan det er klokt å bruke KI. Det er også med på å avgjøre hva slags KI-systemer det er behov for.
Utvalget har sortert de utdanningsfaglige problemstillingene KI reiser i tre overordnede spørsmål:
-
Hva skal studentene lære?
-
Hvordan kan KI-systemer brukes på måter som fremmer og ikke hemmer læring?
-
Hvordan skal studentenes læringsutbytte vurderes?
Utvalget gir sine svar på disse spørsmålene i kapitlene 5 til 7. I det følgende gis noen overordnede beskrivelser og vurderinger av problemstillingene.
2.6.1 Hva studentene skal lære
Et grunnleggende utdanningsfaglig spørsmål er hva studentene skal lære i et samfunn der KI-anvendelsene blir stadig flere og mer utbredt. KI påvirker allerede arbeidslivet, økonomien, kulturen og samfunnet, og vil trolig få enda større betydning i årene som kommer. Teknologien åpner opp nye muligheter for verdiskapning og effektivisering på tvers av sektorer. Også fagene høyere utdanning bygger på, endres av KI-utviklingen.
KI-utviklingen påvirker læringsinnholdet i studietilbud på ulike måter. For det første gir KIs betydning for fagene, arbeidslivet og samfunnet behov for mer kunnskap om teknologien og dens implikasjoner, og for ferdigheter i utvikling og bruk av KI-systemer. For det andre står KI-systemenes kapabiliteter i (komplekse) forhold til menneskelige ferdigheter og kunnskaper – noe som kan påvirke verdien av etablert læringsinnhold. I ytterste konsekvens kan ulike former for kunnskap og ferdigheter bli økonomisk overflødige, dersom KI-systemer brukes til å automatisere oppgaver. Andre ferdigheter og former for kunnskap kan bli mer verdifulle, for eksempel fordi de gjør oss bedre i samspill med KI-systemer eller fordi de møter behov vi ikke kan eller bør overlate til KI-systemer.
Høyere utdanning kan samlet sett bidra til at vi som samfunn drar bedre nytte av mulighetene og løser utfordringene KI reiser, gjennom hva studentene lærer. Svarer ikke sektoren på dette, kan høyere utdanning tape relevans, og fremtidens kompetansebehov blir ikke innfridd.
2.6.2 Hvordan studentene skal lære
Dagens og fremtidens studenter er utfordret med å skulle lære godt, til tross for eller i kraft av at de har tilgang på verktøy som kan utrette mye av det de tidligere måtte utføre selv. Det er spesifikt de generative KI-systemene som er årsak til denne utfordringen. Studenter kan bruke KI-systemer til å oppsummere tekster, forklare fagstoff, gi og få tilbakemeldinger på skriftlig arbeid, løse matematikkoppgaver, skrive programmeringskode og bistå i alle stadier av en skriveprosess. Teknologien kan gjennom dette bidra til mer fleksibel og tilpasset læring, samtidig som den gir risiko for at man hopper over ledd i læringen: Man lærer ikke det man ikke engasjerer seg i eller øver seg på.
Høyere utdanning skal utvikle studentenes selvstendighet, faglige integritet, dømmekraft og evne til å delta i faglige og demokratiske fellesskap. Det skjer ved at studentene arbeider med fagstoffet, formulerer egne resonnementer, gjør feil, møter motstand, reviderer sine egne vurderinger og begrunner sine standpunkter. Om studentene overlater for mye av dette kognitive arbeidet til KI-systemer, kan det svekke deres intellektuelle og faglige utvikling.
2.6.3 Vurdering og dokumentasjon av læringsutbytte
Studentene skal også kunne vise hva de har lært, og universitetene og høyskolene skal kunne vurdere hvilket læringsutbytte studentene har oppnådd. Karakterer, grader og vitnemål gir grunnlag for opptak til videre studier og har betydning for hvilke muligheter studentene får i arbeidslivet. Når studenter kan bruke KI-systemer til å løse oppgaver i vurderingssituasjoner, får man ikke enkelt vurdert hva de kan og vet. Denne utfordringen handler ikke først og fremst om å avdekke bruk av KI-systemer, men om å sikre at vitnemålene gir pålitelig informasjon om studentenes kompetanse. Pålitelig sertifisering og rangering er både i studentenes, institusjonenes, arbeidsgiveres og samfunnets interesse.
2.6.4 Mot en formålstjenlig integrasjon av KI
En vellykket integrasjon av KI i høyere utdanning – med hensyn til hva man skal lære, hvordan man skal lære og hvordan man skal prøve læringen – forutsetter at man har klart for seg hva man ønsker å oppnå med teknologien. Det avgjørende er om bruken av KI-systemer bidrar til å styrke læring, selvstendighet, faglig kvalitet, akademisk integritet og samfunnets tillit til høyere utdanning. Dette kan understøttes av hvilke KI-systemer man tar i bruk, og hvordan de forvaltes: Sektorens utvikling, anskaffelse og forvaltning av KI-systemer bør også underordnes formålene med høyere utdanning. Får man integrert KI i høyere utdanning på en måte som tjener formålene med høyere utdanning, vil KI kunne stå i kunnskapens tjeneste.
2.7 Universitetenes og høyskolenes rolle i en tid med KI
2.7.1 Teknologiens plass i utdanningene
KI kan forstås som del av en bredere digital omstilling som har pågått over flere tiår. Den gjeldende nasjonale digitaliseringsstrategien (Digitaliserings- og forvaltningsdepartementet, 2024) har som overordnet mål å gjøre Norge til verdens mest digitaliserte land innen 2030. Blant de prioriterte områdene er å sikre en fremtidsrettet digital kompetanse og å utnytte mulighetene i KI, data og datadrevet innovasjon. Strategi for digital omstilling i universitets- og høyskolesektoren 2021–2025 (Kunnskapsdepartementet, 2021) fremhever digital teknologi som et virkemiddel for å styrke utdanningskvalitet, utvikle mer fleksible utdanningstilbud og bidra til mer samhandling mellom institusjonene, for at de på den måten bedre kan løse sitt samfunnsoppdrag.
Utdanningsinstitusjonene har over tid tatt i bruk en rekke digitale administrative systemer, plattformer for undervisning og eksamensgjennomføring, digitale bibliotekressurser mv. Institusjonene er i dag omfattende digitale organisasjoner med avhengigheter til egen og sektorfelles infrastruktur og tjenester, og til eksterne tjenesteleverandører.
Sammenlikningen mellom KI og andre digitale teknologier har samtidig begrensninger. Utvalget legger til grunn at KI har større betydning for læring og vurdering, enn hva andre digitale teknologier har. Som en enkel illustrasjon av dette er det, med hensyn til læring og vurdering, mindre forskjell mellom det å skrive på papir og det å skrive på datamaskin, enn det er mellom det å skrive selv og det å få et KI-system til å generere tekst.
2.7.2 Konkurranse og uthuling
Selv om det over tid er blitt fjernere å regne universitetene og høyskolene som kunnskapsmonopoler, har de en høy konsentrasjon av faglig autoritet. Når det gjelder universitetenes og høyskolenes oppgave med å tilby høyere utdanning, er det ingen reelle konkurrenter som ikke selv er universiteter og høyskoler. Den allmenne tilgangen på stadig mer kapabel KI utfordrer dette. Universitetenes og høyskolenes rolle som tilbydere av høyere utdanning står overfor en sammensatt og langsiktig utfordring fra KI.
En del av utfordringen er hva og hvordan man kan lære, med kløktig bruk av KI-systemer og offentlig tilgjengelige kunnskapskilder. Allerede med dagens KI-systemer er det blitt betydelig lettere å designe og følge sitt eget, uformelle utdanningsløp. Kildene til kunnskap har lenge vært tilgjengelige gjennom biblioteker og på internett, men gjennom KI-systemer blir også undervisnings- og veiledningsfunksjoner tilgjengelig utenfor universitetene og høyskolene.
Det man ikke kan få fra dagens KI-systemer, er vitnemål og utdanningsgrader. Men også sertifiseringsfunksjonen til universiteter og høyskoler blir utfordret av KI. Dersom ikke universitetene og høyskolene svarer godt på utfordringen med å vurdere oppnådd læringsutbytte, kan det gå utover tilliten til vitnemålene de utsteder.
KI-systemer kan altså utgjøre konkurrerende tilbydere av undervisnings- og veiledningsfunksjoner, i tillegg til å utfordre universitetenes og høyskolenes sertifiseringsfunksjon. For å bevare sin rolle som tilbydere av høyere utdanning, må universitetene og høyskolene derfor sørge for en merverdi av sine studietilbud – sammenliknet med hva KI-systemer kan gi – samtidig som de skal løse utfordringene KI reiser for utdanningene.
Universitetenes og høyskolenes rolle som tilbydere av høyere utdanning blir også utfordret fra innsiden, i det KI-systemer tas i bruk for å løse institusjonens oppgaver. Dersom institusjonene ikke finner rett balanse i hva og hvor mye de bruker KI-systemer til, kan det ha en uthulingseffekt. Skal universitetene og høyskolenes høyere utdanningstilbud ha reell merverdi over teknologiske løsninger, må de være noe mer enn en innpakning av teknologiske løsninger. Å sikre dette for universitetene og høyskolene, kan sees som et spesialtilfelle av å sikre menneskets plass i møte med KI (jf. kap. 4). I tråd med dette er det uheldig om rollen til ansatte på universiteter og høyskoler i for stor grad begrenses til å betjene teknologiske løsninger, for eksempel til å verifisere innhold og beslutninger fra KI-systemer.
Samtidig kan ikke universitetene og høyskolene gjennomgående avvise bruk av KI-systemer til de oppgavene de er gitt. KI gir universiteter og høyskoler muligheter til å heve kvaliteten på studietilbudene og til å effektivisere driften av utdanningene. Både fagene høyere utdanning bygger på, arbeidslivet og samfunnet blir over tid sterkere preget av KI. Målene om faglig kvalitet og samfunns- og arbeidslivsrelevans tilsier derfor også at teknologien må ha en rolle i utdanningene.
Universiteter og høyskoler er i lys av disse vurderingene nødt til å finne egnede bruksområder for teknologien og løse utfordringene den skaper. Overordnet sett må de sørge for at KI-systemer står i den menneskelige kunnskapens tjeneste, heller enn motsatt.
2.7.3 Samfunnsmessige utviklingstrekk
KIs betydning for høyere utdanning og universitetenes og høyskolenes rolle må også sees i en bredere kontekst av samfunnsmessige utviklingstrekk. Det er verdt å trekke frem den demografiske utviklingen, klimaendringer og bærekraftsutfordringer, endringer i informasjonslandskapet og en mer spent geopolitikk.
De demografiske endringene innebærer at vi vil ha flere eldre og færre folk i arbeidsfør alder. Dette preger høyere utdanning på mange måter, blant annet gjennom sterkere krav til prioritering mellom fagområder og utdanninger. Videre, dersom vi skal bevare velferdsnivået i denne konteksten, må produktiviteten øke, noe KI-systemer er forventet å kunne bidra til (jf. kap. 5). Høyere utdanning har da en rolle i å legge til rette for at vi som samfunn kan dra nytte av mulighetene KI gir for større produktivitet, gjennom hva slags læringsutbytte studentene kommer ut med.
Universitetene og høyskolene har som lovfestet formål å bidra til miljømessig, sosial og økonomisk bærekraft. KI kan bidra til å møte utfordringer knyttet til blant annet klimaendringer, helse, energi, effektiv ressursforvaltning og produktivitet (Vinuesa et al., 2020). Samtidig fører teknologien med seg et omfattende energiforbruk og utfordringer knyttet til klimautslipp, lokal forurensning og sosial skjevfordeling (jf. kap. 4.2.5). I tillegg til selv å bidra til ansvarlig utvikling og bruk av teknologien, har høyere utdanning en viktig rolle i å utvikle kunnskap om konsekvensene den har for mennesker, samfunn og miljø.
En viktig side av universitetenes og høyskolenes samfunnsoppdrag er å bidra til demokratisk deltakelse og utviklingen av en opplyst offentlighet. KI kan føre nye forstyrrelser inn i den offentlige samtalen i form av villet desinformasjon eller som resultat av polariserende mekanismer i systemene (jf. kap. 4.2.8). I møte med slike utfordringer er ferdigheter som kritisk tenkning, kildekritikk, vitenskapelig metode og evne til selvstendig refleksjon særlig viktige.
Inneværende tiår er preget av økende spenning mellom globale stormakter, flere mellomstatlige konflikter og et tydelig press mot den internasjonale rettsorden. Kampen om teknologisk hegemoni inngår i dette bildet og aksentueres ved at utviklingen av de mest avanserte systemene er konsentrert hos et begrenset antall stater og teknologiselskaper. Det kan skape nye avhengighetsforhold (jf. kap. 4.2.9), forsterke eksisterende forskjeller og gi økt konfliktnivå. Gjennom internasjonalt kunnskapssamarbeid, utveksling av perspektiver og utvikling av felles løsninger kan høyere utdanning bidra til dialog, gjensidig forståelse og felles normer for ansvarlig teknologiutvikling.
3 Kunstig intelligente systemer
3.1 Innledning
Dette kapittelet redegjør kort for kunstig intelligens (KI) som teknologi- og forskningsfelt. I kapittel 3.2 gis det et kort historisk riss, etterfulgt av definisjoner av KI i kapittel 3.3. I kapittel 3.4 presenteres ulike former for KI, fulgt av en nærmere redegjørelse for hvordan KI-systemer er bygget opp og en beskrivelse av ulike lag av teknologier som inngår i et kunstig intelligent system – teknologistabelen. Kapittelet avrundes med en omtale av trekk ved utviklingen av teknologi- og forskningsfeltet som utvalget mener er viktige for den videre diskusjonen i utredningen.
3.2 Bakgrunn
KI tok for alvor plass i allmennhetens bevissthet i november 2022, med lanseringen av ChatGPT. Det ble da raskt klart at store språkmodeller kunne få betydelige konsekvenser for utdanning og arbeidsliv. For eksempel viser Studiebarometeret 2025 at andelen studenter som ikke bruker denne typen KI-systemer som en del av studiene er mindre enn 10 prosent.
Språkmodellene ble etter hvert utvidet til grunnmodeller (foundation models), som har de samme språklige kapabilitetene, men i stedet for å være begrenset til bare språk, fungerer på flere datatyper og -modaliteter. Selv om det er språk- og grunnmodeller som har fått størst plass i samfunnsdebatten i første halvdel av 2020-tallet, har kunstig intelligens en rik historie som fagfelt, og KI-teknologi er ikke begrenset til generativ eller språkbasert funksjonalitet.
Det som gjerne regnes som det tidligste arbeidet i fagfeltet er fra 1943, av McCulloch og Pitts (Russel & Norvig, 2022). Betegnelsen «kunstig intelligens» stammer fra et seminar ved Dartmouth College i 1956, hvor ti forskere var samlet i to måneder for å utforske utvikling av intelligente maskiner. Etter en periode med stor interesse for fagfeltet og betydelig finansiering, førte manglende resultater til at finansieringen tørket opp, og vi gikk inn i en «KI-vinter» på 1970-tallet. Kunstig intelligens fikk et oppsving igjen på 1980-tallet, denne gang med regelbaserte systemer (se kap. 3.4). Nok en gang overgikk forventningene hva feltet klarte å levere, og en ny KI-vinter satte inn på slutten av 1980-tallet og videre inn på 1990-tallet.
Grunnteknikken for å trene nevrale nettverk, tilbakepropagering, ble etablert på 1970- og 1980-tallet, men gjennom 1990- og 2000-tallet var nevrale nettverk fremdeles en marginal retning innenfor KI. Gjennombruddet kom tidlig på 2010-tallet, da metodeutvikling, kraftigere maskinvare, grafikkort og store datamengder samlet gjorde det mulig å trene dagens nevrale nettverk. I 2012 viste nevrale nettverk seg som klart overlegne tradisjonelle metoder for storskala bildeklassifisering (LeCun et al., 2015). Siden da har teknikken hatt fremgang på andre datatyper, som språk, og gitt fremgang innen flere anvendelsesområder, som medisinsk diagnose og værprognoser.
3.3 Hva er et kunstig intelligent system?
En tilnærming til å definere kunstig intelligens er å beskrive hva KI-systemer kan gjøre. For eksempel beskriver UNESCO maskiner basert på KI som «potensielt i stand til å imitere, eller til og med overgå, menneskelige kognitive kapasiteter, inkludert sansing, språklig interaksjon, resonnering og analyse, problemløsing og endog kreativitet. Videre, slike ‘intelligente maskiner’ kan fremvise menneskelignende evne til å lære med mekanismer som selv-relasjon og selvkorreksjon, basert på algoritmer som utgjør ‘maskinlæring’ eller til og med ‘dyplæring’ som benytter ‘nevrale nettverk’ som etterligner virkemåten til den menneskelige hjernen» (COMEST, 2019).
En annen tilnærming til å definere kunstig intelligens er å vektlegge hvordan KI-systemer fungerer, som for eksempel i KI-forordningen (se Boks 3.1).
Boks 3.1 Definisjon av KI i KI-forordningen
«Et sentralt kjennetegn ved KI-systemer er deres evne til å trekke slutninger. Med denne evnen til å trekke slutninger menes prosessen med å generere utdata, for eksempel prediksjoner, innhold, anbefalinger eller beslutninger, som kan påvirke fysiske og virtuelle miljøer […] Blant de teknikkene som muliggjør utledning under oppbyggingen av et KI-system, er maskinlæringstilnærminger som på grunnlag av data lærer hvordan bestemte mål best kan nås, og logikk- og kunnskapsbaserte tilnærminger som trekker slutninger på grunnlag av kodet kunnskap eller symbolsk representasjon av oppgaven som skal løses»
Kilde: KI-forordningen, avsnitt 12
I den nasjonale strategien for KI fra 2020 er KI-systemer forstått som systemer som «utfører handlinger, fysisk eller digitalt, basert på tolkning og behandling av strukturerte eller ustrukturerte data, i den hensikt å oppnå et gitt mål. Enkelte KI-systemer kan også tilpasse seg gjennom å analysere og ta hensyn til hvordan tidligere handlinger har påvirket omgivelsene» (Kommunal- og moderniseringsdepartementet, 2020).
3.4 Ulike former for kunstig intelligens
Det finnes mange ulike typer KI-systemer, og mange måter å dele dem inn på. Vi kan blant annet skille mellom regelstyrte og datadrevne KI-systemer, og mellom spesialisert og allmenn KI. Vi kan også skille mellom prediktive og generative KI-systemer, og mellom assisterende og agentiske systemer. Skillelinjene er ikke krystallklare, men ved å trekke dem kan vi få en bedre forståelse av hvilket mangfold av KI-systemer som finnes.
3.4.1 Regelstyrt kontra datadrevet
Innenfor fagfeltet kunstig intelligens skilles det grovt mellom regelbaserte modeller og datadrevne modeller. Regelbaserte modeller benyttes eksempelvis i ekspertsystemer, hvor atferden til dataprogrammet bestemmes av forhåndsdefinerte regler. Ekspertsystemer brukes ofte på spesialiserte fagområder som er regelbundne og forutsigbare, som noen typer medisinsk diagnostikk eller oljeboring (Rossen et al., 2024), eller detaljerte, styrte juridiske områder (Ashley, 2017). KI-utviklingen har gradvis blitt dominert av datadrevne modeller, hvor reglene ikke er forhåndsdefinerte, men læres gjennom en databasert optimaliseringsprosess som identifiserer statistiske mønstre. Dette kalles maskinlæring. Eksempler på datadrevne modeller er store språkmodeller og ansiktsgjenkjenningsmodeller.
Regelstyrte og datadrevne modeller er ikke gjensidig utelukkende kategorier. Beslutningstrær har lenge vært i utstrakt bruk, og disse lager eksplisitte regler gjennom trening på data. Det utvikles også hybride modeller som kombinerer eksplisitte regler med databasert optimalisering (Garcez & Lamb, 2023). Nyere forskning innen kognitiv vitenskap og kunstig intelligens har vist at systemer som integrerer maskinlæring og automatisert resonnering har potensial innen flere områder, inkludert beregningsbiologi, feildiagnostikk, opplæring og vurdering i simulatorer, og programvareverifikasjon (Besold et al., 2017).
Moderne nevrale nettverk er datastrukturer bestående av flere lag, også omtalt som dype nevrale nettverk. Treningen av dype nevrale nettverk omtales kollektivt som dyplæring, og deles inn i følgende tre regimer: Veiledet læring, hvor riktig svar er eksplisitt tilgjengelig i dataene, som ved diagnostikk. Uveiledet læring, hvor riktig svar ikke er angitt i dataene og hensikten er å finne mønstre og unntak, som i avviksdeteksjon. Forsterkende læring, hvor modellen selv innhenter treningsdata og dens atferd derfor avgjør hva den trenes på, som i sjakkmodeller. Dype nevrale nettverk trenger generelt store datamengder for å bli funksjonelle (Tidemann, 2023).
3.4.2 Allmenn kontra spesialisert
En KI-modell til allmenne formål er ikke trent opp for å løse én type oppgave godt, men har mange ulike bruksområder. Store språkmodeller og grunnmodeller er eksempler på dette. Systemer som bygger på slike modeller, som samtaleroboter og agentiske systemer, har ikke klart forhåndsdefinerte bruksområder, og kan regnes som KI-systemer til allmenne formål (Bengio et al., 2026).
Spesialiserte KI-systemer er utviklet for bestemte formål eller bruksområder, og er trent på data og metoder direkte knyttet til enkeltdomener. Eksempler på spesialiserte KI-systemer er bildemodeller for klassifisering av røntgenbilder eller modeller for transkribering av tale til tekst. Spesialiserte KI-systemer fungerer bare innenfor sitt domene, mens allmenne KI-systemer kan utføre et bredt spekter av oppgaver. Forskjellen på KI-modeller til allmenne formål og spesialiserte KI-systemer, med de ulike formålene de kan tjene, er avgjørende for hvordan systemene er regulert i KI-forordningen, jf. kapittel 4.3.2.
3.4.3 Prediktiv kontra generativ
Prediktiv KI benytter maskinlæring for å analysere mønstre i store datasett for å gi en forutsigelse av et eller annet slag, f.eks. om sannsynligheten for en fremtidig hendelse eller for at et gitt objekt tilhører en gitt kategori (Pratschke, 2024). Prediktive KI-systemer kan brukes til mange ulike formål, for eksempel til å lage værprognoser, til kredittvurdering innenfor finans, til klassifisering av bilder eller til å identifisere søppelpost. De benyttes i anbefalingssystemer på sosiale medier, og i utdanningssammenheng til tilpasning av læringsinnhold, hjelp til valg av fag, anbefaling av læringsressurser, gruppesammensetninger og andre typer persontilpassede digitale tjenester (NOU 2023: 19).
Generativ KI skaper nytt innhold, basert på data modellen er trent på og instruksjoner fra brukeren (Lorenz et al., 2023). Generative KI-systemer kan generere nye instanser fra en hvilken som helst datatype, inkludert tekst, tale, musikk, illustrasjoner, bilder, video og programkode. Et viktig særtrekk ved KI-generert innhold er at det kan være vanskelig, og i prinsippet umulig, å skille det fra innhold skapt av mennesker.
3.4.4 Assisterende kontra agentisk
Assisterende KI-systemer, som de prediktive systemene omtalt ovenfor, gir resultater som direkte respons på instrukser, og handler ikke på eget initiativ. Det samme gjelder en samtalerobot isolert sett. Agentiske KI-systemer handler autonomt, og skiller seg fra andre KI-systemer ved at de kan operere uten oppsyn fra mennesker. KI-agenter er laget for å forfølge mål, ofte spesifisert av brukere i naturlig språk.
En agent er noen eller noe som handler, og en programvare-agent skal kunne handle autonomt, oppfatte omgivelsene sine, tilpasse seg endring, bestå over tid, og den må kunne skape og forfølge mål (Russel & Norvig, 2022). KI-agenter kan gis tilgang til internett, samt ressurser som databaser og intranett, og gis adgang til å håndtere filer og kjøre programkode på datamaskiner (Bengio et al., 2026). Et multiagentsystem består av flere agenter som samhandler for å nå egne eller felles mål (Wooldridge, 2009).
3.5 Hvordan er et kunstig intelligent system bygget opp?
Et viktig element i utviklingen av KI-systemer er hvordan data blir representert på en måte som gjør at KI-modellen kan utføre beregninger på dem. Det er mange ulike typer representasjonsformer, men med gjennombruddet av dyplæring har vektor-representasjoner (embeddings) blitt sentrale (Mikolov et al., 2013)2.
Et nevralt nettverk kan forstås som et stort sett med beregningsenheter satt sammen på en bestemt måte. Måten nettverket er satt sammen på kaller man for nettverkets arkitektur, og angår hvilke beregninger som gjøres i hvilken rekkefølge. Et utvalg viktige nettverksarkitekturer er kort beskrevet i Boks 3.2.
Boks 3.2 Nettverksarkitekturer
Dagens store språkmodeller er laget med transformer-arkitekturen (Vaswani et al., 2017), som er spesielt egnet for bearbeiding av naturlig språk. GPT, som i ChatGPT, er en transformer-modell. En viktig egenskap ved denne arkitekturen er at den benytter oppmerksomhetsmekanismer for å modellere hvordan meningen i en tekst er fordelt over tekstens bestanddeler.
I 2012 kom en kraftig forbedring i utviklingen av maskinsyn, med konvolusjonelle nevrale nettverk (basert på LeCun et al., 1989; LeCun et al., 1998). Denne arkitekturen gjorde det mulig å redusere mengden treningsdata som skal til for at et program skal kunne klassifisere eller identifisere objekter i bilder, og benyttes for eksempel til ansiktsgjenkjenning eller i analyse av røntgenbilder.
Autokodere (Hinton & Salakhutdinov, 2006) er utformet for å lære seg å effektivt representere datasett, og er mye brukt for å finne underliggende mønstre eller uregelmessigheter i data – som for å avdekke økonomisk svindel, i datasikkerhet og i medisinsk diagnostikk.
En annen arkitektur som også benyttes til blant annet bildegenerering, er diffusjonsmodeller (Ho et al., 2020; Sohl-Dickstein et al., 2015). Disse modellene er trent på store mengder bilder som gradvis er tilført mer og mer støy, til bildene er helt ødelagt. Den ferdig trente modellen jobber motsatt vei – den starter med ren støy som fjernes den gradvis i mange omganger frem til man står igjen med et ferdig bilde.
Størrelsen eller kompleksiteten til et nevralt nettverk måles som regel i antall parametre. Parametre i maskinlæringsmodeller er numeriske verdier som optimaliseres for at modellen skal oppnå målet sitt, omtalt som «trening». Parametrene avgjør modellens tolkning av inndata og oppførsel. Jo flere parametre en modell har, jo mer treningsdata og regnekraft kreves generelt for å optimalisere parametrene. Empirisk klarer modeller med mange parametre (i kortform omtalt som «store modeller») å utføre flere oppgaver og å utføre de samme oppgavene med et bedre resultat enn modeller med få parametre (Maslej et al., 2025). For eksempel er kvaliteten på samtaleroboter som benytter GPT-4, med sine anslagsvis 1,8 billioner parametre, typisk bedre enn de som benytter GPT-3 med sine 175 milliarder parametere. Sammenhengen mellom antall parametre og ytelse er likevel ikke entydig. Mer effektive arkitekturer og treningsmetoder har gjort at modeller med få parametre i dag løser oppgaver som tidligere krevde svært mange parametre (f.eks. DeepSeek).
Det kreves betydelige ressurser for å utvikle store språk- og grunnmodeller, især regnekraft og datamengder. Det er derfor et begrenset antall aktører som har kapasitet til å lage de mest kapable modellene. I sin oversikt over det de kaller fremtredende (notable) KI-modeller, viser The AI Index 2026 Annual Report at det er en klar overvekt av modeller fra USA og Kina, og nær ingen konkurransedyktige fra Europa (Sajadieh et al., 2026). Det er dermed en betydelig konsentrasjon av teknologisk makt, både i form av at det er få selskaper som utvikler de mest kapable modellene, og i form av at det er få stater som har jurisdiksjon over modellutviklerne. Denne maktkonsentrasjonen er ytterligere forsterket av maktkonsentrasjon også i andre deler av teknologistabelen (jf. kap. 3.6). Sammen med at det er blitt økt geopolitisk spenning i verden, har dette bidratt til å aktualisere problemstillinger knyttet til digital suverenitet, jf. kap. 8.5.1.
De store språkmodellene er trent på store mengder tekstdata fra bl.a. internett, gjennom uveiledet læring. Etter en slik grunntrening kan modellen ettertrenes og finjusteres (oppdatering av modellens parametre), gjerne ved hjelp av tilbakemeldinger fra mennesker, ved trening på et mindre utvalg av spesialiserte tekster, eller ved sammenlikning med eksakte svar for oppgaver i for eksempel matematikk. Dette er illustrert i Figur 3.1 (Bengio et al., 2026):
-
Datainnsamling og -kuratering: Før språkmodellen trenes, samles det inn store mengder rådata som renses, kurateres og standardiseres slik at de kan formateres til bruk i trening.
-
Grunntrening: I dette første steget i treningen, hvor datasettet fra forrige steg benyttes, eksponeres modellene for millioner eller milliarder av eksempler av innhold som tekst eller bilder. Modellene lærer seg mønstre i datasettet, abstrakte egenskaper ved dataene og hvordan de henger sammen. Denne prosessen krever mye regnekraft, og tar uker eller måneder å gjennomføre. Grunntreningen kan også omtales som forhåndstrening.
-
Ettertrening og finjustering: KI-modellen som er utviklet under grunntreningen, kan optimaliseres for spesifikke bruksområder gjennom finjustering, eller videreutvikles for lengre resonnementer eller multiagent-bruk gjennom forsterkende læring. Overvåket finjustering ved hjelp av mindre, annoterte datasett kan forbedre modellens ytelse innenfor bestemte områder, for eksempel norsk språk eller norske lovtekster. Ettertrening med forsterkende læring har blitt mer viktig og krever vel så mye regnekapasitet som grunntreningen og betydelig manuelt arbeid med dataklargjøring og merking.
-
Systemintegrasjon: Utviklere setter sammen en eller flere KI-modeller med andre komponenter for å skape et anvendelig KI-system.
-
Idriftsetting: KI-systemet gjøres tilgjengelig for bruk, for en virksomhets eller organisasjons interne brukere, for eksterne kunder, eller for allmennheten.
-
Overvåking og oppdatering: Etter at KI-systemet er tatt i bruk, kan utviklere samle data fra bruk og tilbakemelding fra brukere, og benytte dette til å gjøre iterative forbedringer på systemet. Forbedringene gjøres ved å oppdatere systemintegrasjon, ofte gjennom kontinuerlig fintrening eller kontrollerte treningsforløp på oppdaterte treningsdata.
Det er viktig å påpeke at de siste tre elementene involverer testing, verifisering og validering. Før systemet tas i bruk, og fortløpende etterpå, undersøkes det om modellen og systemet fungerer slik de er spesifisert (verifisering), og om de er egnet for det bruksområdet de er tiltenkt (validering). Dette skjer blant annet gjennom standardiserte tester, systematisk leting etter svakheter og utprøving med brukere. Testresultater gir imidlertid ikke alltid et pålitelig bilde av hvordan systemet oppfører seg i praktisk bruk.
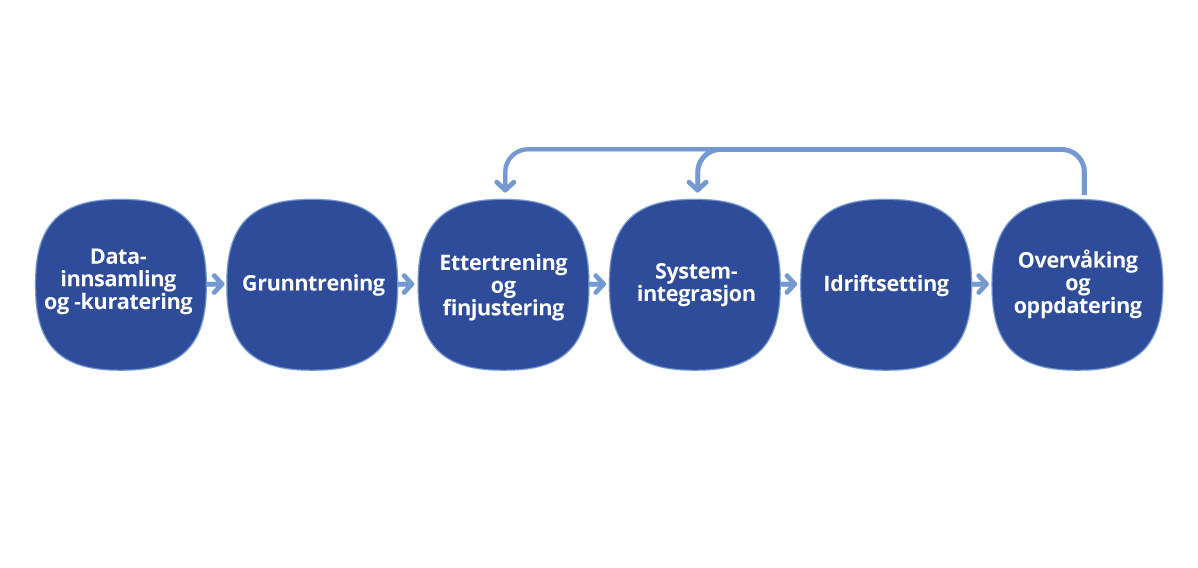
Figur 3.1 Trinn i utviklingen av en stor språkmodell
Utvalgets oversettelse og reproduksjon av figur fra Bengio m.fl.
Kilde: Bengio et al. (2026)
3.6 Teknologistabel for generativ kunstig intelligens
En teknologistabel er et sett av maskin- og programvarer som samlet utgjør en plattform som et dataprogram trenger for å fungere. Komponentene i en teknologistabel vil typisk være utviklet av ulike leverandører, uavhengig av hverandre. Overordnet og forenklet fremstilt vil en teknologistabel for generativ KI inneholde tre lag, vist i Figur 3.2: infrastruktur, modell og applikasjon.
-
Infrastruktur: Laget består av maskinvare for databehandling og -lagring, inkludert prosessorer, minnebrikker og datanettverk, som typisk blir gjort tilgjengelig på en sky-plattform som Microsoft Azure, Amazon Web Services eller Google Cloud.
-
Modell: I dette laget finner vi grunnmodellene, de store nevrale nettverkene trent på store datamengder i den fasen som kalles forhåndstrening. Grunnmodellene er generelle modeller, som så forbedres eller spesialtilpasses gjennom ettertrening. Eksempler på grunnmodeller er store språkmodeller som GPT og Llama, eller modeller for bildegenerering som Stable Diffusion.
-
Applikasjon: I dette øverste laget i teknologistabelen er de programmene og tjenestene som brukerne benytter seg av. Applikasjonslaget er det som forbinder brukerne med de store og komplekse KI-modellene. Eksempler på applikasjoner er velkjente samtaleroboter som ChatGPT eller Claude, agentiske systemer som OpenClaw, Claude Code og Codex, samtaleroboter for kundestøtte som IKEAs Billie, eller bedriftsinterne systemer til bruk i for eksempel kundeanalyser.
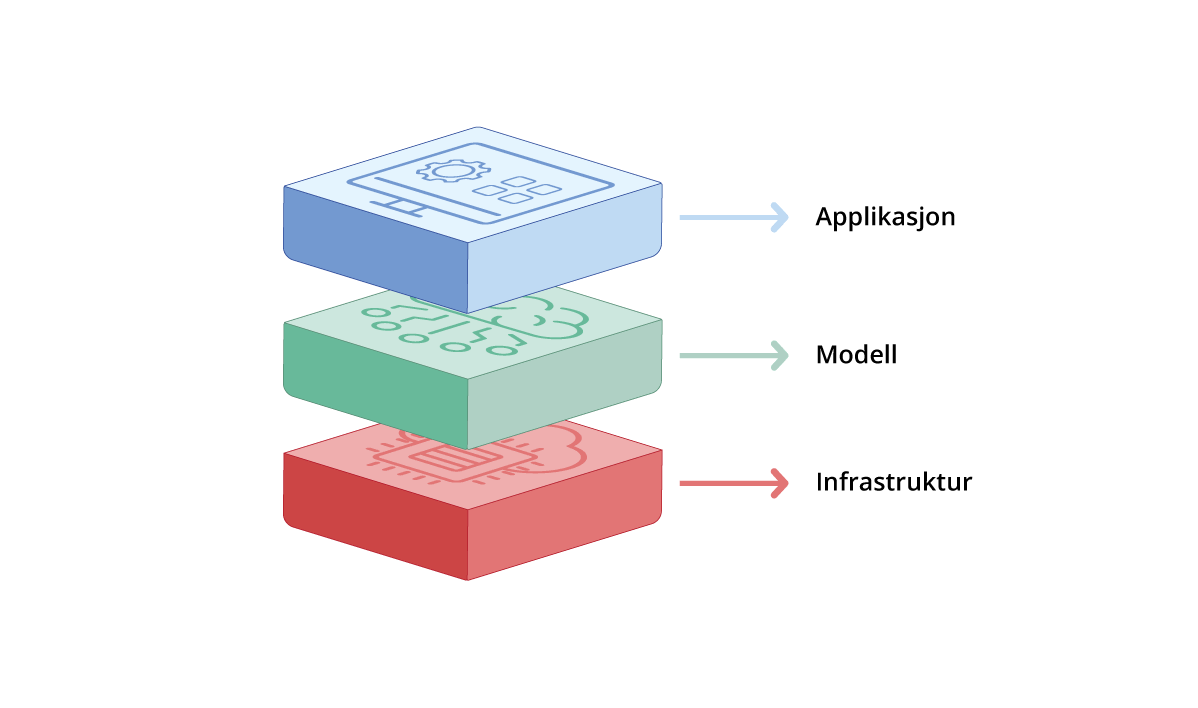
Figur 3.2 Forenklet teknologistabel for KI
Figuren viser en overordnet og forenklet teknologistabel. Det finnes mange ulike varianter, avhengig av hvilke typer KI-arbeid man gjør, ofte med flere lag enn de tre som er vist her. For eksempel kan man dele infrastrukturlaget i maskinvare for regnekraft og skyplattformer, eller modell-laget i grunnmodeller og finjusterte modeller, og man kan legge til et lag eller to for data og dataforvaltning.
3.7 Utviklingstrekk
Hva kan et kunstig intelligent system gjøre? Den tekniske utviklingen går raskt, og det å identifisere rekkevidden av KI-kapabiliteter er et arbeid som krever kontinuerlig oppdatering. OECD har laget et utkast til et rammeverk for å måle hva kunstig intelligens og robotikk får til, og sammenligne disse med menneskelige ferdigheter (OECD, 2025c). Metodikken har blitt utviklet for å gi beslutningstakere et evidensbasert verktøy for å vurdere utviklingen innen KI på en måte som er lett å forstå for personer uten teknisk bakgrunn. Rammeverket vil oppdateres systematisk, slik at man kan følge med på utviklingen i KI-kapabiliteter.
Rammeverket består av ni indikatorer som dekker et spenn av menneskelige evner, hvor hver enkelt indikator beskriver utviklingen av KI-systemer mot full ekvivalens med menneskelige ferdigheter. Indikatorene er språk; sosial interaksjon; problemløsing; kreativitet; metakognisjon og kritisk tenkning; kunnskap, læring og hukommelse; synsevne; fysisk håndtering av gjenstander; og robotikk-intelligens. Indikatorene vurderes på en skala fra en til fem, hvor de evnene som er mest utfordrende for et KI-system har høyest verdi. I den foreløpige vurderingen kommer alle kategoriene med en verdi på to eller tre. For eksempel er indikatoren metakognisjon og kritisk tenkning vurdert til å være på nivå to: «KI-systemer overvåker sin egen forståelse og justerer sine tilnærminger tilsvarende. De arbeider med kjent informasjon som kan inneholde flertydighet, noe som krever avpasset sikkerhet og informerte gjetninger. De kan håndtere delvis ufullstendig informasjon ved å skille mellom hva de vet og hva de ikke vet» (OECD, 2025c, s. 13).
Et tydelig utviklingstrekk er at de generative KI-systemene blir i stand til å gjøre stadig mer, og med bedre kvalitet, i kraft av tekniske innovasjoner og større tilgang på data og regnekraft. Figur 3.3 viser hvordan de mest fremtredende grunnmodellene over tid har prestert bedre på en bred kapabilitetsindeks, Epoch Capabilities Index.
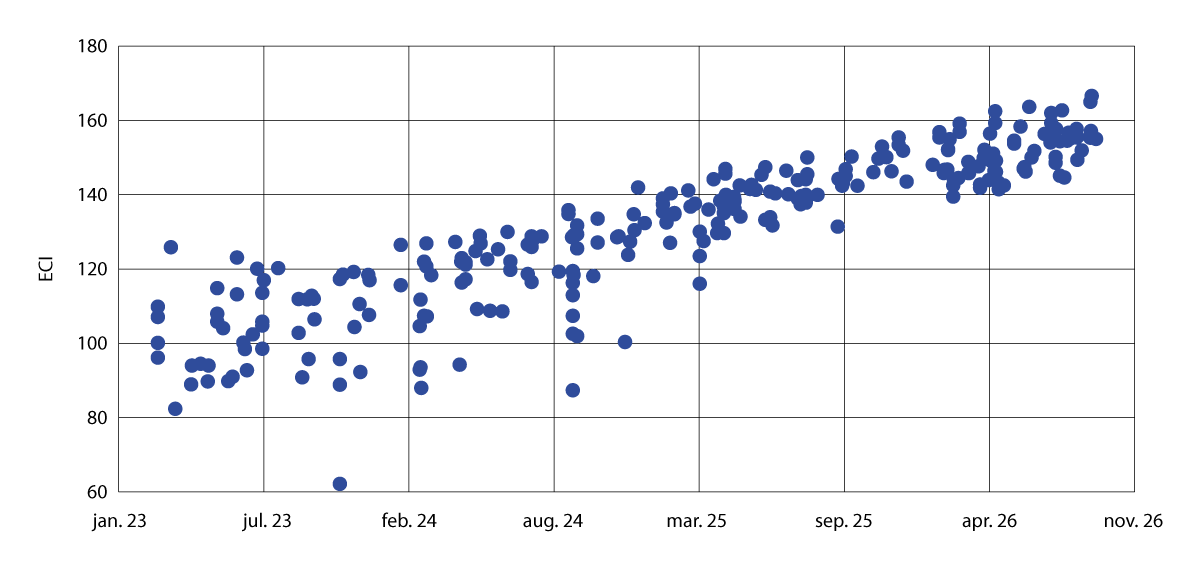
Figur 3.3 Indeksert kapabilitetsutvikling for fremtredende grunnmodeller, 2023–2026
Indeksen består av over 50 uavhengige målinger, blant annet innenfor matematikk, programmering, faktakunnskap, vitenskapelig kunnskap, spill, læringsevne og evne til å selvstendig utføre økonomisk verdifulle arbeidsoppgaver. Til forskjell fra OECDs rammeverk kombinerer denne indeksen de mange målingene i én «generell kapabilitet»-verdi. En høyere verdi betyr at modellen er mer kapabel.
Kilde: Tilpasset fra Epoch AI (2026c). Lisens: CC-BY.
Rapporten The International AI Safety Report, utarbeidet av ledende KI-forskere, slår fast at KI-systemer til allmenne formål kan utføre et stort utvalg av godt avgrensede oppgaver med høy grad av kyndighet (Bengio et al., 2026), jf. kap. 3.4.2. Dette inkluderer å kunne føre dialog på mange språk flytende, lage kode for å utføre avgrensede programmeringsoppgaver, lage realistiske bilder og korte videoer, og å kunne løse matematiske og vitenskapelige problemer på høyere grads nivå. Men de påpeker også at fronten av KI-utviklingen er ujevn; at det er mange oppgaver KI-systemer ikke løser på en god måte. Eksempler på dette er at de forsetter å dikte opp ting og saksforhold (hallusinering) eller at de fremdeles ikke er godt nok integrert med robotikk-komponenter til å utføre enkle husholdningsoppgaver.
Begrepet the jagged frontier of AI ability ble introdusert av Dell’Acqua og kollegaer i 2023 (Dell’Acqua et al., 2023) for å beskrive fenomenet at KI-systemer kan gjøre noe arbeid utrolig godt og annet utrolig dårlig, på måter som ikke passer godt inn i vår menneskelige intuisjon om hva som er enkelt og hva som er vanskelig. Figur 3.4 illustrerer denne ujevne utviklingsfronten, hvor utvikling over tid skisseres i tre stadier og de lyserøde områdene representerer KI-kapabilitet sammenlignet med menneskelig evne, vist i blått.
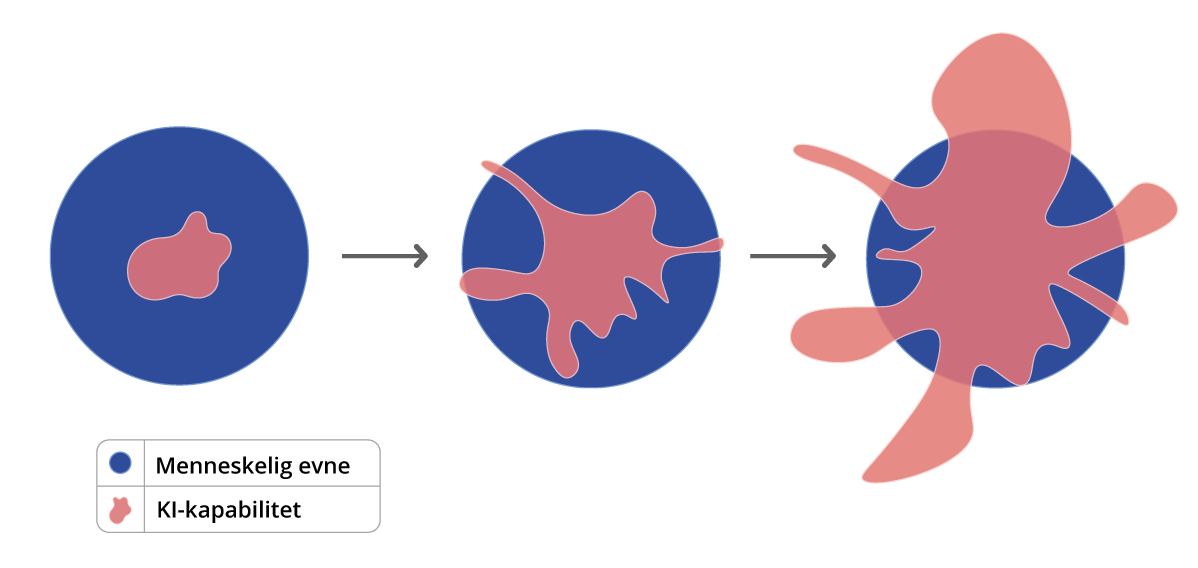
Figur 3.4 Den ujevne utviklingsfronten av KI-systemer
Utvalgets reproduksjon av Pueyo (2025)
Kilde: (Pueyo, 2025)
Toneangivende fagmiljøer i næringslivet, som Anthropic, OpenAI og Google DeepMind, signaliserer at de arbeider aktivt med systemer som kan forbedre seg selv. Ved lanseringen av en ny versjon av det agentiske KI-systemet Codex i februar 2026, uttalte OpenAI at dette bidro vesentlig til GPTs egen utvikling. KI-systemer som er gode på å programmere og på KI-relatert forskning, kan benyttes til å utvikle neste generasjons modeller. Dette kalles rekursiv selvforbedring, og kan føre til en markert økning i utviklingshastighet (Kwa et al., 2025). Det er likevel langt fra sikkert hvor stor betydning rekursiv selvforbedring vil ha. En mulighet er at man utvikler kunstig superintelligens (Bostrom, 2014), KI-systemer som i betydelig grad overgår menneskers kognitive prestasjoner på praktisk talt alle relevante områder (se f.eks. Morris et al., 2025). Men en slik utvikling kan begrenses av tilgang til data, regnekraft eller modellenes innovasjonsevne.
Globalt brukes det enorme summer på kunstig intelligens. Figur 3.5, hentet fra The 2026 AI Index Report, viser utviklingen i private investeringer i KI globalt for perioden 2013–25 (Sajadieh et al., 2026). Av totalen på 344,7 milliarder amerikanske dollar i 2025 utgjorde investeringer i selskaper som lager generativ KI 170,9 milliarder dollar, noe som er en økning på over 200 prosent fra 2024. Merk at oversikten ikke inneholder statlige investeringer. Som et eksempel estimerer man i rapporten at Kina investerte 184 milliarder amerikanske dollar i KI-selskaper i perioden mellom 2000 og 2023, gjennom statlige investeringsfond (Sajadieh et al., 2026, s. 184).
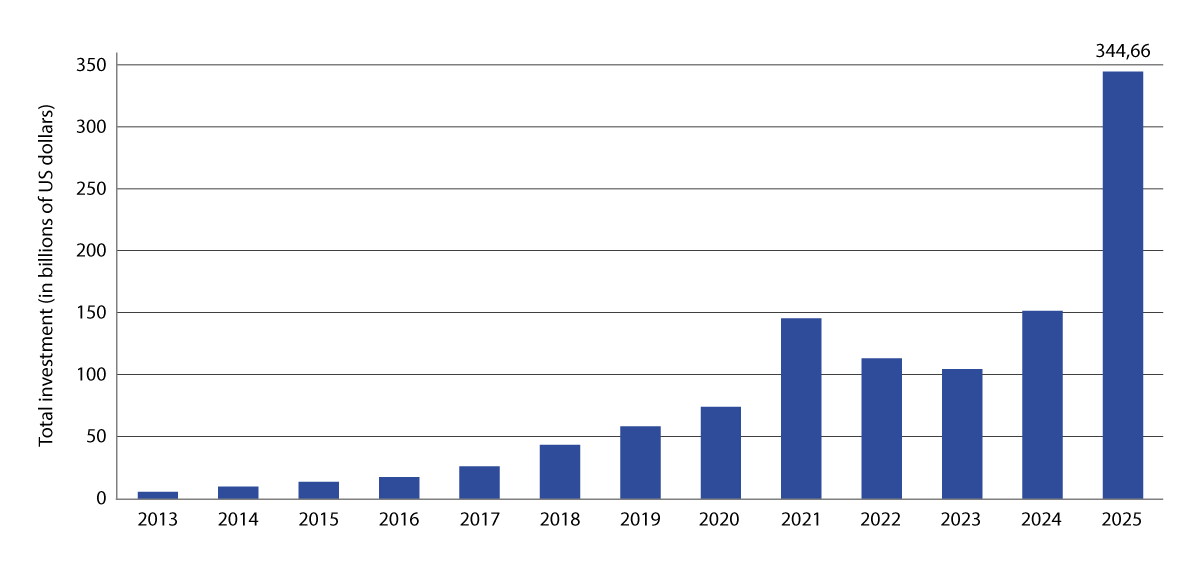
Figur 3.5 Private investeringer i KI globalt, 2013–25
Diagrammet viser beløp i milliarder amerikanske dollar.
Kilde: The 2026 AI Index Report (Sajadieh et al., 2026)
Det er en betydelig geografisk konsentrasjon av kapital, kompetanse og datasentre med de mest avanserte databrikkene, som er helt sentrale innsatsfaktorer i utvikling av de fremtredende grunnmodellene. Utfordringer knyttet til dette diskuteres i kapittel 8 om forvaltning av KI-systemer.
I flere tiår har man forsket på KI både i akademia og i næringslivet. Men etter at dyplæring har blitt den ledende teknologien, har næringslivet i økende grad dominert forskningsfeltet. Dette er illustrert i Figur 3.6, som viser hvilken sektor forskningsgrupper som utvikler fremtredende KI-systemer tilhører.
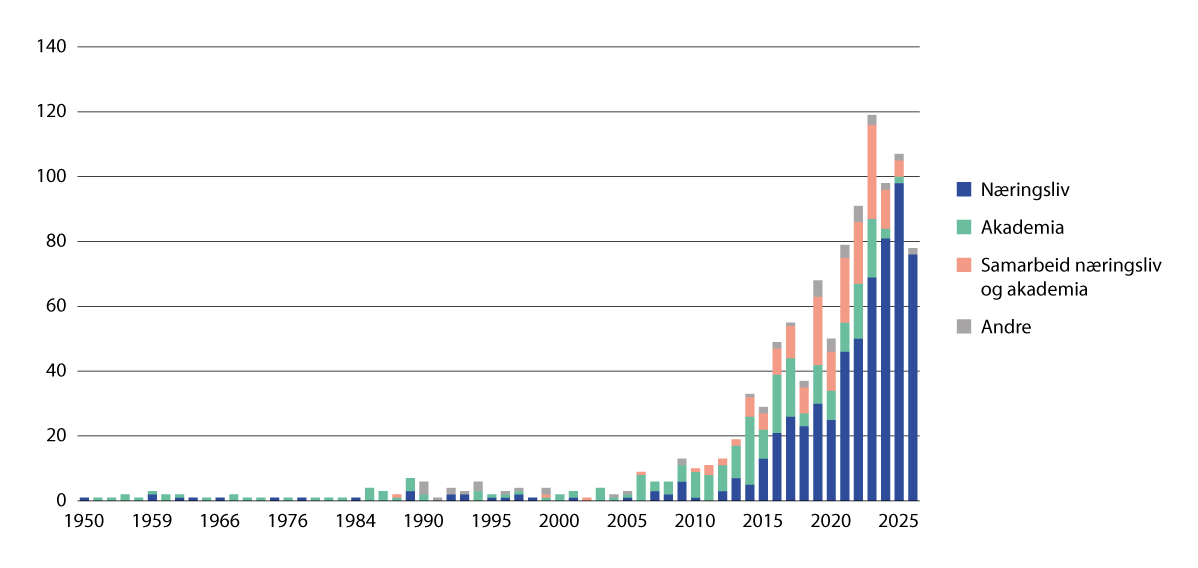
Figur 3.6 Sektortilknytning for forskningsgrupper som utvikler fremtredende KI-systemer, etter publiseringsår
Utvalgets oversetting og tilrettelegging av data fra Epoch AI.
Kilde: (Epoch AI, 2026b)
Miserocchi et al. (2026) har studert konkurransen om KI-forskere i arbeidsmarkedet mellom næringsliv og akademia, og dokumenterer en stor reallokering av KI-forskere mot de fremste teknologiselskapene mellom 2005 og 2020. Ahmed et al. (2023) har undersøkt forfatternes sektor-tilknytning på artikler til ledende KI-konferanser, og finner at andelen artikler med minst én forfatter fra næringslivet viser en skarp økning fra 2016, fra ca. 20 prosent til ca. 40 prosent. Dermed har næringslivet i økende grad kommet til å dominere alle de tre nøkkelingrediensene i moderne KI-forskning og KI-utvikling: regnekraft, store datasett og høyt kvalifiserte forskere. Dette gir utslag i forskningsresultater: Næringslivet har større innflytelse på akademiske publikasjoner, de ledende modellene og på referansepunkt for ytelse (Ahmed et al., 2023). Utviklingen har fortsatt etter 2020. I 2025 sto næringslivet for over 90 prosent av de mest betydningsfulle KI-modellene, og de mest kapable modellene er også de minst åpne når det gjelder treningsdata, kode og størrelse (Sajadieh et al., 2026). Et flertall av nye KI-doktorer går fortsatt til næringslivet, men andelen i USA og Canada som velger akademia, har økt noe siden 2022 (Sajadieh et al., 2026, kap. 7).
Tall fra Statistisk sentralbyrås undersøkelse om den samlede ressursbruken til forskning og utviklingsarbeid (FoU) i Norge gir indikasjoner på forholdene nasjonalt (Statistisk sentralbyrå, 2025a). Innenfor kategorien «Kunstig intelligens, maskinlæring og maskinresonnering» ble det i 2023 brukt totalt 4 515 millioner kroner på FoU-utgifter, FoU-personale og FoU-årsverk. 73 prosent av dette beløpet ble brukt i næringslivet, 19 prosent i universitets- og høyskolesektoren og 8 prosent i instituttsektoren.
Resonnerende modeller (Wei et al., 2022) har stått for flere av de seneste gjennombruddene i hva KI-systemer kan gjøre. For eksempel har de gjort det mulig å produsere avanserte matematiske og logiske bevis, jf. kap. 5.6.2. Resonnerende modeller er i stand til å bryte opp komplekse oppgaver i mindre steg, som så løses sekvensielt, og kan deretter sammenholde ulike løsninger før de gir endelige svar. Denne typen modeller krever mer beregningsressurser enn tidligere KI-modeller både når de kjøres og når de trenes.
Et annet utviklingstrekk er at KI-agenter (jf. kap. 3.4.4) i økende grad er i stand til å gjøre nyttig arbeid. For eksempel har KI-agenter vist evne til å fullføre en rekke oppgaver innenfor programvareutvikling under begrenset tilsyn av mennesker. 2025 ble av mange utpekt som «agentenes år», og selv om de høyeste forventningene ikke ble oppfylt, slår 2025-utgaven av den velrennomerte AI Index Report fra Stanford University fast at KI-agenter viser lovende ytelse (Maslej et al., 2025).
OECD har skissert fire hovedscenarioer for KI-utviklingen frem mot 2030 (Hobbs et al., 2026), basert på vurderinger av kapabilitetsindikatorene nevnt i starten av dette delkapittelet. De fire scenarioene spenner fra at utviklingen stanser opp og kapabilitetene blir værende på dagens nivå fremover, til at utviklingen akselerer og fremskrittene kommer enda raskere enn de har gjort de siste fem årene. Dette siste scenarioet rommer også muligheten for såkalt kunstig generell intelligens, der kapabilitetene er på nivå med menneskelige evner på de fleste arbeidsområder, eller superintelligens, der kapabilitetene langt overgår det som er mulig for mennesker. Mellom disse ytterpunktene er det i OECD sin analyse to nivåer, der utviklingen går videre, men saktere eller i samme tempo som nå. Innenfor hvert av de fire scenarioene kan det være variasjoner i utviklingstakten mellom ulike kapabiliteter, som språk, syn og fysisk interaksjon. For eksempel kan utviklingen tenkes å gå raskere innen maskinsyn (systemenes evne til å tolke visuell informasjon i bilder og video) enn når det gjelder evnen til å håndtere fysiske objekter.
Overordnet peker OECD på flere usikkerhetsmomenter knyttet til utviklingen videre. Tilgang på data, beregningskapasitet, samt energi og vann til drift av datasentre er kritiske faktorer. Fortsatt skalering av KI-modellene vil kreve store investeringer, mens det er usikkert om en slik skalering vil gi tilstrekkelig økonomisk avkastning til at investeringene opprettholdes. Forbedringer av algoritmene kan øke ytelsen betydelig, men forutsetningene for dette er usikre. Bruk av KI i programmering kan akselerere utviklingen av KI-systemer, men akkurat hvor sterk effekten av dette vil være, er usikkert.
The Government Office for Science i Storbritannia legger i sine scenarier for KI i 2030 (2026) til grunn at KI-kapabiliteter vil fortsette å øke. De mener at KI-systemer trolig vil operere langt mer selvstendig og kunne utføre et bredere spekter av kognitive og faglige oppgaver innen 2030.
I tillegg til den teknologiske utviklingen kan en rekke andre kulturelle, sosiale, økonomiske og institusjonelle faktorer virke inn på hvilken retning og hastighet utviklingen tar. Det kan handle om politiske beslutninger, regulering, eierskap og styringsstrukturer, utbredelse av KI-systemer i befolkningen og endringer i opinionen. Men det kan også handle om faktorer vi per nå ikke kjenner eller forstår.
Vi kan derfor ikke legge til grunn én bestemt beskrivelse av teknologiutviklingen, men må ta høyde for en stor grad av usikkerhet. Samtidig kan vi fastslå at kapabilitetene som allerede er oppnådd, er tilstrekkelige til å medføre betydelige endringer på flere områder, og at disse endringene uansett vil få større betydning i tiden som kommer.
4 Grunnleggende problemstillinger og juridiske rammer for utvikling og bruk av kunstig intelligens
4.1 Innledning
Fremskrittene innenfor kunstig intelligens (KI) og den raske utbredelsen av teknologien har åpnet store muligheter på en rekke samfunnsområder. Bedrifter, organisasjoner, offentlige myndigheter og enkeltpersoner finner stadig nye bruksområder der KI-systemer kan automatisere arbeidsoppgaver, gi bedre tilgang til informasjon, utvikle nye løsninger eller gi forbedringer i kvalitet og effektivitet.
KI-støttet forskning kan bidra til nye vitenskapelige gjennombrudd, økt innovasjon og verdiskapning, og løsninger på globale samfunnsutfordringer som klimaendringer og smittsomme sykdommer (OECD, 2023a). KI-systemer kan også spille en viktig rolle i krisehåndtering og humanitær hjelp (FN, u.å.).
Utvikling og bruk av KI-systemer reiser på den annen side mange problemstillinger. Problemstillingene oppstår delvis på grunn av hvordan kunstig intelligente systemer blir utviklet, med store datasett som kan inneholde åndsverk, personopplysninger og historiske skjevheter. Det har også å gjøre med hvor komplekse og ressurskrevende beregninger systemene utfører, der vi ikke enkelt kan forstå hvordan de kommer frem til resultatene de gjør, eller hva et system identifiserer som effektive metoder for å oppnå de målene det er trent for. Som maktmiddel reiser KI-teknologien også strategiske problemstillinger, blant annet om hva slags løsninger vi kan gjøre oss avhengige av og hva slags løsninger vi skal ha kontroll over, samt hvordan den påvirker vår kognisjon og adferd. I tillegg til slike etiske og strategiske vurderinger må utvikling og bruk av KI-systemer forholde seg til både nye og etablerte lover og regler.
Flere av de etiske problemstillingene og juridiske rammene som beskrives her, vil også bli løftet frem i andre kapitler. Utvalget ser dem likevel som såpass viktige for en kritisk og reflektert tilnærming til KI at vi har valgt å synliggjøre dem i et eget kapittel. Kunnskap om denne typen problemstillinger vil være viktig både for ansatte i universitets- og høyskolesektoren og for studentene som skal forberedes på et arbeidsliv og et samfunnsliv som er mer preget av KI.
Kapittel 4.2 beskriver en del av de grunnleggende problemstillingene som reiser seg ved utvikling og bruk av KI-systemer. Kapittel 4.3 beskriver noen av de viktigste juridiske rammene for utvikling, kjøp, salg og bruk av KI-systemer i Norge og Europa. De beskrevne problemstillingene og juridiske rammene er ikke særegne for høyere utdanning som brukskontekst, men eksempler med særlig relevans for høyere utdanning trekkes frem i beskrivelsene. Hvordan universitets- og høyskolesektoren kan forholde seg til og håndtere denne typen problemstillinger, tas opp i andre kapitler.
4.2 Grunnleggende problemstillinger
Universiteter og høyskoler er samfunnsinstitusjoner med et særlig ansvar for å utvikle, kvalitetssikre, forvalte og formidle kunnskap som et offentlig gode. Det fordrer etiske refleksjoner over teknologiens positive og negative effekter både på samfunns- og individnivå, som går ut over rene kost-/nyttevurderinger og juridiske avklaringer. Utfordringene spenner fra overordnede spørsmål om maktforhold, bærekraft og demokratiske verdier, til vurderinger av teknologiens pålitelighet, bruk av personopplysninger og åndsverk, og hvordan den påvirker menneskers tenkning, relasjoner og tillitsforhold. Samlet illustrerer disse perspektivene at KI-teknologi griper inn i sentrale verdier utdanningsinstitusjonene er satt til å forvalte.
Menneskeverd og grunnleggende rettigheter står sentralt i diskusjoner om etiske prinsipper for kunstig intelligens, slik det blant annet kommer til uttrykk i EUs Ethics Guidelines for Trustworthy AI (EU Commission High-Level Expert Group on Artificial Intelligence, 2019). Disse retningslinjene understreker at KI-systemer skal brukes til gode for menneskeheten og fellesskapet, med mål om å forbedre menneskers velferd og frihet. Med utgangspunkt i internasjonale menneskerettigheter, EU-traktatene og EUs charter om grunnleggende rettigheter, utleder retningslinjene fire etiske prinsipper for pålitelig kunstig intelligens: respekt for menneskers autonomi, forebygging av skade, rettferdighet og forklarbarhet.
Disse prinsippene leder frem til sju grunnleggende krav til pålitelig KI, nemlig menneskelig selvbestemmelse og kontroll; teknisk robusthet og sikkerhet; personvern og dataforvaltning; åpenhet; mangfold, ikke-diskriminering og rettferdighet; samfunnsmessig og miljømessig velferd samt ansvarlighet (EU Commission High-Level Expert Group on Artificial Intelligence, 2019, s. 14, 15–19). Selv om disse retningslinjene har hatt stor innflytelse, har pålitelig KI også blitt definert på andre måter og med andre elementer, og pålitelighet er ikke den eneste måten å ramme inn etisk KI på (Follesdal & Langford, 2026; Li et al., 2023).
Flere av disse forholdene er også tett sammenvevde. For eksempel innebærer prinsippet om menneskelig autonomi at individer som forholder seg til KI-systemer skal kunne opprettholde reell selvbestemmelse og delta i demokratiske prosesser. Det forutsetter at KI-systemer ikke skal undertrykke, tvinge, bedra, manipulere, styre eller føre mennesker. Mennesker må derimot kunne kontrollere og styre arbeidsprosesser der KI inngår, og ha reel mulighet til å forstå, overprøve og avvise systemets forslag. Dette stiller på sin side krav til hvordan systemene fungerer rent teknisk, og hvordan de reguleres, forvaltes og brukes. Dessuten kan det være utfordrende å opprettholde alle sider ved pålitelighet på et høyt nivå samtidig: Bedre forklarbarhet kan gå på bekostning av nøyaktighet, og personvern på bekostning av ikke-diskriminering (Giudici et al., 2024; Hoch et al., 2024).
I dette delkapittelet går vi inn på følgende temaer:
-
transparens, etterprøvbarhet og kontroll
-
samsvarsproblemet
-
formålstjenlig bruk, riktige avgjørelser og likebehandling
-
bruk av personopplysninger og åndsverk
-
bærekraft: klimautslipp, miljøpåvirkning og global fordeling
-
tillit, relasjoner, sosialt fellesskap og sosial ulikhet
-
avhengighet, kompetanseillusjon og kognitiv overgivelse
-
makt, offentlighet, påvirkning og idémangfold
-
digital suverenitet
Temaene er ikke rangert etter viktighet, og noen av dem behandles mer utførlig i senere kapitler. I denne delen er formålet å gi en ramme for noen grunnleggende etiske avveininger UH-institusjonene må gjøre når KI-systemer tas i bruk, i lys av forskningslitteraturen og praksis. Samtidig griper KI-teknologien inn på så mange områder at de samlede etiske problemstillingene er flere og mer omfattende enn utvalget har anledning til å drøfte her.
4.2.1 Transparens, etterprøvbarhet og kontroll
Å kunne ta ansvar for hvordan et KI-system brukes og resultatene det gir, forutsetter at man har kontroll over systemet. Det henger igjen sammen med hvilken evne man har til å forstå og eventuelt kunne påvirke eller etterprøve resultatene. En rekke internasjonale rammeverk for etisk KI, slik som UNESCOs Recommendation on the Ethics of Artificial Intelligence (2022), understreker betydningen av transparens og forklarbarhet for ansvarlig KI-bruk. Det handler ofte om rettssikkerhet, det å kunne utfordre beslutninger og få rettet opp feil, muligheten til å føre tilsyn, å kunne stille beslutningstakere til ansvar og om tillit til systemene.
Et kjennetegn ved mange av dagens KI-systemer er at det kan være vanskelig å forstå hvordan de kommer frem til et gitt resultat. Maskinlæringsteknikker avdekker mønstre i store datamengder (se kap. 3), inkludert mønstre som ikke lar seg beskrive eller etterprøve av mennesker på en intuitiv måte. Årsaken er at modellene bygger på store sett av numeriske parametere som er justert ved bruk av komplekse algoritmer og et stort antall beregninger (Bellas et al., 2025). Dersom vi dessuten ikke har innblikk i hvilke data systemene er trent på og hvordan de har vært trent, blir systemene desto mindre transparente.
Dermed kan systemene fungere som «svarte bokser», på to ulike måter:
-
For kommersielle KI-systemer ser vi hvilke data som går inn og hva som kommer ut, men ikke hva som skjer med dataene underveis.
-
Om vi har tilgang til selve modellen, kan vi inspisere alle operasjonene som utføres på inndataene i prosessen som fører til modellens svar. Dette er likevel ikke det samme som å kunne forstå hva operasjonene representerer.
Vår mulighet til å forstå KI-systemer og deres atferd beskrives gjerne med begrepsparet «tolkbarhet» og «forklarbarhet» (Arrieta et al., 2020). Et KI-systems tolkbarhet dreier seg om i hvilken grad det er mulig for oss å forstå hvordan det virker eller tar beslutninger; dets indre logikk. Et KI-systems forklarbarhet dreier seg om hvor godt vi i interaksjon med systemet kan få forklaringer på resultatene systemet gir som utdata. Slik begrepene brukes her, er tolkbarhet en passiv egenskap man kan stadfeste ved å studere selve modellen, mens forklarbarhet er noe som aktivt må frembringes, enten av systemet selv eller ved hjelp av egne forklaringsmetoder (Arrieta et al., 2020). Forklarbarhet kan for eksempel oppnås gjennom at systemet gir forklaringer på hvert enkelt resultat det produserer (se Boks 4.1).
Om en modell er så kompleks at det praktisk talt er umulig å få en god forståelse av hvordan ulike typer inndata gir ulike typer utdata, har det lav tolkbarhet. For eksempel er det ikke gitt hvordan svaret på spørsmålet «hvorfor svarte språkmodellen at denne oppgaven står til stryk?» skal produseres. Skal det være en gjenfortelling av de mange milliarder regneoperasjonene foretatt av språkmodellen, som rent mekanistisk var det som førte til utfallet? Det kan likevel være mulig at systemet rundt bygges med en funksjonalitet for å gi forklaringer på modellens atferd og hvorfor bestemte resultater blir til. Et helt system kan altså være forklarbart, selv om KI-modellen ikke er direkte tolkbar. Slike forklaringer gjenspeiler imidlertid ikke nødvendigvis hvordan systemet faktisk kom frem til resultatet.
Boks 4.1 Svarte og hvite bokser
I hvilken grad man har mulighet til å inspisere en maskinlæringsmodell og forstå hva som foregår på innsiden, er en nøkkelfaktor for hva modellen kan brukes til og hvordan resultatene kan brukes.
-
Hvit boks-algoritmer er maskinlæringsmodeller der alle steg i beslutningsprosessen er synlige og tolkbare. Ingenting er skjult, og resultatene kan enkelt etterprøves. Beslutningstrær, regelbaserte systemer og regresjonsmodeller er typiske eksempler. Slike systemer kan være viktige innen finans, helsevesen og til juridisk bruk.
-
Svart boks-algoritmer karakteriseres av høy kompleksitet og lav tolkbarhet. Beslutninger er skjult under flere lag av beregninger som ikke er direkte tolkbare. Empirisk ser vi at statistiske modeller med lav tolkbarhet ofte har høyere prediktiv ytelse, grunnet flere parametere og muligheten til å modellere komplekse sammenhenger. Nevrale nettverk, som utgjør ryggraden i moderne kunstig intelligens, er et typisk eksempel.
Hybride tilnærminger tar sikte på å kombinere tolkbarhet og ytelse. Det kan gjøres på flere måter. Etter å ha trent en kompleks modell, kan man lage en enklere, mer tolkbar modell, en slags skygge som tilnærmer seg oppførselen til den originale modellen. Den vil ikke være like nøyaktig, men kan gi en bedre forståelse av hva som foregår under panseret.
Forklarbar KI (Explainable AI eller XAI) er en annen tilnærming, som tar sikte på å gjøre også de mest komplekse modellene mer tolkbare, uten å ofre for mye ytelse. Verktøy som LIME og SHAP endrer ikke selve modellen, men viser hvilke variabler som bidrar sterkest til det endelige resultatet. Slik kan det bli enklere for mennesker å forstå modellens atferd. For å forstå hva som foregår på innsiden av modellen er mer avanserte tilnærminger nødvendige, som mekanistiske tolkninger (mechanistic interpretability).
Kilde: Yadav (2024)
Forklaring av hvorfor KI-modeller gir svarene de gir er et kun delvis løst forskningsspørsmål, og denne statusen gjør det vanskelig å kreve eller tilby etterprøvbarhet av KI-resultater. Dette har store konsekvenser for vurderinger knyttet til kontroll og ansvar. Manglende etterprøvbarhet kan begrense hva det er ønskelig eller forsvarlig å bruke systemene til, og hvordan.
Gjennom 2026 har det blitt utviklet flere og mer kapable agentiske KI-systemer (jf. kap. 3). KI-agenter kan i større grad jobbe på egenhånd for å løse en oppgave, uten å involvere brukeren i hvert steg underveis. For agenter gjelder forklarbarhet ikke lenger bare ett enkelt svar, men en hel kjede av planer, verktøybruk og delbeslutninger (Chan et al., 2024). Det agenten har gjort, kan som regel spores i logger, mens hvorfor den valgte som den gjorde, er langt vanskeligere å få en pålitelig forklaring på. Jo mer komplekse og selvgående KI-systemene blir, desto større blir utfordringene knyttet til transparens, etterprøvbarhet og kontroll.
4.2.2 Samsvarsproblemet
En KI-modell er i bunn og grunn et svært komplekst regnestykke, der det som kommer ut avhenger av det vi legger inn, og av hvordan modellen er satt sammen. Hvordan kan vi sikre at modellen oppfører seg i tråd med våre verdier, intensjoner og mål? Denne grunnleggende utfordringen kalles samsvarsproblemet (the alignment problem) (Christian, 2020; Teknologirådet, 2026). Samsvarsproblemet knytter seg både til skjevhet (jf. kap. 4.2.3), misforståtte mål og kompleksiteten i modellene.
Dersom utviklere eller brukere gir KI-modellen mål eller instruksjoner som ikke er tilstrekkelig dekkende for det man ønsker å oppnå, kan KI-modellen innrette atferden sin mot feil mål eller utnytte spuriøse korrelasjoner, altså statistiske sammenhenger uten en logisk eller kausal forbindelse. Slik kan en modell for eksempel legge større vekt på å overbevise mennesker om at den har rett enn på å faktisk gi korrekt informasjon, for å oppnå et mål om brukertilfredshet. Utilstrekkelige målformuleringer kan også gi opphav til modeller som tar snarveier eller manipulerer miljøet sitt heller enn å løse den faktiske oppgaven. Det kan være at et KI-system oppnår mål det er trent eller instruert for, gjennom å bryte mange av de målene vi har, men som vi ikke har trent eller instruert systemet for. Hvordan formulere mål for KI-modeller som unngår slik ikke-samsvarende (misaligned) atferd og ivaretar alle interesser, er et uløst forskningsspørsmål.
Misforståtte mål kan også være resultat av mer komplekse forhold i måten modellene bygges og trenes på. Teknikker som brukes til optimalisering kan innebære at modellen setter seg delmål eller stedfortredende mål som ikke nødvendigvis samsvarer med de overordnede målene (Bengio et al., 2026). Slike forhold, ofte omtalt som mesa-optimalisering, kan være vanskelige å undersøke.
En konsekvens av dette er at KI-utviklere ikke fullt ut kan forutsi eller kontrollere atferden til den ferdige modellen i enhver gitt situasjon. Dermed er det en risiko for at KI-modellen utviser uventet eller skadelig atferd, enten som følge av hvordan målene er programmert, eller fordi systemet misforstår eller feiltolker målene det instrueres til å følge. Dette kan ha store konsekvenser knyttet til sikkerhet, pålitelighet og menneskelig kontroll.
4.2.3 Formålstjenlig bruk, riktige avgjørelser og likebehandling
En KI-modell er trent opp på et utvalg av data, som sammen med målformuleringer og treningsprosessen danner grunnlaget for hvordan det behandler ny informasjon. Det medfører at systemet kan videreføre historiske skjevheter, belønne feil kriterier eller gi uforutsigbare resultater i nye situasjoner (Barocas et al., 2023). Dette kan føre til feilaktige vurderinger og vedtak når KI-systemer benyttes i beslutningsprosesser.
Utfordringene er mange: Systemet kan basere seg på unøyaktige, ufullstendige, irrelevante eller uriktige data; det kan indirekte spore trekk som ikke skal ha betydning for vedtaket; det kan videreføre og forsterke systematiske skjevheter; det kan «hallusinere»; det kan brukes til andre formål enn det er trent for; og det kan introdusere nye former for forskjellsbehandling som er vanskelige å identifisere eller etterprøve. Dette kan føre til spørsmål om i hvilken grad et KI-system – og måten det tas i bruk på – kan ivareta idealer om rettferdighet, saklighet og likebehandling. Offentlig sektor har ifølge Likestillings- og diskrimineringsombudet et særlig ansvar for å sikre at maskinlæringssystemer som utvikles eller tas i bruk, fremmer likestilling og forebygger diskriminering (Strand, 2024).
Samtidig er det ikke gitt at menneskelige vurderinger alltid ivaretar disse idealene bedre enn et KI-system. Også mennesker gjør feil, forskjellsbehandler og er inkonsekvente (Kahneman et al., 2021). Spørsmålet er ikke om mennesker eller maskiner i seg selv er mer pålitelige, men om beslutningsprosessen samlet sett er forsvarlig, rettferdig og etterprøvbar (Zerilli et al., 2019).
4.2.3.1 Skjevhet
Skjevhet, eller bias, er en kjent utfordring for databaserte modeller, inkludert maskinlæringsmodeller, og henger sammen med hvilke data modellen er trent på og hvilke justeringer utviklerne har gjort underveis. Historiske data er ikke nødvendigvis representative for nåsituasjonen modellen brukes på. Hvis datagrunnlaget for en modell gjenspeiler en systematisk forskjellsbehandling, vil modellen kunne videreføre og forsterke denne forskjellsbehandlingen. Skjevheter kan også skyldes at datagrunnlaget i sin helhet ikke er representativt, som når en språkmodell hovedsakelig er trent opp på vestlige, engelskspråklige datakilder, eller når en modell for ansiktsgjenkjenning er trent opp på bilder av bare én etnisk gruppe. Data kan være skjevfordelt mot bestemte interesser, ideologier eller synspunkter. Skjevheter kan også være resultat av en bevisst manipulering av datagrunnlaget. Videre kan de som utvikler modellen, tilsiktet eller utilsiktet, forårsake eller forsterke skjevheter i måten de veileder og finjusterer modellen på underveis i treningen.
Boks 4.2 Skjevhet i vurdering
Skal man trene opp en KI-modell til å vurdere studentbesvarelser, vil det være hensiktsmessig å trene den på tidligere besvarelser og vurderinger av dem. I slike tilfeller må man – både i utvikling og ved bruk av systemet – være oppmerksom på at enkelte trekk ved studentbesvarelsene historisk sett kan ha blitt underpremiert eller overpremiert. Sensorer kan ha gjort skjeve vurderinger av bestemte sosiale grupper – eksempelvis gjennom tekstmarkører som studentenes navn eller skrivestil. Dette er i så fall mønstre som kan gjenoppstå i modellens fremtidige vurderinger.
Et annet eksempel er at KI-modeller kan ha språklige skjevheter og forskjellsbehandle studenter med andre morsmål, i en utdanningskontekst som kan være flerspråklig og internasjonal (Bulut et al., 2024; Ripoll Y Schmitz & Sonnleitner, 2025). Skjevheter i data som påvirker anbefalinger eller fører til unøyaktig sensur kan resultere i uforholdsmessige konsekvenser for visse studentgrupper (Bulut et al., 2024).
I verste fall kan treningsmaterialet inneholde diskriminerende mønstre eller brudd på forbudet mot diskriminering, som systemet dermed risikerer å reprodusere (Strand, 2024) (jf. kap. 4.3.5).
4.2.3.2 Hallusinering
Responsen fra KI-systemer som bygger på store språkmodeller er basert på sannsynlighet for hvilke ord som følger hverandre. Nyere modeller resonnerer i flere steg og kan bruke verktøy som nettsøk til å kontrollere opplysninger. De kan likevel fortsatt gi svar som er språklig korrekte og overbevisende, men innholdsmessig uriktige. Dette omtales ofte med begrepet «hallusinering» og er et åpenbart problem hvis man benytter en samtalerobot til å finne faktaopplysninger eller kildehenvisninger til bruk i akademiske tekster. I tester hvor samtaleroboter får i oppgave å oppsummere spesifikke nyhetsartikler, lager modellene til store selskaper som Google og OpenAI oppdiktet informasjon i 3 prosent av tilfellene eller mer (Vectara, 2026). Når modellene skal svare på krevende faktaspørsmål, er andelen langt høyere (Sajadieh et al., 2026). Resonnering i flere steg har ikke løst problemet: Andelen feil har økt med de nyere resonnerende modellene (Vectara, 2026). Slike feil kan undergrave tilliten til systemene (Yan et al., 2024).
For i størst mulig grad å unngå hallusinering, krever KI-forordningen nøyaktighet, forebygging av feil, et kvalitetsstyringssystem og menneskelig tilsyn (Schuster et al., 2025) (jf. kap. 4.3.2).
4.2.4 Bruk av personopplysninger og åndsverk
4.2.4.1 Personopplysninger
Personopplysninger er enhver opplysning om en identifiserbar fysisk person. Bruk av slike opplysninger er strengt regulert gjennom det europeiske personvernregelverket GDPR (jf. kap. 4.3.3). Personvern handler om maktforhold, tillit, valgfrihet og trygghet fra misbruk og overvåkning. Opplysninger samlet inn for ett formål kan være attraktive for bruk til et annet. Læringsdata er et illustrerende eksempel: Digitale læringsplattformer, eksamenssystemer, plagiatkontroll, videoløsninger, samtaleroboter og adaptive læringsverktøy kan samlet gi et detaljert bilde av studenters aktivitet, språk, progresjon, faglige usikkerhet og behov for støtte. Innsamling av slike data kan brukes til bedre oppfølging og tilrettelegging, men kan også oppleves som overvåkning og føre til selvsensur og redusert psykologisk trygghet (NOU 2023: 19). Spørsmålet er ikke bare om behandlingen er lovlig, men om den er nødvendig, forholdsmessig og forenlig med et godt læringsmiljø.
Generativ KI kan forsterke denne typen utfordringer, både ved å legge til rette for at studentene avgir flere personopplysninger til systemene, og gjennom muligheten teknologien gir for å sammenstille, bearbeide og utnytte disse opplysningene.
4.2.4.2 Åndsverk
Åndsverk er resultater av menneskelig tankevirksomhet. Det kan typisk være litterære verk, filmer, musikkstykker eller kunstverk, men også avisartikler, podkaster, TV-innslag, akademiske tekster eller programmeringskode. Opphavsrett er retten til å kontrollere bruken av et åndsverk. Opphavsrettens etiske kjerne er anerkjennelse, kontroll over eget åndsverk, mulighet til inntekt og bærekraftige vilkår for skapende, vitenskapelig og journalistisk virksomhet.
Generative KI-modeller er trent på store mengder tekst, bilder, lyd, video og kode som kan være beskyttet av opphavsrett, uten at utviklerne nødvendigvis har innhentet samtykke. Det reiser både etiske og juridiske spørsmål og har ført til søksmål i flere land (Dornis et al., 2026; op de Beeck, 2026). Som følge av treningen kan disse åndsverkene inngå i KI-systemer som senere konkurrerer med eller erstatter kreativt menneskelig arbeid. Da oppstår det spørsmål om hvem som får ta del i verdiskapingen, og om KI-modellenes bruk av åndsverk undergraver de samme kreative miljøene som treningen er avhengig av.
Problemstillingen knytter seg også til prinsipper om akademisk redelighet, som tilsier anerkjennelse av andres vitenskapelige arbeid som grunnlag for nye funn, metoder og slutninger (se kap. 5 for eksempler). Videre kan den reise bekymringer om balansen mellom innovasjon og rettferdighet. En KI-modell kan være til fordel for samfunnet ved å gi tilgang til kunnskap fra en stor mengde vitenskapelig litteratur. Samtidig kan denne kunnskapen bygge på åndsverk fra opphavere som ikke har gitt tillatelse til eller mottatt kompensasjon for bruken. Selv om norske universiteter og høyskoler ikke nødvendigvis er juridisk forhindret fra å bruke slike modeller (jf. kap. 4.3.6), kan det være etisk problematisk å bruke produkter som er basert på krenkelse av andres rettigheter. Det kan alminneliggjøre plagiering og undergrave akademisk integritet (Farrokhnia et al., 2024).
Det er mulig, om enn krevende, å bygge språkmodeller uten å komme i konflikt med opphavsrett. Nasjonalbiblioteket inngikk i desember 2025 en kollektiv avtale om bruk av innhold fra norske aviser til trening av norske og samiske språkmodeller (Nasjonalbiblioteket, 2025). Lignende arbeid pågår i andre europeiske land. I Nederland er språkmodellen GPT-NL trent utelukkende på materiale der opphavsretten er avklart (GPT-NL, u.å.).
Andre spørsmål om opphavsrett oppstår når en bruker instruerer et KI-system til å generere nytt innhold. Det kan være uklart om resultatet er tilstrekkelig menneskeskapt til å få vern som åndsverk, hvem som eventuelt har rettigheter til det og om resultatet krenker andres opphavsrett. Dette er relevant når studenter og ansatte bruker KI-generert tekst, bilder, kode eller lyd i oppgaver, undervisning, forskning og formidling. Utfordringen er også institusjonell. Blant annet kan undervisningsmateriell, lærebøker og andre læreressurser, oppgaver og studentbesvarelser være opphavsrettslig beskyttet. Det er ikke gitt at materialet som er tilgjengelig internt i en læringsplattform kan brukes til trening av KI-modeller eller lastes opp til kommersielle KI-tjenester.
4.2.5 Bærekraft: klimautslipp, miljøpåvirkning og global fordeling
Infrastrukturen og de globalene forsyningskjedene som kreves for å kunne utvikle, trene og kjøre KI-modeller, er omfattende. Databrikker laget av sjeldne mineraler, servere som fyller svære datasentre, vannbaserte kjølesystemer, fiberkabler og ikke minst behovet for store mengder elektrisk kraft gir både miljømessige og sosiale kostnader.
Treningen av de mest komplekse modellene krever store mengder energi. Særlig med utviklingen av resonnerende modeller og agentiske systemer er bruken av KI-systemer blitt stadig mer energikrevende. Bruken av KI-systemer står i dag for vesentlig mer av den totale energikostnaden enn utviklingen av modeller. Mens rundt 380 millioner mennesker brukte dedikerte KI-systemer i 2025, øker antallet brukere dramatisk når funksjoner som Google-søk inkluderes. Med rundt 14–16 milliarder daglige søk, og KI-teknologi dypt integrert i funksjonaliteten, gjør Google alene mer enn en milliard mennesker til KI-brukere hver dag. Ifølge en rapport fra FN-organisasjonen United Nations University (UNU) utgjør den kontinuerlige bruken av KI-modellene rundt 80 til 90 prosent av det totale energiforbruket knyttet til KI (Aczel et al., 2026). Forbruket per forespørsel varierer stort og styres av mange faktorer: type oppgave, kompleksitet, modellstørrelse, kontekstvindu, lengden på instruksen, lengden på utdata og andre innstillinger.
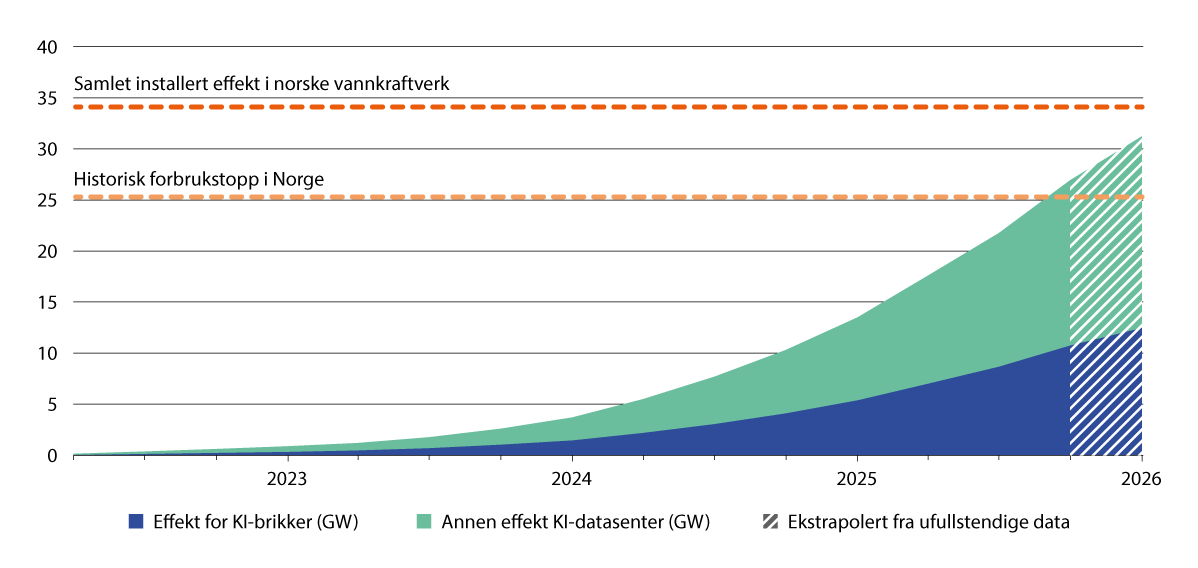
Figur 4.1 Beregnet global effektkapasitet for KI
Grafen viser hvor mye strøm som ville gått med til å kjøre alle verdens KI-brikker levert av de største produsentene, på maksimal effekt. Den viser altså ikke det faktiske forbruket. Effektkapasiteten er beregnet utfra antall solgte brikker av ulike typer og deres oppgitte effektbehov (thermal design power – TDP). En faktor på rundt 2,5 er brukt for å ta høyde for ytterligere strømbehov til servere, kjøling og infrastruktur i datasentrene.
Kilder: Edelman et al. (2026). Tilpasset og oversatt fra originalen. Lisens: CC BY. Norske tall fra NVE.
Selv om forbedringer i maskin- og programvare kan gjøre treningen av nye modeller mer effektiv, oppveies dette ifølge forskningsinstituttet Epoch AI av en dramatisk økning i modellstørrelser, som gir mer kapable modeller og dermed større etterspørsel (Ostrovsky, u.å.).
Datasentre spiller en rolle i nesten alle aspekter av et moderne hverdagsliv, fra videostrømming og nettspill til sosiale medier, netthandel og skytjenester. De er også ryggraden i KI-infrastrukturen. KI-bruk sto for rundt 20 prosent av datasentrenes strømforbruk i 2025 og er beregnet å øke til 40 prosent i 2030 (Aczel et al., 2026). Det vil i så fall kunne utgjøre 378 TWh – nesten tre ganger Norges årlige strømforbruk.
Rapporten fra UNU fremhever at miljøvirkningene ikke bare avhenger av hvor mye elektrisitet modellene bruker, men også av hvor energien kommer fra. Hvordan kraften er produsert, har stor betydning for karbonutslipp, vannforbruk og hvor mye areal som berøres. Fordelingen mellom disse tre formene for miljøavtrykk varierer fra en energikilde til en annen. Derfor er det ikke tilstrekkelig å bruke bare ett mål på bærekraft, og det er ikke gitt at datasentre som bruker fornybar energi dermed kan regnes som «grønne», «rene» eller «bærekraftige» (Aczel et al., 2026).
Beregnet ut fra globale gjennomsnitt vil KIs andel av det anslåtte energiforbruket til datasentrene i 2030 utgjøre et karbonfotavtrykk på 158 millioner tonn – tre og en halv gang Norges samlede klimagassutslipp i 2025. Vannfotavtrykket vil være på 3 700 milliarder liter, som tilsvarer det årlige vannbehovet til mer enn 500 millioner mennesker i Afrika sør for Sahara. Arealfotavtrykket vil utgjøre 5 744 km2, omtrent som Akershus fylke.
KIs materielle fotavtrykk omfatter også maskinvare. Databrikker, servere, batterier og andre komponenter lages av kritiske mineraler og sjeldne jordarter. Utvinning av slike materialer er energiintensiv og miljøskadelig, og kan foregå under helsefarlige arbeidsforhold i land med dårlig økonomi og svake sosiale rettigheter. Når komponentene ikke er brukelige lenger, utgjør de farlig elektronisk avfall. I 2030 kan det elektroniske avfallet fra KI-infrastruktur komme opp i 2,5 millioner tonn hvert år, tilsvarende 250 Eiffeltårn (Aczel et al., 2026).
Dette angår også global ulikhet, siden belastningene som følger av gruvedrift, kraftproduksjon, datasenterutbygging og elektronisk avfall, ofte går sterkest ut over utsatte grupper i de fattigste delene av verden. KI-systemenes fotavtrykk omfatter dessuten menneskelig arbeid med data. Treningsdata må renses, merkes og kvalitetssikres, og skadelig innhold må sorteres ut. Mye av dette arbeidet for de store språkmodellene utføres av dataarbeidere i lavinntektsland, med lav lønn, kortvarige oppdrag og svakt arbeidsrettslig vern (Gray & Suri, 2019; Muldoon et al., 2024). Gruppene i det globale sør som bærer disse og andre belastninger er gjerne de som i minst grad får ta del i gevinstene den nye teknologien bringer med seg i det globale nord.
4.2.6 Tillit, relasjoner, sosialt fellesskap og sosial ulikhet
Nye teknologier virker inn på mennesker og samfunn, slik det har vist seg gjennom hele menneskets historie. Teknologien påvirker hvordan vi agerer, hvilke muligheter vi ser, valgene vi gjør og hvordan vi forholder oss til hverandre. Utviklingen og utbredelsen av generativ KI bringer nye dimensjoner inn i dette. Der massemedier, informasjons- og kommunikasjonsteknologier inntil nylig først og fremst har mediert menneskelig kommunikasjon, har KI-systemer i større grad potensiale til å etterlikne og erstatte menneskelig kommunikasjon. Det kan skje helt åpenlyst, eller i det skjulte.
Usikkerheten som dermed oppstår kan ha stor innvirkning på mellommenneskelige relasjoner, men også på forholdet til institusjoner, virksomheter og myndigheter. Det berører fundamentale spørsmål om tillit, ansvarlighet og gjensidige forpliktelser – i ytterste konsekvens, samfunnskontrakten. Mennesker forholder seg ikke til maskiner på samme måte som de forholder seg til hverandre. En rapport om KI-bruk ved Massachusetts Institute of Technology advarer om negative reaksjoner fra studenter som etter å ha lagt tid og innsats i en innleveringsoppgave, opplever at den eneste tilbakemeldingen de får er fra en maskin. Det kan oppfattes som dobbeltmoral og en nedprioritering av undervisning (Massachusetts Institute of Technology, 2026) (se også kap. 6.4.3 og 6.4.4).
Samtidig utgjør menneskeliggjøringen (antropomorfiseringen) av teknologien en egen utfordring. Ved å omtale KI-systemer som partnere, kolleger eller eksperter, kan man tilsløre at systemene ikke har ansvar, intensjoner, forståelse eller faglig dømmekraft. Dette kan bidra til uforsvarlig bruk av KI-løsninger, slik Østfold AI Hub advarer mot i sitt innspill til utvalget.
Menneskelig kontakt og samspill ligger i kjernen av utdanningssystemet. Høyere utdanning handler om å utvikle faglig forståelse, dømmekraft, ansvarlighet, språk og identitet gjennom deltakelse i et faglig og sosialt fellesskap. Utdanningen skal ivareta langsomme, relasjonelle og kritiske læringsformer som ikke uten videre lar seg automatisere eller kommersialisere. Det utelukker ikke at KI-systemer kan støtte læring, men stiller krav til refleksjon omkring hva slags bruk som styrker studentenes selvstendighet, læring og deltakelse, og hva som kan svekke den.
For noen vil KI-systemer først og fremst være frigjørende støtteverktøy som kan gi tilpasset læring, bedre inkludering og tilgjengelighet, og mindre tid brukt på rutineoppgaver. For andre kan den samme utviklingen fremstå som en trussel mot selvstendig læring, menneskelig kontakt og faglig modning. Kapittel 6 går nærmere inn på de ulike effektene bruk av KI-systemer kan ha på læring og læringsmiljø.
KI-teknologien har også konsekvenser for sosial ulikhet ved at ikke alle mennesker har de samme forutsetninger for å bruke KI-systemer på en selvstendig, kritisk og læringsfremmende måte. Her virker en rekke selvforsterkende mekanismer inn gjennom det som i samfunnsvitenskapen ofte kalles Matteus-prinsippet: De som har mest fra før, får mest ut av nye muligheter, slik at forskjellene øker over tid (Merton, 1968). Dette gjelder i stor grad studenter som entrer høyere utdanning med ulike kulturelle, økonomiske, sosiale og intellektuelle ressurser, og derigjennom har ulike forutsetninger for å ta i bruk KI-systemer på fruktbare måter.
4.2.7 Avhengighet, kompetanseillusjon og kognitiv overgivelse
Nyere forskning og pågående debatt tematiserer de psykologiske effektene av å bruke generative KI-systemer. Kooli et al. (2025) beskriver en form for avhengighet som kan følge av at generativ KI tilbyr positiv forsterkning, eskapisme, personifisering og en følelsesmessig tilknytning som illuderer et gjensidig forhold. Som andre former for avhengighet kan tilstanden gi en rekke negative følger både kognitivt, følelsesmessig og sosialt, og den kan være vanskelig å komme ut av. Det som særlig skiller KI-avhengighet fra andre typer digital avhengighet, og som kan forsterke de psykologiske effektene, er at generativ KI tilbyr noe mer enn passiv underholdning – den skaper noe sammen med brukeren.
Når man får bedre prestasjoner av å ta i bruk KI-systemer, kan det styrke selvtilliten. Fernandes et al. (2026) finner at denne effekten kan gi en overdreven tro på egne evner, en tro på at prestasjonene er enda bedre enn de faktisk er. Forskerne sammenlikner resultatene med Dunning-Kruger-effekten, som går ut på at de med lavest kompetanse på et område overvurderer seg selv mest, mens de med høyest kompetanse vurderer seg selv mer treffsikkert. Med KI-bruk finner de at denne effekten elimineres, i den forstand at alle brukerne beveger seg mot overdreven selvtillit. En slik illusjon av at man er mer kompetent enn man faktisk er, kan ha flere negative følger, som å forsterke bekreftelsesfeller.
En beslektet bekymring er at KI-systemer kan fremme det som omtales som kognitiv overgivelse – at brukeren i for stor grad overlater tenkning, vurdering og problemløsing til systemet (Shaw & Nave, 2026). Én oppfatning er at det kan henge sammen med hvordan KI-systemene utformes og måten de svarer på – om de legger til rette for dialog og kritisk vurdering av svarene de gir, eller om de bare gjør hele jobben for deg, som autonome KI-agenter (jf. kap. 3.4.4) (Mollick, 2026).
Spørsmål som står igjen er hva disse effektene kan bety for tenkningen vår, følelsen av eierskap til det vi lager og forholdet vårt til egne vurderinger og dømmekraft.
4.2.8 Makt, offentlighet, påvirkning og idémangfold
Digital teknologi er over tid blitt et stadig tydeligere maktmiddel, i takt med den omfattende digitaliseringen av samfunnets kritiske infrastruktur. KI forsterker denne tendensen ytterligere. Et fåtall globale aktører dominerer og legger i stor grad premissene for utviklingen (Sajadieh et al., 2026). Teknologien de kontrollerer har stor innvirkning på hverdagsliv, arbeidsplasser, utdanningsinstitusjoner, offentlig forvaltning og samfunnsliv. Den styrer informasjonsflyt og legger rammer for menneskelig samhandling, offentlig samtale og kritisk debatt. For universiteter og høyskoler berører det kjernen i dannelsesoppdraget. Hvem som kontrollerer tilgangen til kunnskap og rammene den formidles i, har avgjørende betydning. Normer og verdier som bygges inn i systemene, kan påvirke forskning, kunnskapsutvikling, faglig uavhengighet og akademisk debatt.
KI påvirker kommunikasjon og informasjonsdeling, og dermed vilkårene for demokratisk deltakelse, offentlig samtale og kildekritikk. Algoritmene kan styre vår oppmerksomhet, fremheve noen kilder foran andre, moderere og personalisere innholdet vi ser, og favorisere følelsesutbrudd og engasjement fremfor langsomme analyser. Det har konsekvenser for hvilke perspektiver som får mest plass i debatten, oppfatninger av sannhet og måten mennesker møter uenighet på. Generative KI-systemer kan også brukes til bevisst manipulering ved å produsere desinformasjon i stor skala, og til målrettede påvirkningsforsøk mot bestemte grupper eller enkeltpersoner. Vanskeligheter med å skille mellom KI-generert og ekte bildemateriale, gjør faktabasert rapportering komplisert. Det kan svekke grunnlaget for en felles virkelighetsoppfatning, forsterke konflikter og forstyrre diplomatisk arbeid. Bruk av KI-systemer til direkte påvirkning av demokratiske valg er påvist i flere land (Ekspertgruppen for kunstig intelligens og valg, 2025).
Høyere utdanning spiller en sentral rolle i å utvikle og forsvare demokratiet. KI gir både muligheter og utfordringer for å utvikle demokratisk kompetanse. Som læringsstøtte kan teknologien gi tilgang til bredere perspektiver gjennom å klargjøre fremmede kontekster og oversette kulturelle referanser (Costello et al., 2024). På den annen side kan teknologien endre hvordan og hvor dypt studentene går inn i komplekse og utfordrende argumentasjoner som kan utvikle deres interkulturelle og demokratiske forståelse. Det kan etter hvert svekke evnen til å se saker fra flere sider.
Prinsippet om akademisk frihet innebærer å fritt kunne bestemme hva man vil forske på og hvordan, frihet til å formidle resultatene av forskningen og frihet til å legge opp sin undervisning (NOU 2022: 2). Det forutsetter blant annet tilgang til etablert vitenskapelig kunnskap, en ubegrenset frihet til å dele og formidle kunnskap og forskningsresultater og en åpen dialog med studenter og fagfeller. Integrering av bestemte KI-systemer i den akademiske virksomheten har potensiale til å forstyrre eller forvrenge denne tilgangen, formidlingen og debatten.
Teknologien er ikke verdinøytral, men formet av datagrunnlaget den bygger på og konteksten den er utviklet i, og dette farger resultatene som kommer ut (Rettberg, 2024; Tao et al., 2024). Moderne søkemotorer benytter en rekke KI-teknikker for å forstå søk, vurdere og rangere resultater, filtrere bort spam og irrelevante treff, tolke bilder og videoer, og for å persontilpasse anbefalinger. I økende grad bruker de også generative KI-systemer for å presentere sammendrag eller svar. KI-modeller har dermed sterk påvirkning på hvilke kilder som blir synlige, hvilke spørsmål som fremstår relevante, og hvilke faglige tradisjoner som videreføres.
Om studenter og undervisere i stor grad støtter seg på de samme systemene, kan det føre til standardisering av språk og argumentasjon, måten informasjon kobles sammen og analyseres på, og hvordan kunnskap formidles. Det kan på sikt utfordre det faglige mangfoldet.
Akademisk frihet forutsetter også at studenter og ansatte kan utforske ideer, stille spørsmål og fremme kontroversielle eller upopulære synspunkter uten frykt for urimelige konsekvenser. Digitale produkter og systemer som kan misbrukes til overvåkning, lagring, sammenstilling og analyse av meningsytringer og diskusjoner, slik de for eksempel foregår i forelesninger eller kollokviegrupper, kan føre til selvsensur og redusert vilje til å prøve ut nye ideer eller utfordre etablerte oppfatninger. Slike nedkjølingseffekter kan bli sterkere dersom kroppsnær teknologi som smartbriller blir mer utbredt. Samme teknologi kan på den annen side bli et uunnværlig hjelpemiddel for noen grupper, for eksempel blinde og svaksynte, og styrke deres deltakelse i det akademiske fellesskapet.
4.2.9 Digital suverenitet
Bevisstheten om samfunnets og institusjonenes sårbarhet overfor den teknologiske maktstrukturen er økende. Avhengigheten ble tydelig demonstrert i august 2025 da USA innførte sanksjoner mot dommere og aktorer i Den internasjonale straffedomstolen ICC, som reaksjon på at domstolen hadde utstedt en arrestordre på Israels statsminister (Sandven, 2026). I oktober 2026 utvidet USA sanksjonene mot domstolen (Heggland et al., 2026). Denne type politiske represalier synliggjør den digitale avhengigheten både Europa og andre deler av verden har til USA, og innebærer i seg selv et demokratisk problem. Enkeltpersoner, bedrifter, organisasjoner, institusjoner eller stater som kommer på kant med noen som sitter på en slik makt, risikerer å bli utsatt for det samme.
Amerikanske myndigheters kontroll over viktig digital infrastruktur ble også åpenbar i juni 2026, da de brått innførte strenge eksportrestriksjoner på Anthropics nyeste språkmodeller. Restriksjonene ble opphevet et par uker senere, men bidro til å understreke behovet for å redusere avhengigheten til amerikanske teknologiselskaper (MarketScale Newsroom, 2026).
Digital suverenitet er et vidt begrep som brukes om staters og institusjoners evne til å ha kontroll over egne data, digitale infrastrukturer og teknologiske valg. Digital suverenitet kan vurderes på ulike nivåer, som for eksempel europeisk, nasjonalt, sektorielt, institusjonelt og ned til enkeltindivider.
Forretningsmodellene til kommersielle KI-leverandører bygger ofte på lite transparent innsamling av data og lukkede kildekoder. Dette står i spenning med åpenhetsidealene til universiteter og høyskoler, som skal tilgjengeliggjøre kunnskap som et felles gode.
Dette reiser spørsmål om hvordan universitets- og høyskolesektoren kan sikre akademisk frihet, verdigrunnlag, etisk forsvarlig bruk, stabil tilgang til KI-systemer og langsiktig forutsigbarhet i et mer spent geopolitisk landskap.
4.2.9.1 Avhengighet, innelåsning og sårbarhet
Utvikling og drift av avanserte språkmodellbaserte KI-systemer er konsentrert hos et begrenset antall teknologiselskaper, primært lokalisert i USA, men også i Kina. Teknologien inngår i en bredere internasjonal konkurranse om økonomisk og strategisk dominans. Dette utgjør en geopolitisk kontekst der tilgang til, kontroll over og regulering av KI blir et strategisk instrument på linje med annen kritisk infrastruktur. For universitets- og høyskolesektoren innebærer dette at institusjonene kan bli avhengige av teknologier, infrastrukturer og forretningsmodeller som er underlagt andre staters lovgivning, verdimessige prioriteringer og sikkerhetspolitiske vurderinger.
4.2.9.2 Datasikkerhet
Universitets- og høyskolesektorens forvaltning av store datamengder gjør den utsatt for komplekse trusler, herunder målrettede cyberangrep fra så vel kriminelle grupper som statlige aktører. Nesten all bruk av KI-systemer innebærer anvendelse av store datamengder med påfølgende utfordringer for informasjonssikkerhet og personvern. Ved bruk av skytjenester kan data bli lagret i andre land og under andre lands jurisdiksjoner. Dette reiser spørsmål om hvem som har kontroll over og tilgang til dataene, og om de kan misbrukes, for eksempel til trening av KI-modeller uten samtykke.
4.2.9.3 Muligheter for verdiskaping
Ferdigutviklede KI-løsninger levert av store teknologiselskaper gir umiddelbare fordeler i form av tilgang til avanserte kapabiliteter og reduserte utviklingskostnader. Denne tilgjengeligheten kan svekke insitamentene for å utvikle institusjonenes egen forsknings- og utviklingskapasitet, kompetansebygging, innovasjon og verdiskaping. Bruk av kommersielle KI-tjenester kan dermed redusere KI-teknologiens potensial for også å kunne realiseres som lokal innovasjon bl.a. gjennom samspill mellom universitets- og høyskolesektoren og næringslivet.
4.2.10 Konklusjon
Gjennomgangen viser at de etiske og strategiske problemstillingene ved utvikling og bruk av KI ligger på flere nivåer. Noen problemstillinger gjelder systemene selv: De er vanskelige å forstå og etterprøve, de kan forfølge andre mål enn de tiltenkte, og de kan videreføre skjevheter og gi uriktige svar. Andre gjelder grunnlaget systemene bygger på, som bruken av personopplysninger og åndsverk, forbruket av energi, vann og mineraler, og arbeidet som utføres. En tredje gruppe gjelder virkningene på mennesker og fellesskap: tillit og relasjoner i læringsmiljøet, sosial ulikhet, avhengighet og en overdreven tro på egen kompetanse. Den fjerde gjelder samfunnet: maktkonsentrasjon, vilkårene for offentlig samtale og akademisk frihet, og avhengighet av et fåtall utenlandske leverandører.
Disse problemstillingene er ikke nødvendigvis argumenter mot å ta i bruk KI i høyere utdanning. Men de viser noe av hva som må til for at det skal være forsvarlig. Forutsetningene kan endre seg over tid. Flere av utfordringene har også en indre spenning. Teknologien som kan forsterke skjevheter, kan også gjøre skjevhetene lettere å oppdage. Systemene som kan svekke læring, kan også gi studenter tilbakemelding og støtte de ellers ikke ville fått. Prinsippene for pålitelig KI, som dette kapittelet tok utgangspunkt i, gir en ramme for å veie slike hensyn mot hverandre. Prinsippene selv kan ikke alltid oppfylles fullt ut samtidig, og avveiningene må gjøres i lys av alternativene. De juridiske rammene som gjennomgås i det følgende, setter grensene for dette handlingsrommet.
4.3 Juridiske rammer
Ved utvikling og bruk av KI-systemer er det mange forskjellige juridiske rammer å ta hensyn til. De fleste er grunnet i europeisk regelverk. Den norske forvaltningsloven står sentralt ved bruk av KI-systemer til vedtak. Rettskildene har ulike formål og pliktsubjekter – noe som medfører at de ikke samhandler som et velfungerende puslespill. I tillegg er det store utviklinger på hvert og ett av de relevante rettsområdene. KI er en ny teknologi som krever nye tolkninger og nye regler. Dette betyr at de juridiske rammene både er komplekse og ustabile.
En juridisk vurdering er nødvendig når en institusjon tilbyr sine studenter og ansatte et KI-system, når systemene brukes til læringsanalyse, undervisningsstøtte eller kvalitetsarbeid, eller når et KI-system blir brukt som hjelpemiddel til å fatte vedtak. Universiteter og høyskoler treffer en rekke enkeltvedtak, blant annet om opptak, sensur, annullering av eksamen, utestengelse og skikkethet.
Noen av de viktigste juridiske rammene for bruk av KI-systemer blir beskrevet i det følgende. Beskrivelsene er på et overordnet nivå og er ikke ment å være komplette eller detaljerte. Konkrete tolkninger og anvendelser av regelverkene blir gitt der hvor de har betydning for spørsmålene i utredningen. De senere kapitlene ser nærmere på spesifikke juridiske problemstillinger, særlig innen vurdering (jf. kap. 7) og forvaltning av KI-systemer (jf. kap. 8). For mange av spørsmålene utvalget tar opp, er rettstilstanden uavklart. Noen anvendelser kan utvalget legge til grunn med høy grad av sikkerhet, mens i andre situasjoner vil institusjonenes anvendelse av regelverket avhenge av egenskaper ved teknologien som brukes og andre variable forhold. Fremstillingen gjengir rettstilstanden slik den er i dag, og peker på pågående endringsprosesser og tolkningsutvikling som kan føre til endringer.
4.3.1 Menneskerettigheter
4.3.1.1 Europarådets rammekonvensjon om kunstig intelligens
Europarådets rammekonvensjon om kunstig intelligens er den første juridisk bindende internasjonale traktaten om KI. Den ble adoptert 17. mai 2024 av Europarådets ministerkomité. Norge, medlemslandene i EU og sytten andre land har signert konvensjonen. Den er utviklet som et globalt rammeverk for å sikre at all aktivitet knyttet til utvikling, bruk og styring av KI-systemer skjer i tråd med menneskerettighetene, demokratiske verdier og rettsstatsprinsipper.
Formålet til rammekonvensjonen er å etablere felles prinsipper og forpliktelser for stater, slik at KI-systemer ikke undergraver demokratiske prosesser, bidrar til diskriminering eller påfører annen skade. Samtidig har den som formål å fremme ansvarlig innovasjon.
Konvensjonen omfatter en rekke grunnleggende prinsipper og krav. Den gir blant annet prinsipper om transparens, ansvarlighet, ikke-diskriminering, respekt for menneskelig verdighet og trygg innovasjon. Konvensjonen stiller krav om risiko- og konsekvensvurderinger for KI-systemer, og den etablerer rettigheter og klagemekanismer for personer som påvirkes av automatiserte beslutningsprosesser. Den adresserer med andre ord mange av de etiske og juridiske problemstillingene som KI reiser i høyere utdanning.
Europarådets rammekonvensjon om KI skaper ikke nye menneskerettigheter, men skal bidra til at eksisterende forpliktelser, blant annet etter Den europeiske menneskerettighetskonvensjonen (EMK) (jf. kap. 4.3.1.2), etterleves når KI-systemer tas i bruk (Stoyanova, 2026). Europarådets styringskomité for menneskerettigheter har også utarbeidet en håndbok om hvordan EMK får anvendelse på KI i utvalgte sektorer, blant annet utdanning (Steering Committee for Human Rights, u.å.).
Norge har foreløpig ikke ratifisert konvensjonen siden denne er knyttet til arbeidet med en ny KI-lov, som skal gjennomføre EUs KI-forordning i norsk rett (jf. kap. 4.3.2). I høringsnotatet vurderer Digitaliserings- og forvaltningsdepartementet at Norge fullt ut vil oppfylle konvensjonens krav når KI-loven er vedtatt (Digitaliserings- og forvaltningsdepartementet, 2025). Departementet viste til at konvensjonen er en minstestandard som gir statene stor fleksibilitet, og at mange av forpliktelsene allerede er oppfylt gjennom teknologinøytralt regelverk. For offentlig sektor legger departementet til grunn at kravene om klagemulighet og informasjon i stor grad følger implisitt av forvaltningsloven og særlovgivningen. (Digitaliserings- og forvaltningsdepartementet, 2025, kap. 20.2).
Det er likevel ikke gitt at dette er tilstrekkelig. Konvensjonen gjelder all bruk av KI-systemer som kan berøre menneskerettigheter, demokrati og rettsstat, mens forordningen er et produktsikkerhetsregelverk der de fleste og sterkeste kravene er knyttet til nærmere angitte høyrisikosystemer (Stoyanova, 2026). Ifølge et høringsinnspill til regjeringen er KI-forordningens regler om klage, forklaring og informasjon snevrere enn rammekonvensjonens. I tillegg blir rettighetene i offentlig sektor mindre forutsigbare når de må utledes av generelle saksbehandlingsregler (Arnesen et al., 2025). Det kan føre til et behov for å supplere KI-loven med regler i annen lovgivning.
4.3.1.2 Den europeiske menneskerettighetskonvensjon
Den europeiske menneskerettighetskonvensjonen (EMK) ble vedtatt av Europarådet i 1950 og har som formål å beskytte grunnleggende menneskerettigheter og friheter. I Norge er EMK gjennomført gjennom lov 21. mai 1999 om styrking av menneskerettighetenes stilling i norsk rett, og har forrang over andre lover ved rettskonflikter (menneskerettsloven). Dersom en anser seg krenket av den norske staten i strid med EMK, kan en klage til Den europeiske menneskerettighetsdomstolen når nasjonale rettsmidler er uttømt.
EMK art. 8 regulerer retten til privatliv. Den europeiske menneskerettighetsdomstolen tolker begrepet om privatliv bredt, slik at det blant annet inkluderer digital sporing og omfattende behandling av personopplysninger.
EMK art. 8 fungerer som en overordnet rettighet, mens konkrete rettigheter knyttet til personopplysninger i hovedsak reguleres av personvernforordningen (GDPR), se kapittel 4.3.3. Samtidig har Den europeiske menneskerettighetsdomstolen bidratt med relevant rettspraksis. Blant annet har domstolen funnet at videoovervåkning av forelesningssaler ved et universitet var et inngrep i de ansattes privatliv («Antović og Mirković mot Montenegro», 2017), at vern av personopplysninger er en grunnleggende del av retten til privatliv («S. og Marper mot Storbritannia», 2008), og at bruk av ansiktsgjenkjenning er særlig inngripende («Glukhin mot Russland», 2023).
Også andre rettigheter har betydning for bruk av KI-systemer i høyere utdanning. Retten til utdanning etter EMK første tilleggsprotokoll art. 2 gjelder for høyere utdanning, og setter rammer for bruk av KI-systemer i opptak, vurdering og utestenging. Diskrimineringsforbudet i EMK art. 14 er relevant når KI-systemer behandler studentgrupper ulikt, for eksempel ved skjevheter i automatisert vurdering. Ytringsfriheten etter EMK art. 10 omfatter akademisk frihet og retten til å motta informasjon. Den kan i tillegg berøres av overvåkning og av systemer som filtrerer eller rangerer kilder. Retten til rettferdig rettergang og til et effektivt rettsmiddel etter EMK art. 6 og 13 kan få betydning i fuskesaker der KI-systemer brukes som bevis.
4.3.2 KI-forordningen
4.3.2.1 Innledning
Forordningen om kunstig intelligens, KI-forordningen, ble vedtatt i EU i 2024 og gjort gjeldende i EU fra 2. august 2026. Reglene om høyrisikosystemer i utdanning og regulatoriske sandkasser har ennå ikke trådt i kraft, men er planlagt å gjøre det fra 2. desember 2027 (EU-kommisjonen, 2026e).3 Regjeringen jobber med å gjennomføre KI-forordningen i norsk rett, og en egen norsk KI-lov er ventet å bli behandlet i løpet av 2027.4 Nasjonal kommunikasjonsmyndighet (Nkom) blir det nasjonale kontaktpunktet som koordinerende markedstilsynsmyndighet.
4.3.2.2 Hva regulerer den?
Formål og type regulering
Forordningen har som mål å legge til rette for at KI blir brukt på en måte som beskytter grunnleggende rettigheter, slik som aspekter ved studentenes utdanning og deres privatliv. Forordningen deler KI-systemer inn etter risikonivåer, fra minimal risiko til uakseptabel risiko, avhengig av hva systemene er laget eller satt i drift for å gjøre. Risikoklassifiseringen gir opphav til ulike sett med tillatelser og forpliktelser, fra ingen reguleringer til forbud.
KI-forordningen er i utgangspunktet en produktlovgivning som lager et rammeverk for utvikling, markedsføring og bruk av KI-systemer i EUs indre marked. Den fastsetter harmoniserte regler for transparens, og hvordan KI-systemer kan omsettes, settes i drift og anvendes i unionen. Videre inneholder forordningen regler om overvåkning, markedsovervåkning, forvaltning og håndheving, og den fremmer tiltak som er ment å støtte innovasjon.
KI-systemer og KI-modeller til allmenne formål
KI-forordningen gjelder i hovedsak for KI-systemer, som er definert som et maskinbasert system som er utformet for å fungere med en varierende grad av autonomi, og som etter idriftsettelse kan vise tilpasningsevne. Et KI-system skal, basert på inndata, kunne generere utdata, slik som prediksjoner, innhold, anbefalinger eller beslutninger, som kan påvirke fysiske eller virtuelle miljøer (KI-forordningen art. 3 nr. 1). De KI-systemene som ikke oppfyller denne definisjonen, faller utenfor forordningens virkeområde.
I tillegg regulerer forordningen KI-modeller til allmenne formål. Store bilde- og språkmodeller kan brukes til en uavgrenset mengde formål og regnes derfor som KI-modeller til allmenne formål. Slike grunnmodeller kan brukes i KI-systemer med spesifikke formål, for eksempel som «hjernen» i en digital undervisningsassistent.
Hvem KI-forordningen gjelder for
Forordningen gjelder først og fremst for profesjonelle aktører, slik som leverandører og idriftsettere av KI-systemer, samt importører og distributører. En leverandør utvikler eller får utviklet et KI-system eller en KI-modell til allmenne formål, og bringer den i omsetning eller tar i bruk KI-systemet under eget navn eller varemerke (KI-forordningen art. 3 nr. 3). For eksempel tar Sikt og UiO i bruk ulike KI-modeller for å levere KI-systemer under egne navn (Sikt KI og GPT UiO), og blir dermed leverandører etter KI-forordningen, med de forpliktelser som følger med. Institusjonene inntar rollen som idriftsetter når de innenfor sin virksomhet bruker et KI-system, som er utviklet eller tilpasset av en leverandør.
Forordningen gjelder ikke for fysiske personer som bruker KI-systemer for ikke-profesjonell aktivitet. Dette betyr at studenter som brukere ikke er pliktsubjekter under KI-forordningen når de bruker KI-systemer til studiene sine. De er da å regne som sluttbrukere eller «berørte personer». Denne statusen gir studentene flere rettigheter, for eksempel en rett til forklaring dersom en beslutning som påvirker dem, er basert på utdata fra et høyrisikosystem.
Unntak, herunder forskning
Forordningen har to unntak som er særlig viktige for universitets- og høyskolesektoren. Det første gjelder utviklingsfasen. Forordningen gjelder i utgangspunktet ikke ved forskning-, testing- eller utviklingsaktivitet før et KI-system tas i bruk. Men hvis en institusjon tester et KI-system under virkelige forhold, gjelder forordningen likevel.5
Det andre gjelder forskningsformålet. KI-forordningen gjelder ikke for KI-systemer eller -modeller som er spesifikt utviklet og tatt i bruk med forskning og vitenskapelig utvikling som eneste formål. Hvis et slikt system senere brukes til andre formål, for eksempel i undervisning eller vurdering, gjelder KI-forordningen fullt ut.
Krav til KI-kompetanse
Leverandører og idriftsettere av KI-systemer må i størst mulig grad treffe tiltak for å sikre et tilstrekkelig nivå av KI-kompetanse hos ansatte og andre som arbeider på deres vegne. Dette kan være både vitenskapelig og administrativt ansatte. Kompetansetilbudet må ta hensyn til målgruppenes kunnskap om teknologi, erfaring og utdanning, samt konteksten KI-systemet skal brukes i. Europarådet har utarbeidet Guidelines for developing and promoting the human dimension for AI literacy (Europarådet, 2026, jf. EU-kommisjonen, 2025c; UNESCO, 2024). Studentene skal for eksempel kunne forstå hvordan beslutninger påvirker dem når disse er tatt med hjelp av et KI-system.
4.3.2.3 Risikobasert tilnærming
KI-forordningen har en risikobasert tilnærming til mangfoldet av systemer som er og vil komme i omløp. Den deler KI-systemer inn etter grad av risiko for skadelig innvirkning på EUs grunnleggende verdier, og her er utdanning berørt på flere nivåer.
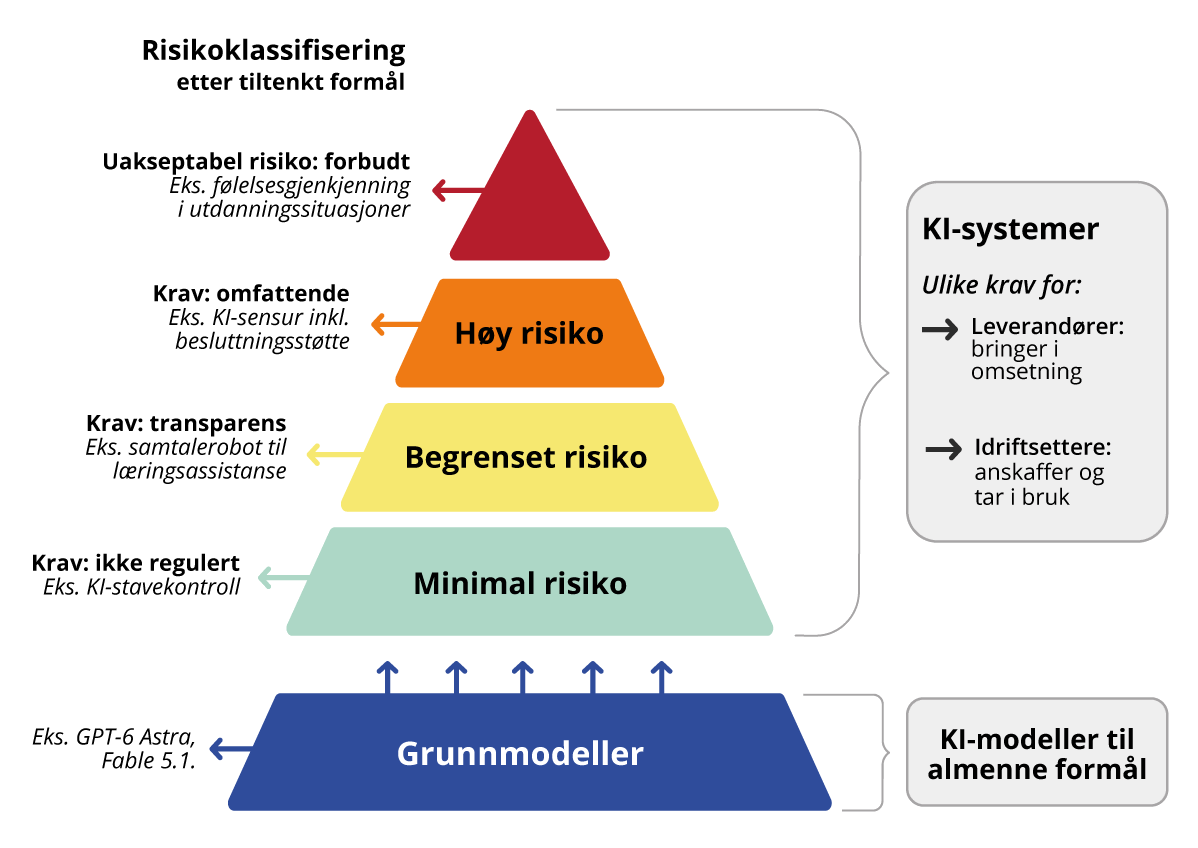
Figur 4.2 KI-forordningens risikoklassifikasjoner for KI-systemer; og modeller til allmenne formål
Forbudte KI-systemer med uakseptabel risiko
KI-systemer som innebærer en uakseptabel risiko, er forbudte, jf. KI-forordningen art. 5. For høyere utdanning er det spesielt relevant at sosial rangering er forbudt, og i utdanningsinstitusjoner og på arbeidsplasser er det forbudt å gjenkjenne følelser. Det er i tillegg forbudt å klassifisere personer basert på deres sosiale adferd eller personlighetstrekk, samt å lage biometrisk kategorisering for å avlede beskyttede karakteristikker slik som rase og politiske meninger.
KI-systemer med høy risiko, inkludert visse KI-systemer innen utdanning
Et KI-system klassifiseres som et høyrisiko-system dersom det kan innebære høy risiko for helse, sikkerhet eller grunnleggende rettigheter, herunder utdanning. Av særlig relevans for høyere utdanning, regnes et system som høy risiko dersom det er beregnet for bruk til opptak til utdanning, vurdering av studenter, sensur og fusk (KI-deteksjon), se KI-forordningen art. 6 nr. 2, jf. vedlegg III nr. 3. Hensikten er å beskytte studenter og søkere.
Hvis et KI-system klassifiseres som høy risiko, må systemet oppfylle en rekke krav, med ulike forpliktelser for leverandører og idriftsettere. Høyrisikosystemer skal overholde krav til tilstrekkelig robusthet, sikkerhet og nøyaktighet (se Boks 4.3). EU-kommisjonen har laget et utkast til veileder om klassifisering av høyrisikosystemer, herunder av vilkårene for å bli unntatt slik klassifisering (EU-kommisjonen, 2026d).
Boks 4.3 Krav til KI-systemer med høy risiko
Høyrisikosystemer må oppfylle krav om blant annet
-
risikohåndteringssystem etter art. 9, som blant annet skal adressere kjente og forutsigbare risikoer knyttet til systemets bruk
-
dataforvaltning etter art. 10, med krav til datakvalitet og egnethet til treningsdata. KI-systemer skal trenes på relevante, representative, feilfrie og komplette data for å redusere risikoen for skjevheter og diskriminering.
-
teknisk dokumentasjon etter art. 11, om hvordan systemet virker, for å kunne forstå, verifisere og etterprøve samsvar med kravene
-
hendelseslogger etter art. 12 (jf. art. 19 og 26 nr. 6), for å sikre sporbarhet for å blant annet identifisere risikosituasjoner
-
at mennesker skal kunne kontrollere systemet etter art. 14, slik at mennesker kan overvåke, forstå og effektivt overstyre systemet, blant annet for å forhindre at diskriminerende eller urettmessige utfall blir stående
-
nøyaktighet, robusthet og cybersikkerhet etter art. 15, slik at KI-systemet skal være så motstandsdyktig som mulig mot feil, mangler eller uoverensstemmelser
-
innskjerpede krav til åpenhet og informasjon for høyrisikosystemer etter art. 13 og 501
-
rett til forklarbarhet etter art. 86
Universiteter og høyskoler skal i tillegg, som idriftsettere av en offentlig tjeneste, gjennomføre en forhåndsvurdering av konsekvenser for grunnleggende rettigheter, som bruken av et slikt høyrisikosystem kan medføre (KI-forordningen art. 27). Konsekvensanalysen forkortes som FRIA (fundamental rights impact assessment) og kan utføres sammen med en vurdering av personvernkonsekvenser (DPIA eller data protection impact assessment). En slik FRIA skal gjennomføres før høyrisikosystemet settes i drift. Formålet med en FRIA er at universiteter og høyskoler skal identifisere spesifikke risikoer for rettighetene til studenter eller arbeidstakere som sannsynligvis vil bli berørt, og identifisere tiltak som skal treffes hvis disse risikoene oppstår.
1 Regelen krever klar og forståelig informasjon om systemets funksjoner, kapasiteter og begrensninger, samt informasjon om hvordan KI-beslutninger tas og hvilke implikasjoner de kan ha. Dette inkluderer, når det er hensiktsmessig, spesifikasjoner for inndataene eller eventuell annen relevant informasjon om de trenings-, validerings- og testdatasettene som brukes, tatt i betraktning det tiltenkte formålet med høyrisikosystemet. I tillegg skal det, dersom det er relevant, foreligge informasjon som gjør det mulig for idriftsettere å tolke utdataene fra høyrisikosystemet og bruke dem på en hensiktsmessig måte. Disse kravene er ment å begrense KI-systemers utfordringer knyttet til etterprøvbarhet og transparens.
Det kan være mulig å få unntak fra klassifisering som høyrisikosystem, men nåløyet er lite. KI-systemer som i de nevnte kontekstene brukes innenfor utdanning, kan få unntak dersom de ikke utgjør en vesentlig risiko for skade på studentenes grunnleggende rettigheter, og ikke i vesentlig grad påvirker resultatet av en beslutningsprosess, jf. KI-forordningen art 6 nr. 3. I henhold til klassifisering som høyrisikosystem har det dermed mye å si om et KI-system kun brukes til støtte (som her betyr en rent forberedende oppgave). Et eksempel på dette er å sende et brev i opptakssystemet som ikke materielt påvirker beslutningen som blir tatt av et menneske, i motsetning til KI-støtte til en beslutning om hvorvidt en kandidat blir tatt opp til et studieprogram. Dersom KI-systemet er med på å forberede beslutninger, innebærer det høy risiko. Menneskelig involvering i seg selv er ikke tilstrekkelig for å oppfylle de snevre unntaksbestemmelsene (EU-kommisjonen, 2026d). Dersom en leverandør mener at et KI-system innen utdanning ikke medfører høy risiko, skal den dokumentere risikovurderingen før systemet bringes i omsetning eller tas i bruk (KI-forordningen art. 6 nr. 4). På anmodning fra nasjonale myndigheter skal leverandøren fremlegge dokumentasjonen for vurderingen.
KI-systemer med begrenset risiko
KI-systemer med begrenset risiko er underlagt forpliktelser om transparens i KI-forordningen art. 50. Dette er KI-systemer som er rettet mot direkte interaksjon med fysiske personer. Disse skal utvikles på en slik måte at brukeren blir opplyst om at de interagerer med et KI-system.
4.3.2.4 KI-modeller til allmenne formål
KI-forordningens kapittel V regulerer KI-modeller til allmenne formål. Grunnmodeller som OpenAIs GPT-6 Astra og Anthropics Fable 5.1. havner i denne kategorien, ettersom de kan brukes til et vidt spekter av ulike formål. En KI-modell til allmenne formål kan brukes med brukergrensesnitt (for eksempel appene ChatGPT eller Claude) eller integreres i andre KI-systemer.
Noen KI-modeller til allmenne formål regnes som å ha en «systemisk risiko». Dette gjelder modeller som har et stort nedslagsfelt og som er utviklet med mye regnekraft, slik som de største, kommersielle grunnmodellene. Modellene med systemisk risiko må oppfylle tilleggskrav som bidrar til å redusere risikonivået. Dette inkluderer spesialtilpassede krav til åpenhet, for å begrense KI-modellers utfordringer med etterprøvbarhet og transparens.
Universiteter og høyskoler kan gi tilgang til slike KI-modeller til sine ansatte og studenter. Det er da institusjonenes ansvar å sikre at modellene brukes på en trygg og lovlig måte. Dette betyr at de bør ha interne retningslinjer for bruk av KI-systemer, sikre at ansatte bruker KI-systemer på lovlig vis, spesielt med hensyn til personvern og opphavsrett, men også ved å unngå praksis som ville ført til tilsvarende automatiserte beslutninger. De bør også sørge for opplæring slik at ansatte forstår når og hvordan KI-systemer kan brukes, samt risikoer knyttet til blant annet feilinformasjon, skjevheter og fortrolighet.
Når universiteter og høyskoler gir studenter og ansatte brukerlisenser for kommersielle KI-systemer som bygger på modeller til allmenne formål, gjelder krav som idriftsetter av KI-systemer. Dersom de selv utvikler systemer som bygger på modeller til allmenne formål, gjelder egne krav som leverandør av KI-systemer.
4.3.2.5 Innovasjon, regulatoriske sandkasser m.m.
KI-forordningen åpner også opp for innovasjon. For å legge til rette for dette, skal hvert medlemsland minst ha én såkalt regulatorisk sandkasse. Dette er et kontrollert miljø for innovasjon som gir muligheten til å utvikle, trene, teste og validere KI-systemer i en begrenset tidsperiode, før de tas i bruk. Sandkasser kan omfatte testing under virkelige forhold, under tilsyn. Formålet er å støtte utveksling av beste praksis gjennom samarbeid med myndigheter, å fremme innovasjon og konkurranseevne, å bidra til evidensbasert lovgivningsmessig læring og å framskynde adgangen til EU-markedet for KI-systemer. Datatilsynet har hatt flere regulatoriske sandkasser knyttet til KI og personvernforordningen, blant annet for NTNU da de skulle innføre Microsoft Copilot (NTNU, 2024) og for Politihøgskolen, som handlet om et KI-system for å identifisere og forhindre grooming på nettet (Datatilsynet, 2024).
For mer informasjon om hvilken betydning KI-forordningen har for norsk høyere utdanning, se HK-dirs veileder (HK-dir, 2026a).
4.3.3 Personvern
Retten til privatliv og til å bestemme over opplysninger om en selv er vernet gjennom den europeiske menneskerettskonvensjonen (EMK) art. 8 om retten til respekt for privatliv og familieliv, og tilsvarende i Grunnloven § 102.
Mens EMK og Grunnloven gir personvernet en overordnet forankring, inneholder EUs personvernforordning, General Data Protection Regulation (GDPR), et mer detaljert regelverk. Forordningen er gjennomført i norsk rett gjennom personopplysningsloven av 15. juni 2018 nr. 38. Som del av rammeverket for å beskytte individers personvern, inneholder GDPR også regler om automatisert saksbehandling (jf. kap. 4.3.4).
Sentralt i GDPR står begrepet «personopplysning». Dette er «enhver opplysning om en identifisert eller identifiserbar fysisk person («den registrerte») etter GDPR art. 4 nr. 1 (personvernforordningen).6 I norsk høyere utdanning behandles store mengder personopplysninger. Disse omfatter alt fra grunnleggende personopplysninger om studenter og ansatte som navn og fødselsnummer, til studieadministrative opplysninger som opptaksgrunnlag, eksamensbesvarelser, vurderingsnedtegnelser fra sensor, karakterer, studieprogresjon og fravær. Det kan være kameraovervåkning på campus og opptak av forelesninger eller eksamener. Noen ganger kan personopplysningene være sensitive, slik som helseopplysninger ved behov for tilrettelegging.
GDPR avgjør hvorvidt og hvordan slike personopplysninger kan behandles, og etter hvilke sentrale prinsipper (se Boks 4.4). Noen av de mest grunnleggende bestemmelsene blir beskrevet i det følgende, med høyere utdanning som anvendelseskontekst.
Boks 4.4 Sentrale prinsipper i GDPR
GDPR art. 5 fastsetter grunnleggende prinsipper for behandling av personopplysninger:
-
lovlighet, rettferdighet og åpenhet: personopplysninger skal ha et gyldig rettslig grunnlag (lovlig), ikke brukes på en urimelig eller uventet måte overfor den det gjelder (rettferdig), og den registrerte skal få klar og forståelig informasjon om behandlingen (åpen)
-
formålsbegrensning: personopplysninger skal kun samles inn for spesifikke, uttrykkelig angitte og berettigede formål og ikke viderebehandles på en måte som er uforenlig med disse formålene
-
dataminimering: personopplysninger skal være adekvate, relevante og begrenset til det som er nødvendig for formålene de behandles for
-
riktighet: personopplysninger skal være korrekte og om nødvendig oppdaterte
-
lagringsbegrensning: personopplysninger skal lagres slik at det ikke er mulig å identifisere de registrerte i lengre perioder enn det som er nødvendig for formålene som personopplysningene behandles for
-
integritet og konfidensialitet: personopplysninger skal behandles på en måte som sikrer tilstrekkelig sikkerhet
Behandlingsgrunnlag
Etter GDPR art. 6 må all behandling av personopplysninger ha et gyldig behandlingsgrunnlag, for eksempel en rettslig forpliktelse eller et samtykke.
Universiteter og høyskoler kan etter universitets- og høyskoleloven § 2-8 behandle studenters personopplysninger når det er nødvendig for å utføre deres oppgaver etter loven, slik som for eksempel for lagring av eksamenskarakterer. I høyere utdanning vil behandlingen ofte være nødvendig for å oppfylle en rettslig forpliktelse.
Denne generelle hjemmelen er ikke tilstrekkelig for inngripende former for behandling av personopplysninger: Jo mer inngripende behandlingen er, desto klarere og tydeligere må både lovhjemmelen og de tilhørende vilkårene være (personvernforordningen art. 6 nr. 3 jf. fortalepunkt 41; Prop. 56 LS (2017–2018)). Den enkelte student skal kunne forstå hva som behandles, hvorfor, og hvordan. Dette gjelder etter utvalgets vurdering for eksempel ved tilsyn på digitale hjemmeeksamener, se kapittel 7.4.2.4.
Studentens samtykke er sjelden egnet som behandlingsgrunnlag, ettersom GDPR art. 7 krever at samtykket skal være frivillig, informert og uttrykkelig. I et asymmetrisk maktforhold mellom en institusjon og student vil et samtykke normalt ikke kunne regnes som reelt frivillig, for eksempel når det blir en forutsetning for å gjennomføre studiet. Institusjonene må derfor vurdere om de har et egnet behandlingsgrunnlag.
Institusjonene må kunne dokumentere at deres bruk av KI-systemer er lovlig, nødvendig og forholdsmessig. Dette inkluderer krav til innebygd personvern etter GDPR art. 257, kompetanseheving samt aktiv involvering av personvernombudet. Dersom en institusjon kjøper tilgang til en KI-modell eller et KI-system fra en leverandør, må den som behandlingsansvarlig inngå en databehandleravtale med leverandøren som behandler personopplysninger på deres vegne (GDPR art. 24 og 28; jf. Datatilsynet, u.å.-b).
Sikker bruk av data
Når universiteter og høyskoler behandler personopplysninger ved hjelp av tredjeparter eller ekstern skylagring, øker risikoen for datalekkasjer og ikke-autorisert tilgang. Selv tilsynelatende anonymiserte trenings- eller testdata kan ende med å bli sporet tilbake til enkeltpersoner, noe som innebærer en risiko for re-identifisering (Barberá, 2025, s. 32; Weitzenboeck et al., 2022; Yan et al., 2024). Etter GDPR art. 32 plikter institusjonene å sikre et passende sikkerhetsnivå basert på risikovurderinger. Når for eksempel studentarbeider lastes opp i eksterne KI-systemer, kan det innebære overføring av personopplysninger til tredjeland eller kommersielle aktører. Etter GDPR kapittel V krever slik overføring særskilt rettslig grunnlag og tilstrekkelige garantier.8 Lukkede systemer med kontroll over datalagring kan redusere risikoen.9
Personvernkonsekvensvurdering
Det kan være krav om at institusjonene gjennomfører en personvernkonsekvensvurdering (DPIA) etter GDPR art. 35. Dette er påkrevd når behandlingen sannsynligvis vil medføre høy risiko for de registrertes rettigheter og friheter, blant annet ved bruk av ny teknologi slik som KI-systemer. Dette betyr at terskelen er veldig lav for at det er påbudt å utarbeide en DPIA ved bruk av KI. En DPIA skal beskrive formålet med behandlingen av personopplysninger, omfang og nødvendighet; risikoen for studentenes rettigheter; og tiltakene for å redusere risikoen, slik som dataminimering og sikkerhet.
Grunnleggende spenninger mellom KI og personvern
På grunn av egenskaper ved teknologien setter KI personvernet og kravene i GDPR under press på flere områder. Mens GDPR legger til grunn at minst mulig personopplysninger skal innhentes og at man skal ha kontroll over dataene, trenger KI-systemer store mengder treningsdata for å fungere best mulig. I tillegg kan personopplysninger bli delt ved bruk av systemene. Dataminimeringsprinsippet (GDPR art. 5 nr. 1 bokstav c) står dermed i spenning med en grunnleggende forutsetning for å utvikle KI-systemer.
I tillegg skal personopplysninger samles inn for spesifikke, uttrykkelig angitte og berettigede formål etter formålbegrensingsprinsippet (GDPR art. 5 nr. 1 bokstav b). KI-systemer kan i utgangspunktet brukes til behandling av personopplysninger, men gjenbruk av personopplysninger til analyser utenfor formålet eller trening av KI-systemer forutsetter et utvidet formål og behandlingsgrunnlag.10
Videre har den registrerte rett til innsyn, retting og sletting av personopplysningene sine. De statistiske mønstrene som modellen består av, gir imidlertid lite grunnlag for å se hva slags personopplysninger modellen sitter på. Når en modell først er trent, er det heller ikke noen enkel måte å slette personopplysningene som implisitt er bygget inn i modellen. Prinsippet om lagringsbegrensning står dermed også i spenning med hvordan KI-systemene blir utviklet.
Til tross for disse iboende spenningene, legger KI-forordningen i art. 2 og fortalepunkt 10 til grunn at GDPR gjelder fullt ut for KI-systemer og -modeller. Regelverkene er altså komplementære: mens GDPR i hovedsak regulerer individers personvern og rettigheter i møte med KI-systemer, er KI-forordningen en produktlovgivning som regulerer hvilke produkter som kan settes i drift og under hvilke forutsetninger (jf. kap. 4.3.2). Samtidig fastsetter KI-forordningen risikoreduserende tiltak som kan begrense visse personvernutfordringer. I forslaget til EUs digitale omnibus er det i tillegg foreslått endringer i GDPR, blant annet for å få kravene til å stemme bedre overens med KI-forordningen og støtte KI-utvikling (EU-kommisjonen, 2026c).11 For konkrete anvendelser av GDPR i KI-kontekster viser utvalget til Datatilsynets regulatoriske sandkasser og rådgivende uttalelser (Datatilsynet, u.å.-a)
4.3.4 Forvaltningsrett
Den norske forvaltningsloven (1967) kommer til anvendelse når KI-systemer brukes i saksbehandlingen, for eksempel ved karaktersetting (et enkeltvedtak) eller karakterbegrunnelser. For lovens anvendelse på disse områdene viser utvalget til kapittel 7. Andre eksempler er institusjonenes enkeltvedtak om opptak, annullering av eksamen, utestengelse og skikkethet.
Stortinget vedtok en ny forvaltningslov i juni 2025, som er forventet å tre i kraft i 2027 (forvaltningsloven, 2025). I denne gjennomgangen viser utvalget til ny forvaltningslov.
Riktighet
Dersom KI-systemer brukes som beslutningsstøtte eller til å fatte beslutninger, er det særlig viktig å sikre at kravene til saklighet og likebehandling oppfylles.12
Utredningsplikten i ny forvaltningslov § 44 stiller krav om forsvarlig utredning og riktige avgjørelser, ettersom «[f]orvaltningsorganet skal sørge for at saken er forsvarlig utredet før det fatter vedtak». Dersom et KI-system skal brukes (som støtte) til å fatte et forvaltningsvedtak, innebærer dette høye krav til systemets kvalitet, med henblikk på hva slags vedtak som skal fattes og på hvilket grunnlag. Riktighet av utdata er også avhengig av datakvalitet, noe som følger av GDPR art. 5 nr. 1 bokstav d: personopplysninger som brukes i beslutningsprosesser, skal være korrekte og oppdaterte. I tillegg søker KI-forordningen å begrense skjevheter i treningsdata og diskriminering gjennom krav til datakvalitet og egnethet til treningsdata som skal være relevante, representative, feilfrie og komplette (se Boks 4.3).
Krav om åpenhet og begrunnelser
Dersom KI-systemer skal brukes til å fatte enkeltvedtak i offentlig forvaltning, må det fremdeles være mulig å begrunne vedtaket i tråd med retten til begrunnelse etter ny forvaltningslov §§ 56 og 57. En slik begrunnelse skal blant annet nevne hvilke faktiske omstendigheter som har hatt betydning for sakens utfall, og hvilke hensyn forvaltningsorganet særlig har lagt vekt på i sin vurdering. Begrunnelsen skal blant annet sette mottakeren i stand til å vurdere om vedtaket bør påklages.
Svekket eller manglende transparens i KI-systemer kan skape utfordringer for retten til å imøtegå det forvaltningsrettslige grunnlaget for et vedtak og den demokratiske legitimiteten til offentlige avgjørelser. Dersom mottakere av et vedtak ikke kan forstå eller etterprøve de vurderingene som ligger bak, kan det svekke både den enkeltes rettssikkerhet og tilliten til myndighetsutøvere. KI-systemers underskudd på transparens og etterprøvbarhet utfordrer dermed de grunnleggende rettssikkerhetsprinsippene som forvaltningsretten bygger på. Samtidig kan bruk av KI-systemer føre til bedre klarspråk i begrunnelser og økt detaljeringsnivå, og i denne sammenhengen et økt forståelsesnivå.
Det er også andre regelverk som setter rammer for når og hvordan man kan bruke KI-systemer, med henblikk på transparens og etterprøvbarhet. KI-forordningen inneholder blant annet et generelt krav om åpenhet, et innskjerpet åpenhetskrav for høyrisikosystemer og en rett til forklaring på individuelle avgjørelser av høyrisikosystemer (se Boks 4.3).13 Åpenhet er også regulert som et prinsipp i GDPR art. 5 nr. 1 bokstav a.14 Dette innebærer at den registrerte skal kunne forstå at sine personopplysninger behandles, hvorfor, hvordan og av hvem (GDPR art. 12–14).
Nye regler om automatisert saksbehandling
Den nye forvaltningsloven inneholder regler om automatisert saksbehandling. Disse er eksplisitt knyttet til GDPR art. 22 og nyere rettspraksis.15 Den bredere konteksten er demokratisk tillit til saksbehandlingen. Det blir relevant når utvalget senere i utredningen vurderer bruk av KI-systemer til automatisert sensur og karakterbegrunnelser, se kapittel 7.11.
De nye reglene i ny forvaltningslov §§ 11 til 13 handler om automatisering av saksbehandlingen (§ 11), rettigheter og plikter ved automatiserte avgjørelser omfattet av GDPR art. 22 (§ 12) og dokumentasjon av det rettslige innholdet i automatiserte saksbehandlingssystemer (§ 13). For å forstå rekkevidden av ny forvaltningslov § 12 og delvis § 11, er det først nødvendig å forstå noe av innholdet i GDPR art. 22.
GDPR art. 22 setter rammene for å treffe individuelle avgjørelser som utelukkende er basert på automatisert behandling, og som har rettsvirkning for fysiske personer.16 Merk at «avgjørelse» etter GDPR art. 22 er et mye videre begrep enn «vedtak» etter forvaltningsloven. For eksempel kan et forberedende, automatisert steg i saksbehandlingen være en «avgjørelse», dersom den har en reell virkning for en fysisk person.17 Reglene gjelder altså både for enkeltvedtak og andre avgjørelser som i betydelig grad påvirker studenter, ansatte eller andre. Det er ikke rettslig avklart om begrunnelser av vedtak, herunder karakterbegrunnelser, er å regne som avgjørelser etter GDPR 22, men utvalget legger til grunn at de kan være det (se kap. 7.11.2 om karakterbegrunnelser).
I nasjonal rett kan det åpnes for automatiserte avgjørelser.18 Den avgjørelsen gjelder for (f.eks. studenten) har flere rettigheter etter GDPR art. 22 nr. 3 (jf. Prop. 79 L (2024–2025), pkt. 8.1.2):19
-
Rett til menneskelig inngripen: studenten kan kreve at den automatiserte avgjørelsen vurderes av et menneske med tilstrekkelig faglig kunnskap og kompetanse.
-
Rett til å uttrykke sine synspunkter: dette må være en reell mulighet til å uttrykke synspunkter, som institusjonen må ta i betraktning og som eventuelt kan utløse nye undersøkelser.
-
Rett til å bestride avgjørelsen: denne innebærer at studenten må ha en rett til å få avgjørelsen prøvd på nytt, og er ivaretatt hvis det finnes en klagerett etter alminnelig forvaltningsrett (for sensur: særskilt regulert i universitets- og høykoleloven §§ 11-10 og 11-11).
I tillegg har EU-domstolen lagt til grunn at GDPR art. 15 gir en rett til forklaring når det treffes en automatisert avgjørelse (fastsatt i ny forvaltningslov § 12, se nedenfor).20
Boks 4.5 Automatisert saksbehandling i ny forvaltningslov
Ny forvaltningslov, som anslås å tre i kraft i 2027, inneholder en ny regulering av automatisert saksbehandling. Den bygger på gjeldende regler om automatiserte individuelle avgjørelser etter GDPR art. 22 (se ovenfor).1
-
Ny § 11 om automatisering av saksbehandlingen fastsetter at saksbehandling under vilkår kan automatiseres. Det rettslige grunnlaget som avgjørelsen bygger på, kan ikke være til hinder for automatisering. Regelen krever en særlig hjemmel for automatiserte avgjørelser som er omfattet av GDPR art. 22.
-
Ny § 12 om rettigheter og plikter ved automatiserte individuelle avgjørelser som er omfattet av GDPR art. 22:
-
Tiltak for å sikre at personopplysninger behandles på en sikker måte og at feil forebygges og rettes opp, at avgjørelsene ikke innebærer usaklig forskjellsbehandling, og at det brukes egnede matematiske og statistiske fremgangsmåter2
-
Rett til forklaring: skal både informere om selve avgjørelsen og sette mottakeren i stand til å forstå hvordan, og på hvilket grunnlag, avgjørelsen har blitt truffet. Forklaringen skal gis i en kortfattet og lett tilgjengelig form, dvs. ikke som en beskrivelse av en kompleks algoritme. Den kan være helt eller delvis automatisert. Forklaringen skal gis så snart som mulig etter at en automatisert avgjørelse er truffet. Den skal sørge for at mottakeren skal kunne ivareta sine rettigheter etter GDPR art. 22 nr. 3 (se ovenfor og EU-domstolens avgjørelse C-203/22 Dun & Bradstreet Austria, avsnitt 55–59 og 66). Merk at en slik forklaring ikke er det samme som en begrunnelse, selv om disse kan overlappe (Prop. 79 L (2024–2025), pkt. 8.1.2 og 8.5.3.3).3
-
Rett til manuell kontroll: den registrerte har en rett til å be om en manuell kontroll som skal ivareta den enkeltes rettssikkerhet, sikre riktige avgjørelser og fremme tillit til forvaltningen, og sikre rettighetene etter GDPR art. 22 nr. 3 (se ovenfor). Retten er tett knyttet til retten til menneskelig inngripen og skal ivareta retten til å utrykke sine synspunkter.4
-
-
Ny § 13 om en dokumentasjons- og offentliggjøringsplikt: denne plikten krever at det rettslige innholdet i automatiserte saksbehandlingssystemer skal dokumenteres og i utgangspunktet offentliggjøres.
Justis- og beredskapsdepartementet arbeider videre med et forslag til forskrift om automatisert saksbehandling, blant annet om retten til forklaring og manuell kontroll, som kan gi et mer detaljert rettslig grunnlag.
1 Reglene i norsk forvaltningsrett må også sees i sammenheng med KI-forordningens krav om menneskelig kontroll av høyrisikosystemer og rett til forklaring på individuelle avgjørelser truffet av høyrisikosystemer (se Boks 4.3).
2 Ny forvaltningslov § 12 første ledd er basert på EU-domstolens avgjørelse i C-634/21 SCHUFA Holding avsnitt 66, med grunnlag i GDPR fortalepunkt 71 knyttet til art. 22.
3 Justis- og beredskapsdepartementet utdyper at i de tilfeller der den automatiserte avgjørelsen er et enkeltvedtak, vil kravene til forklaringens innhold i stor grad overlappe med kravene til begrunnelse for vedtaket etter ny forvaltningslov § 57. Nærmere regler kan gis i forskrift – dette er noe Justis- og beredskapsdepartementet jobber med å utarbeide.
4 Retten til manuell kontroll innebærer ikke at det skal foretas en nærmere undersøkelse av selve systemet som har produsert den automatiske avgjørelsen, se Prop. 79 L (2024–2025), pkt. 8.5.3.4. Justis- og beredskapsdepartementet presiserer at ved feil ved systemet som sådan, må feilene rettes før systemet på ny kan brukes til å treffe avgjørelsen. Ved systemfeil som har påvirket andre avgjørelser, vil forvaltningsorganet etter omstendighetene også ha en plikt til å omgjøre disse.
Automatisert saksbehandling med KI
Reglene i ny forvaltningslov §§ 11 til 13 er ikke særskilt utformet for KI-baserte vedtak, men gjelder all automatisert saksbehandling – også regelbasert saksbehandling med flytskjemaer. Det er imidlertid en vesensforskjell mellom flytskjemaer og moderne, datadrevne KI-systemer. Der språkmodell-baserte systemer kan tilpasse svar til en konkret problemstilling basert på sannsynlighetsberegninger, er flytskjemaer utformet for å behandle forhåndsdefinerte situasjoner etter faste regler.
Justis- og beredskapsdepartementet legger til grunn at KI-systemer i utgangspunktet kan benyttes til automatisert saksbehandling, ettersom reglene er teknologinøytrale. Samtidig understrekes det at teknologien ikke kan brukes dersom «egenskaper ved teknologien eller måten teknologien benyttes på», gjør at saksbehandlingsreglene ikke er mulig å oppfylle «for eksempel fordi den aktuelle teknologien ikke gjør det mulig å gi en tilstrekkelig forklaring av eller begrunnelse for en avgjørelse». Dersom regelverket ikke gir grunnlag for unntak, kan teknologien ikke benyttes på den aktuelle måten (Prop. 79 L (2024–2025), pkt. 8.5.1).
Hvorvidt KI-systemer kan brukes til å automatisere beslutninger eller begrunnelser, avhenger i hovedsak av to variabler. Den første er regelverket som skal anvendes, den andre er KI-systemet som skal brukes. I den juridisk-akademiske debatten er det uenighet om hvorvidt det er adgang å bruke KI-systemer i forvaltningen. En side mener at KI-systemer ikke kan brukes, spesielt i skjønnspregede saker, på grunn av manglende forklarbarhet og risiko for diskriminering – uavhengig av kvalitetene til systemet. En annen side legger til grunn at KI-systemer kan brukes som beslutningsstøtte eller til å automatisere (deler av) saksbehandlingen, under vilkår som ivaretar individers rettssikkerhet og demokratisk kontroll. Representanter for sistnevnte side viser til lovende resultater for visse typer KI-teknologi med en høyere grad av forklarbarhet (oppnådd for eksempel ved bruk av metoder fra Explainable AI, XAI) (Nigar 2025, s. 12), se også kapittel 4.2.1. Det å begrense utfordringer med forklarbarhet er også noe av funksjonen til de juridiske rammene i KI-forordningen, ny forvaltningslov og GDPR art. 22. Et tilleggsaspekt er hvorvidt det er aksept og tillit blant mottakere av automatiserte beslutninger eller begrunnelser (Laux et al., 2024).
En særskilt problemstilling er bruk av KI-systemer til automatisering av begrunnelser, dersom disse ikke er del av et automatisert vedtak. Dette innebærer at et KI-system brukes til å forklare et menneskelig vedtak, uten at KI-begrunnelsen nødvendigvis gjengir de bestemte vurderingene mennesket la til grunn for vedtaket. Her er det to tilnærminger. Etter ett syn vil ikke KI-genererte begrunnelser av menneskelige vedtak kunne regnes som begrunnelser – fordi det ikke er KI-systemet som har fattet vedtaket. Etter et annet syn kan de kvalifisere som begrunnelser dersom de ivaretar juridisk riktige hensyn (Diab, 2025). Pesch (2025) utdyper hvilke forutsetninger som skal være på plass for at KI-systemer kan brukes til å utarbeide begrunnelser.
Justis- og beredskapsdepartementet legger til grunn at spørsmålet om hvorvidt (deler av) saksbehandlingen kan automatiseres, må avgjøres etter en konkret vurdering av både KI-systemets kapabiliteter og det regelverket som gjelder i saken (Prop. 79 L (2024–2025)). KI-systemer kan altså i prinsippet være egnet til å fatte vedtak under visse betingelser. Det vil blant annet avhenge av KI-systemets forklarbarhet.
KI-forordningen stiller i tillegg mange krav, spesielt til høyrisikosystemer, for å øke KI-systemenes transparens, forklarbarhet og etterprøvbarhet. Dette gjelder blant annet krav om treningsdata, dokumentasjon, loggføring og menneskelig kontroll (se Boks 4.3).
4.3.5 Likestilling og anti-diskriminering
Likestillings- og diskrimineringsloven forbyr diskriminering på grunn av blant annet kjønn, etnisitet, religion, livssyn, funksjonsnedsettelse og seksuell orientering. Forbudet gjelder på alle samfunnsområder, også når KI-systemer brukes som hjelpemiddel eller til å automatisere beslutninger (Strand, 2024). Likestillings- og diskrimineringsombudet har utviklet en veileder for «innebygd diskrimineringsvern», om hvordan man kan avdekke og forebygge diskriminering i utvikling og bruk av KI.
For KI-systemer er forbudet mot indirekte diskriminering særlig viktig. Indirekte diskriminering er en tilsynelatende nøytral praksis som i realiteten stiller noen personer dårligere enn andre på grunn av et diskrimineringsgrunnlag. Historiske skjevheter i treningsmaterialet kan gi slike utslag, og systemene kan legge vekt på stedfortrederfaktorer, som adresse eller utdanningsbakgrunn, som henger sammen med et vernet grunnlag i likestillings- og diskrimineringsloven. Det kreves ikke at noen har hatt til hensikt å diskriminere.
Tre forhold har praktisk betydning for universiteter og høyskoler. For det første ligger ansvaret hos den som bruker KI-systemet og treffer avgjørelsen, også når systemet er kjøpt fra en leverandør. For det andre gjelder regelen om delt bevisbyrde: Når et KI-system er lite gjennomsiktig, kan det bli institusjonen som må sannsynliggjøre at det ikke diskriminerer. Institusjonene bør derfor kunne dokumentere hvordan systemene virker for ulike studentgrupper. For det tredje har offentlige myndigheter en plikt til å arbeide aktivt for likestilling, og Strand (2024) foreslår at det innføres tilsvarende plikter for alle som bruker algoritmer i beslutninger.
KI-forordningen inneholder tiltak mot diskriminerende effekter i høyrisikosystemer, krav til datakvalitet og risikostyring (se Boks 4.3). Forordningen forbyr også KI-systemer som har som mål å gjenkjenne eller utlede følelser, sosial atferd eller personlighetstrekk i utdanningssituasjoner, ettersom dette innebærer en betydelig risiko for diskriminerende effekter (jf. kap. 4.3.2.3).
4.3.6 Opphavsrett
Opphavsretten er i Norge regulert av åndsverkloven, som gjennomfører EUs digitalmarkedsdirektiv (Direktiv (EU) 2019/790 om opphavsrett i det digitale indre marked).
Å trene en grunnmodell på et åndsverk uten rettighetsavklaring er, om ikke alltid et eklatant brudd på opphavsretten, i tydelig spenning med intensjonen bak opphavsrettslovgivning. Hvorvidt de store, amerikanske språkmodellene er blitt utviklet gjennom brudd på opphavsretten er en problemstilling utenfor europeisk jurisdiksjon. I USA er det initiert flere rettssaker om dette, blant annet har The New York Times gått til søksmål mot OpenAI og Microsoft. Det er i denne sammenhengen problematisk at de største KI-selskapene er lite åpne om hvilke data de har trent modellene sine på.
Fra et rent juridisk perspektiv er det ikke nødvendigvis et brudd på opphavsretten, dersom man utvikler et KI-system som baserer seg på en grunnmodell som er utviklet gjennom brudd på opphavsretten. Det kan likevel være problematisk. KI-forordningen krever at leverandører av KI-modeller for allmenne formål har retningslinjer for å overholde opphavsretten, særlig rettighetshavernes rett til å reservere seg mot tekst- og datautvinning (KI-forordningen art. 53 nr. 1 bokstav c). Ifølge fortalen bør dette gjelde uavhengig av hvor modellen er trent, for å sikre like vilkår (digitalmarkedsdirektivet artikkel 4 nr. 3; KI-forordningen fortalepunkt 106).
For å øke åpenhet om treningsdata skal leverandørene av KI-modeller for allmenne formål offentliggjøre et tilstrekkelig detaljert sammendrag av treningsdata (KI-forordningen art. 53 nr. 1 bokstav d, jf. fortalepunkt 107). Dette skal bidra til at blant annet rettighetshavere skal kunne utøve og håndheve sine rettigheter. Slike vurderinger kan påvirke institusjonenes modellvalg.
Når en norsk KI-leverandør videretrener et KI-system til eget bruk, er den forpliktet å opprettholde norsk åndsverklov, og dermed også det europeiske digitalmarkedsdirektivet. Dette betyr at idet en norsk KI-leverandør videretrener et KI-system, må den gjøre det innenfor åndsverklovens rammer.
Kulturdepartementet har fremmet en lovproposisjon til Stortinget om endringer i åndsverkloven mv. (Prop. 41 LS (2025–2026)) som behandles høsten 2026. Denne gjennomfører endringer i digitalmarkedsdirektivet i norsk åndsverklov om blant annet tekst- og datautvinning. «Tekst- og datautvinning» er definert som «enhver automatisert analytisk metode som tar sikte på å analysere tekst og data i digital form for å framskaffe opplysninger som omfatter, men ikke er begrenset til mønstre, utviklingstrekk og korrelasjoner». Formålet med endringene er å legge bedre til rette for et digitalt og grensekryssende miljø, samtidig som balansen mellom hensynet til rettighetshavere og brukere av verk og vernede arbeider ivaretas (Prop. 41 LS (2025–2026), pkt. 4.1).
For universiteter og høyskoler innebærer de foreslåtte regelendringene om tekst- og datautvinning at det kan bli enklere å bruke opphavsrettslig beskyttet materiale i trening av KI-systemer, forutsatt at det ikke foreligger en reservasjon fra rettighetshavere. For institusjonene er reglene for eksempel relevante ved bruk av eksamensbesvarelser til å trene KI-systemer. Studentenes eksamensbesvarelser er i utgangspunktet beskyttet av opphavsretten, med unntak av ja/nei-svar på flervalgseksamen.21 Etter dagens regler kan disse brukes i KI-systemer uten samtykke fra studenten, men det er ikke mulig å bruke besvarelsene for trening av KI-systemer. Dette blir enklere med de nye, foreslåtte reglene.22 Studenten vil alltid ha rett til å reservere seg mot slik bruk.
4.3.7 Konklusjon
De juridiske rammene for bruk av KI-systemer i høyere utdanning er bygget på flere regelverk, som ofte virker sammen. Mye av regelverket er teknologinøytralt og gjelder uavhengig av om en oppgave utføres av et menneske eller et KI-system, som personvernkravene, forsvarlig saksbehandling, likebehandling og respekt for opphavsrett. KI-forordningen og Europarådets rammekonvensjon om kunstig intelligens kommer i tillegg og stiller særskilte krav til KI-systemer. Ansvaret for at bruken er lovlig ligger hos institusjonene, også når systemene er utviklet av andre.
Samtidig er rettstilstanden på flere punkter uavklart og i rask endring. Den kommende norske KI-loven, den nye forvaltningsloven og endringene i åndsverkloven er ennå ikke trådt i kraft, og sentrale spørsmål vil først bli avklart gjennom praksis. Utvalget har også vurdert erstatningsretten, og legger til grunn at den foreløpig har begrenset betydning for bruk av KI i høyere utdanning.23 Kapittel 7 og 8 går nærmere inn på hva de juridiske rammene i dette kapittelet betyr for eksamen og vurdering og for forvaltning av KI-systemer.
Fotnoter
Noen få institusjoner ligger under andre departementer. For eksempel er Forsvarets høgskole underlagt Forsvarsdepartementet, mens Politihøgskolen og Kriminalomsorgens høgskole og utdanningssenter ligger under Justis- og beredskapsdepartementet.
En vektor-representasjon er en måte å oversette noe avgrenset i datamaterialet, det kan være et ord, bilde eller dokument, til en tett vektor av tall. Hensikten er at ting som er semantisk like havner nær hverandre i dette vektorrommet, mens ting som ikke har noe med hverandre å gjøre havner langt fra hverandre.
KI-forordningens ikrafttredelse den 2. desember 2027 gjelder høyrisikosystemer innen utdanning etter art. 6 nr. 2 jf. Vedlegg III (se nedenfor). Et viktig unntak gjelder for «operatører av KI-systemer med høy risiko,[…] som er brakt i omsetning eller tatt i bruk før 2. august 2026, etter art. 111 nr. 2»: for disse får forordningen anvendelse «bare dersom det fra og med nevnte dato gjøres betydelige endringer i utformingen av disse systemene». Men for offentlige myndigheter gjelder følgende: «I alle tilfeller skal leverandører og idriftsettere av KI-systemer med høy risiko som skal brukes av offentlige myndigheter, treffe de nødvendige tiltakene for å overholde kravene og forpliktelsene i denne forordningen innen 2. august 2030.»
Forslag til gjennomføring av KI-forordningen i norsk rett (den såkalte KI-loven) har vært på høring sommeren 2025 og blir sendt på ny høring høsten 2026, som følge av endringer i KI-forordningen. En lovproposisjon er forventet fremmet til Stortinget våren 2027.
Testing under virkelige forhold foregår i det nøyaktige driftsmiljøet hvor systemet skal fungere i det daglige, og ikke i et konstruert eller isolert testmiljø, slik som en «sandkasse» jf. KI-forordningen art. 57-61.
EU-kommisjonen har i sitt forslag til Digital Omnibus fra november 2025 foreslått å begrense definisjonen til «personopplysninger» i GDPR art. 4 nr.1. Forslaget innebar blant annet at opplysningene ikke skal anses som personopplysninger for en bestemt aktør dersom denne aktøren ikke kan identifisere personen opplysningene gjelder. Dette er en endring fra et absolutt til et mer relativt og aktørbasert begrep. Forslaget er møtt med kritikk fra blant annet European Data Protection Board i februar 2026. Samme måned ble kommisjonens endringsforslag fjernet i Rådets kompromissutkast om den digitale omnibus, slik at det virker veldig lite sannsynlig at definisjonen til «personopplysninger» kommer til å bli innskrenket.
Kravet om innebygd personvern etter GDPR art. 25 innebærer blant annet at den behandlingsansvarlige skal gjennomføre egnede tekniske og organisatoriske tiltak, f.eks. pseudonymisering eller dataminimering.
Dersom dataene behandles på servere utenfor EØS, må institusjonen kunne vise til gyldig overføringsgrunnlag (GDPR art. 44–49), f.eks. EU-kommisjonens adekvansbeslutning eller standardavtaler.
Ved skylagring må institusjonen oppfylle krav til databehandleravtale etter GDPR art. 28, informasjonssikkerhet etter GDPR art. 32 og eventuelt tredjelandsoverføring etter GDPR kap. V.
Avhengig av den konkrete konteksten kan det vurderes om personopplysninger kan behandles for et annet formål jf. GDPR art. 6 nr. 4.
Forslaget inneholder blant annet en innsnevret definisjon av personopplysninger (avvist av EUs medlemsland i Rådet), endringer i reglene om automatisert saksbehandling etter GDPR art. 22, et unntak for særlige kategorier personopplysninger i KI-kontekst og ved biometrisk autentisering. Forslaget er ikke ferdigbehandlet i EU. For en grundig gjennomgang av forslaget, se European Data Protection Board (2026).
Kravet til saklighet og likebehandling er grunnleggende ulovfestede forvaltningsrettslige prinsipper. De innebærer at forvaltningen må basere sine vurderinger på relevante og forsvarlige hensyn, og at like tilfeller skal behandles likt. Prinsippene utgjør en sentral rettssikkerhetsgaranti når KI-systemer brukes i saksbehandling.
KI-forordningens krav til høyrisikosystemer om dokumentasjon og transparans byr på et godt grunnlag for å øke transparens, se Olsen et al. (2024, s.11).
Se Power & Pastor (2024) for en sammenlikning av transparenskrav i GDPR og KI-forordningen.
EU domstolens avgjørelser i sak C-634/21 SCHUFA Holding fra 2023, og sak C-203/22 Dun & Bradstreet Austria fra 2025, som omtalt i Prop. 79 L (2024–2025), punkt 8 om automatisert saksbehandling og automatiserte avgjørelser.
GDPR art. 22 er bygget opp som et forbud mot automatiserte avgjørelser, og etter hvilke vilkår det er mulig å få unntak fra forbudet.
En avgjørelse etter GDPR art. 22 har rettsvirkning for «eller på tilsvarende måte i betydelig grad påvirker» den registrerte. For eksempel, i et (delvis) automatisert opptakssystem kan det være mange automatiserte avgjørelser som del av saksbehandlingen, eksempelvis en automatisk sortering av søkere før et vedtak treffes. En slik sortering, dersom den skjer automatisert og betydelig påvirker kandidaten, vil være en avgjørelse etter GDPR art. 22.
Det mest relevante grunnlaget for unntak i denne utredningens kontekst er en lovhjemmel for automatiserte avgjørelser av et bestemt slag, som da må ivareta den berørtes rettigheter (GDPR art. 22 nr. 2 og 3). Samtykke kan også gi unntak, men er ofte ikke like godt egnet, jf. kap. 4.3.3.
Kravene i GDPR art. 22 nr. 3 gjelder også ved automatiserte avgjørelser med hjemmel i nasjonal rett etter art. 22 nr. 2 bokstav b, se EU-domstolens avgjørelse i C-634/21 SCHUFA Holding.
EU-domstolens avgjørelse C-203/22 Dun & Bradstreet Austria fra 2025 slår fast at GDPR art. 15 nr. 1 bokstav h om den registrertes rett til innsyn gir den en rett til å kreve en etterfølgende forklaring av automatiserte avgjørelser som omfattes av GDPR art. 22. Denne dommen er bakgrunnen for retten til forklaring i ny forvaltningslov § 12 andre ledd (Prop. 79 L (2024–2025), pkt. 8.1.2 og 8.5.3.3).
Studentenes skriftlige besvarelser vil i utgangspunktet oppfylle kravet til verkshøyde i åndsverkloven § 2, ettersom de er litterære eller kunstneriske verk som er uttrykk for original og individuell skapende åndsinnsats.
For å kunne gjøre dette, er det krav om lovlig tilgang til opphavsrettslig beskyttet materiale. Institusjonen som har avholdt eksamenen har lovlig tilgang til besvarelsene. Ved samarbeid mellom flere institusjoner om trening av et KI-system er kravet om lovlig tilgang mer usikkert, og institusjonen bør innhente et samtykke (rettighetsklarering) fra studentene.
Gjeldende rett kan endre seg: EUs forslag til direktiv om KI-ansvar, som ville gjort det lettere å føre bevis for skade voldt av høyrisikosystemer, blant annet i utdanning, ble trukket i 2025. Det diskuteres også om det tradisjonelle skyldansvaret passer når oppgaver overlates til systemer uten skyldevne (Askeland, 2025). Institusjonene bør derfor følge rettsutviklingen.