Del 2
Tematiske analyser med anbefalinger
5 Hva skal vi lære?
5.1 Innledning
Utviklingen av kunstig intelligens (KI) påvirker hva det er formålstjenlig å lære. I ytterste konsekvens kan KI-systemer erstatte mennesker i løsningen av visse oppgaver. Det reduserer nytteverdien av den kunnskapen og de ferdighetene som tidligere var nødvendige for å løse oppgavene. Samtidig kan mange ferdigheter og typer kunnskap bli mer verdifulle som følge av teknologiutviklingen, for eksempel ved at de gjør oss bedre i samspill med KI, at de setter oss i stand til å løse nye oppgaver som teknologien skaper, eller til å unngå teknologiens mulige skadevirkninger. Med riktig sammensetning av kunnskap og ferdigheter blir vi bedre posisjonert både til å utløse potensialet av KI og til å begrense risikoene teknologien bærer med seg.
Kapittelet er organisert som følger.
De første to underkapitlene gir premisser for de påfølgende vurderingene og resonnementene: Kapittel 5.2 beskriver hvilke formål utvalgets vurderinger retter seg etter, og kapittel 5.3 gir uttrykk for hva utvalget antar om teknologiske og samfunnsmessige utviklingstrekk.
Et av spørsmålene som treffer universiteter, høyskoler og sentrale utdanningsmyndigheter, er hva slags kompetanse om og med KI som blir viktig å utvikle. Utvalget gir sitt svar på dette spørsmålet i kapittel 5.4. Et annet spørsmål er hvordan KI-utviklingen påvirker bredden av ulike læringsutbytter, fra fagkunnskap til programmeringsferdigheter og kritisk tenkning. Kapittel 5.5 beskriver forholdet mellom KI og menneskelig kompetanse, og gir en vurdering av hva slags utfordring KI reiser for etablert læringsinnhold. Implikasjonene KI-utviklingen har for et utvalg av viktige og spesielt berørte typer læringsutbytte blir vurdert i kapittel 5.6.
Kapittel 5.7 beskriver og vurderer dagens regulering av læringsutbytte. Kapittel 5.8 viser hvordan KI-utviklingen samlet sett kan gi behov for et mer avansert læringsutbytte. Kapittel 5.9 gir anbefalinger på grunnlag av vurderingene som er gjort i kapittelet.1
5.2 Formål
Formålene med høyere utdanning legger føringer for hvordan vi kan vurdere hva som er formålstjenlig å lære (jf. kap. 2.2). Læringsutbyttet skal komme både en selv og samfunnet til gode. Læringsutbyttet kan ha en instrumentell verdi, for eksempel som en forutsetning for å løse en økonomisk verdifull oppgave eller styrke rasjonaliteten i det offentlige ordskiftet, og det kan være verdifullt for sin egen skyld, for eksempel som en berikelse for den som tilegner seg det.
Utvalgets vurderinger av hvordan KI påvirker hva vi skal lære tar nærmere bestemt utgangspunkt i tre overlappende målsettinger:
-
Faglig kvalitet: Høyere utdanning er konstituert av fag med ulike metoder, begrepsapparater, kunnskapsgrunnlag og praksisfelt. Å studere et fag innebærer å lære seg å tenke som en utøver av faget. Man skal lære seg å tenke som en historiker, som en økonom, som en matematiker, som en sykepleier osv. KI påvirker hva det betyr å være en god fagutøver, blant annet gjennom å endre på hvilke metoder og teknikker man har størst nytte av å beherske. KI kan også påvirke forutsetningene for å lære seg å tenke som en kyndig fagutøver.
-
Samfunns- og arbeidslivsrelevans: KI-utviklingen påvirker samfunnet og arbeidslivet på mange ulike måter. For at utdanningstilbudene skal holdes relevante, må de blant annet møte endrede kompetansebehov. Dette handler ikke bare om å holde tritt med en utvikling som skjer utenfor universitetene og høyskolene, men også om at kandidater fra høyere utdanning skal kunne forme fremtidens samfunn og arbeidsliv (Meld. St. 5 (2022–2023), s. 22–23).
-
Dannelse: Høyere utdanning skal bidra til å forme oss som tenkende individer, blant annet ved at vi kultiverer holdninger og intellektuelle vaner. Gjennom å lære oss å tenke selvstendig, og gjennom å få kjennskap til ideene som våre demokratiske og kulturelle praksiser bygger på, blir vi også i bedre stand til å ta del i og forme disse praksisene.
5.3 Antakelser om fremtiden
Utviklingen av kunstig intelligent teknologi går raskt. Det er usikkert hva slags teknologi vi vil ha tilgjengelig om fem, ti eller 20 år. Det er også langt på vei usikkert hvordan teknologien vil prege samfunnet og arbeidslivet, og hvordan den vil prege fagene i høyere utdanning. Samtidig blir ikke fremtidsutsiktene bestemt av teknologi alene, og det er heller ikke forutbestemt hvordan vi tar KI-systemer i bruk. Noe kan vi likevel legge til grunn om teknologiutviklingen og hva slags samfunn studentene skal ut i.
Noen av de viktigste forutsetningene blir beskrevet i det følgende, nemlig utviklingen av mer kapable KI-systemer og integrasjonen av KI i samfunn og arbeidsliv, behovet for økt produktivitet og teknologisk selvbestemmelse, og Norge som et liberalt demokrati med et informasjonslandskap under press.
5.3.1 KI-kapabiliteter
KI omfatter både spesialiserte systemer som tjener avgrensede formål, og fleksible systemer som kan brukes til et mangfold av oppgaver – det som i EUs KI-forordning heter «KI-modeller til allmenne formål». Den første kategorien omfatter for eksempel medisinske diagnoseverktøy og anbefalingsalgoritmer på nettplattformer. Den andre kategorien omfatter grunnmodeller og mange av systemene som bygger på dem, f.eks. samtaleroboter og agentiske systemer. Et KI-systems «kapabiliteter» viser til hvor godt systemet presterer på ulike oppgaver og parametre.
Kapittel 3.7 beskriver KI-utviklingen i større detalj. Noen trekk ved utviklingen er verdt å fremheve her:
-
Systemene blir i stand til å gjøre stadig mer, og med bedre kvalitet, på grunn av tekniske innovasjoner og større tilgang på data og regnekraft.
-
Et høyt utviklingstempo kombinert med stor investeringsvilje tyder på at utviklingen vil fortsette, uten at det er gitt om den vil akselerere, sakke ned eller fortsette i samme tempo (Government Office for Science, 2026; OECD, 2026a). Historisk har oppskaleringen av grunnmodeller – med flere parametre og mer data og regnekraft til treningen – gitt gode forutsigelser av hvor kapable modellene vil være. Vi kan likevel ikke slå fast at fortidige skaleringsmønstre vil fortsette. Vi er, enkelt sagt, i et ukjent terreng.
-
Flere av sprangene i utviklingen har vært uforutsigbare. Det var for eksempel vanskelig å forutsi at språkmodeller kunne brukes til å produsere avanserte matematiske og logiske bevis før det ble utviklet såkalt resonnerende modeller.2
Utviklingstrekkene gir en betydelig usikkerhet om hva slags teknologisk virkelighet fremtidens studenter utdannes i og til.
Når det gjelder spesialiserte KI-systemer med avgrensede formål, er det sannsynlig at vi vil fortsette å se nye anvendelser. For alle oppgaver hvor man har et veldefinert mål – og hvor man kan samle inn data med kjennetegn på vellykkede og mislykkede løsninger – er det mulig å bruke maskinlæringsteknikker for å lage et system som gjennom nok trening kan løse oppgaven (jf. kap. 3). Dette utgjør et stort mulighetsrom for utvikling av KI-systemer som er innrettet for å løse én type oppgave godt.
Usikkerheten om fremtidens KI-systemer er likevel størst for de store språkmodellene og systemene som bygger på dem. Språk – som i denne sammenhengen omfatter både naturlige språk og formaliserte systemer, som programmeringsspråk og matematisk notasjon – kan sees på som et universalverktøy. I likhet med menneskelig kognisjon er det ikke noen klar grense for hva språkmodeller kan brukes til.
Bredden i hva språkmodeller kan brukes til sammenfaller med at det både er stor variasjon og uforutsigbarhet i hvor godt ulike systemer presterer på bestemte oppgaver (jf. kap. 3.7 om den ujevne utviklingsfronten). På visse områder, som matematikk og programmering, har de over tid vist seg å prestere svært godt. Selskapene som utvikler de fremste språkmodellene – blant annet OpenAI og Anthropic – gjør utstrakt bruk av egne modeller til å programmere neste generasjons modeller. Ettersom systemene jobber raskt og aldri behøver hvile, høyner dette taket for hva slags teknologiske muligheter som kan finnes om fem, ti eller 20 år.
OECD og britiske Government Office for Science har fremstilt scenarioer for KI-utviklingen (Government Office for Science, 2026; OECD, 2026a). Scenarioene i begge publikasjoner spenner fra full stagnasjon til at de beste modellene overgår menneskelige eksperter på alle kognitive oppgaver. I tråd med den betydelige graden av usikkerhet vi her legger til grunn, knytter verken OECD eller Government Office for Science sannsynlighetsestimater til enkeltscenarioer.
Med dette utgangspunktet må vi forutsette at fremtidens KI-systemer vil bli mer kapable enn dagens systemer, og at de i ytterste konsekvens kan prestere bedre enn menneskelige eksperter på alle kognitive oppgaver. Områdene hvor det er mest sannsynlig at KI-systemene vil prestere best, enten det er gjennom spesialiserte systemer til avgrensede formål eller gjennom modeller til allmenne formål, er de områdene hvor man kan definere klare mål og har oppgaveløsninger som lar seg verifisere. KI-systemenes forhold til menneskelig kompetanse er utbrodert i kapittel 5.5.
5.3.2 KI-integrasjon
Det tar tid før teknologiske muligheter blir gjort til virkelighet. Det krever aktive valg om å ta teknologien i bruk og kan innebære mye friksjon: Kanskje må en virksomhet bytte ut sine datasystemer eller omorganisere seg, eller kanskje må en større produksjonskjede omkalfatres for å dra nytte av mulighetene KI gir. Tilsvarende kan integrasjon av KI i fagene i høyere utdanning kreve at man utvikler nye metoder heller enn å få systemene til å løse eksisterende oppgaver med etablerte metoder.
Etter tall som Statistisk sentralbyrå samlet inn våren 2026, hadde 89 prosent av befolkningen mellom 16 og 79 år brukt generative KI-systemer til private formål i løpet av de siste tre månedene, mens 65 prosent hadde brukt generative KI-systemer til jobb- eller karriererelaterte formål (Statistisk sentralbyrå, 2026b). Dette sier lite om hvor dypt integrert generative KI-systemer er i samfunns- og arbeidsliv, men det er en klar indikasjon på at teknologien har spredd seg raskt på få år, også i Norge.
Kompetansebehovsutvalget (2025, s. 44) peker på at generative KI-systemer har blitt tatt i bruk bottom-up, som en teknologi ansatte selv finner frem til, eller som blir gjort tilgjengelig for dem med lisenser uten detaljert instruksjon om hvordan den skal brukes. Få virksomheter har integrert KI i sine systemer og få virksomheter opplever å realisere gevinster av sin KI-bruk (Rambøll, 2025). For bruk av språkmodeller, samt systemene som bygger på dem, er dette lite overraskende: Teknologien har uavgrensede bruksformål, er fortsatt fersk for de aller fleste, og den har en varierende og delvis ukjent pålitelighet. Det tar tid å finne ut hvordan man skal ta språkmodeller i bruk på en forsvarlig og produktiv måte. Selv om kapabilitetsutviklingen stagnerer, vil vi trolig se videre integrasjon av dagens KI-systemer.
Språkmodeller føyer seg inn i et mønster for teknologier til allmenne formål, som elektrisitet og personlige datamaskiner: Brynjolfsson et al. (2021) viser at slike teknologier kan kreve en rekke endringer og komplementære investeringer før de gir utslag i eventuelle og potensielt store produktivitetsgevinster.
Heller ikke for fagene i høyere utdanning blir teknologiske muligheter umiddelbart omsatt i nye praksiser. Det tar tid å finne ut hva slags rolle KI-systemer kan ha i faglige metoder som ble utviklet lenge før vi hadde noe som minner om dagens KI-systemer, eller hvordan man kan utvikle nye faglige metoder som baserer seg på dem fra grunnen av. Der hvor for eksempel gode transkripsjonsverktøy har en umiddelbar nytte for gjennomføring av journalistiske og samfunnsvitenskapelige intervjuer, må fagmiljøene over tid komme fram til hvilken rolle språkmodeller kan spille i analyser av intervjudata og annen kvalitativ data.
Per i dag er KI-løsninger sterkest integrert i STEM-fagene og i de økonomiske og administrative fagene. I matematikk står for eksempel KI-systemer, med eller uten vesentlig grad av menneskelig assistanse, for mange av de betydeligste nye bevisene som er blitt utviklet i 2026. De humanistiske og estetiske fagene er minst preget av KI. I filosofi er det for eksempel få, om noen, fagspesifikke KI-anvendelser, uten at det betyr at KI-systemer ikke har noen rolle i faget. Også filosofer kan dra nytte av faglig sett generiske anvendelser som å få støtte til hvordan et argument kan organiseres. Forskjellene i hvor dypt KI er integrert i de ulike fagene reflekteres blant annet i Studiebarometerets oversikt over hvilke studentgrupper som gjør størst bruk av KI-systemer (HK-dir, 2026b; se også kap. 6).
Det er usikkert hvor raskt, bredt og dypt KI integreres i fagene i høyere utdanning, i samfunnet og i arbeidslivet. Det er likevel en klar kurs på utviklingen: Fremtidens studenter skal utdanne seg i fag som er mer preget av KI, ta del i et samfunn og arbeidsliv som er mer preget av KI, og det er en forventning om at nyutdannede vil ha kompetanse til å utnytte KI-systemer i utøvelsen av faget. Utvalget legger til grunn at KI vil bli sterkere integrert i alle fag i høyere utdanning.
5.3.3 Demografi og produktivitet
I årene fremover vil Norge ha færre folk i arbeidsfør alder og et økende behov for helse- og omsorgstjenester på grunn av en aldrende befolkning. Siden KI-systemer kan avlaste arbeidskraftsbehovet og øke produktiviteten, kan KI være en del av løsningen på en av våre største samfunnsutfordringer i årene fremover.
Uten høyere produktivitet vil ikke Norge kunne opprettholde dagens velferdsnivå, møte eldrebølgen eller kompensere for nedgang i oljeinntekter. Parallelt er den yrkesaktive andelen av befolkningen forventet å falle fra 54 prosent i 2023 til 48 prosent i 2060 (Meld. St. 31 (2023–2024), kap. 1.1.1. og 3.5.2.). Det samme gjelder for EU, som går inn i den første perioden i nyere historie der (eventuell) økonomisk vekst ikke vil bli støttet av økende befolkning (jf. Draghi, 2024, s. 23). Disse endringene skjer i en kontekst der midler i statsbudsjettet kan anvendes mindre fritt enn tidligere, på grunn av behov i forsvarssektoren og prioriteringer for å nå målet om et lavutslippssamfunn (Meld. St. 31 (2023–2024), kap. 1.1.2; Prop. 87 S (2023–2024)).
Helsepersonellkommisjonen fremhever teknologiske løsninger som en av nøklene for å redusere personellbehovet: «Selv om helse- og omsorgstjenesten er arbeidsintensiv og svært mange av oppgavene er relasjonelle, er det en rekke oppgaver som ikke er det. De kan og bør automatiseres.» (NOU 2023: 4, s. 269)
Forskere har svært ulike forutsigelser om produktivitetsveksten KI kan gi, fra forsiktige anslag basert på kjente variabler, til høye anslag drevet av eksponentielle vekstkurver. Daron Acemoglu (2025) anslår at KI kun vil gi en beskjeden produktivitetsvekst over de neste ti årene, med en økning på ikke mer enn 0,66 prosent i total faktorproduktivitet for hele perioden.3 Philip Tramell og Anton Korinek (2023) argumenterer på sin side for at KI-utviklingen akselererer og går såpass fort at vi i nær fremtid kan se automatisering av svært mye produksjon, forskning og utvikling. Et slikt scenario vil kunne innebære en enorm, kapitaldrevet produktivitetsvekst. Litteraturen viser samstemmighet om at KI vil gi produktivitetsvekst, men svært ulike forventninger om vekstens omfang. Behovet for produktivitetsvekst og avlastning av arbeidskraftsressurser er i alle fall klart til stede, og utvalget forutsetter at KI vil spille en rolle i å møte dette behovet.
5.3.4 Teknologisk selvbestemmelse
I Norge har vi en lang tradisjon for å regulere teknologisk infrastruktur slik at den kommer samfunnet til gode. Ny teknologi knyttet til for eksempel transport og utnyttelsen av vannkraft og olje illustrerer dette trekket i moderne norsk historie. Norge er primært en konsument av KI-systemer og KI-relaterte løsninger utviklet i utlandet. Skal digital teknologi generelt og KI spesielt komme til å prege samfunnet i økende grad, kommer problemstillinger knyttet til vår digitale suverenitet til å bli stadig viktigere i årene fremover. Dette blir forsterket av en mer urolig geopolitikk: Blir KI-systemer mer kritiske for hvordan vi arbeider, former oppfatninger og treffer beslutninger, blir det også viktigere å unngå sårbare avhengighetsforhold til et fåtall teknologileverandører underlagt andre makter (jf. kap. 8). Vi kan på dette grunnlaget forutsette at vår evne til å bestemme over teknologien vi gjør bruk av, og hvilke løsninger vi gjør oss avhengig av, blir viktigere.
5.3.5 Et liberalt demokrati med et informasjonslandskap under press
Etter en tradisjon som for Norges del satte fart i 1814, hvor norske samfunnsmedlemmer ble omdannet fra undersåtter under en eneveldig dansk konge til (formelt) frie og likestilte samfunnsborgere, har vi et liberalt demokrati med en uavhengig rettsstat og grunnlovfestet ytringsfrihet. For at det norske demokratiet skal fungere godt, er det avhengig av et velfungerende offentlig ordskifte med bred deltakelse, saklig argumentasjon og rom for uenigheter. Demokratiet er også avhengig av kilder til informasjon som nyter bred tillit, og som gjør seg den tilliten fortjent. Idet KI blir dypere integrert i samfunnet, kan disse betingelsene for et velfungerende demokrati bli utfordret.
KI påvirker allerede våre medievaner og dermed hva slags informasjon vi bygger våre oppfatninger på. Algoritmer utviklet med maskinlæring er med på å bestemme hva slags medieinnhold og informasjon vi blir eksponert for på nettplattformer, typisk med mål om å øke tiden vi bruker på plattformene. Dette forsterker en trend hvor redaktørstyrte mediers rolle i den offentlige samtalen blir svekket (NOU 2022: 9). Altså blir mindre av informasjonen som den offentlige samtalen bygger på, vurdert og formidlet av journalister og redaktører. Videre kan innholdsalgoritmer på nettplattformer forstyrre vår evne til oppmerksomhet, gjennom å holde oss engasjert på plattformen.
KI-generert innhold blir stadig vanligere, både i forskningspublikasjoner, sosiale og redaktørstyrte medier, og i annen kommunikasjon. Mer effektiv produksjon og distribusjon av informasjon er i utgangspunktet et gode, forutsatt at informasjonen er av god kvalitet. Men KI-generert innhold fører også med seg utfordringer. Ett problem er at generative KI-systemer kan dikte opp saksforhold, personer eller kilder, og dermed gi feilinformasjon. Et annet problem at systemene kan tjene som effektive verktøy for å aktivt spre desinformasjon eller skadelig informasjon (Ekspertgruppen for kunstig intelligens og valg, 2025, kap. 5.1; jf. NOU 2022: 9, s. 160).
Også studenter i høyere utdanning treffer et annerledes informasjonslandskap enn det de gjorde for fem, ti eller 20 år siden. Effekten er tvetydig. På den ene siden er KI-formidlet og KI-generert læringsinnhold utsatt for problemer med skjevheter og hallusinasjon. På den andre siden kan KI-systemer la studentene finne frem til faglitteratur mer effektivt enn eldre søkemotorer, eller la dem gå i en form for dialog med fagstoffet.
Når KI-systemer både formidler og skaper en stor del av den informasjonen vi bygger våre oppfatninger og holdninger på, ligger det mye makt hos selskapene som utvikler systemene. I fintreningen av en språkmodell er det betydelig rom for å instruere den – direkte eller indirekte – til å favorisere bestemte syn og verdier, på godt og vondt.
Alle disse trekkene gir et informasjonslandskap som er mer krevende å navigere i. KI bidrar til et større informasjonsvolum og et svakere grunnlag for tillit til at informasjonen vi får tilgang til er sann eller veldokumentert. Studentene treffer det samme underveis i utdanningen, idet de skal utforske, vurdere og sammenstille informasjon i et læringsøyemed.
5.4 KI-kompetanse
Når KI i økende grad preger samfunnet, arbeidslivet og fagene som høyere utdanning bygger på, blir det et større behov for KI-kompetanse. «KI-kompetanse» betegner i denne sammenhengen alt av kunnskap om KI og ferdigheter i utvikling og bruk av KI. Dette er en mangeartet kategori. For å møte behovene for KI-kompetanse er det derfor nødvendig å tenke systematisk om spesifikke former for KI-kompetanse, hvilke som er viktigst og hvilken rolle universiteter og høyskoler har i å utvikle dem.
5.4.1 Etablerte rammeverk for KI-kompetanse
Det har vært mange initiativer for å beskrive hva slags KI-kompetanse det blir større behov for. En del av beskrivelsene er samlet og strukturert i rammeverk for KI-kompetanse eller KI-kyndighet (AI literacy frameworks). Utvalget har orientert seg om flere slike rammeverk:
-
OECDs AILit Framework, utviklet i samarbeid med Code.org og EU-kommisjonen (OECD, 2025b)
-
EU-kommisjonens rammeverk for digital kompetanse, DigComp. Utgave 3.0 er en omfattende oppdatering, med tilføyelse av mange former for KI-kompetanse. Her er KI-kompetansene sammenvevd med andre former for digital kompetanse i stedet for å være gruppert for seg selv (Cosgrove & Cachia, 2025)
-
UNESCOs rammeverk, som primært retter seg mot skolen (UNESCO, 2024)
-
Det tyskutviklede AIComp-rammeverket (Ehlers et al., 2024)
-
Digital Education Councils rammeverk (Digital Education Council, 2025a)
Samlet sett likner rammeverkene på hverandre. De gir alle uttrykk for behovet for å kunne forstå, bruke, utvikle og forvalte KI-systemer, og ta kritisk stilling til de etiske, juridiske og samfunnsmessige utfordringene teknologien reiser.
Rammeverket til Digital Education Council (DEC) er etter utvalgets vurdering den nyttigste referansen for arbeid med KI-kompetanse i norsk høyere utdanning.4 Rammeverket er spesifikt utviklet for høyere utdanning, med blant annet rimelige vurderinger om hva som egner seg å lære i konteksten av høyere utdanning, og med operasjonaliseringer av rammeverket for studenter og ansatte.
DEC deler KI-kompetanse inn i fem kompetanseområder («dimensjoner»): (1) Forståelse av KI og data, (2) kritisk tenkning og dømmekraft, (3) etisk og ansvarlig bruk, (4) menneskelig orientering, emosjonell intelligens og kreativitet og (5) domeneekspertise (Figur 5.1). Kompetanseområdene er definert og eksemplifisert. Videre spesifiserer DEC tre ulike mestringsnivåer for hvert kompetanseområde.
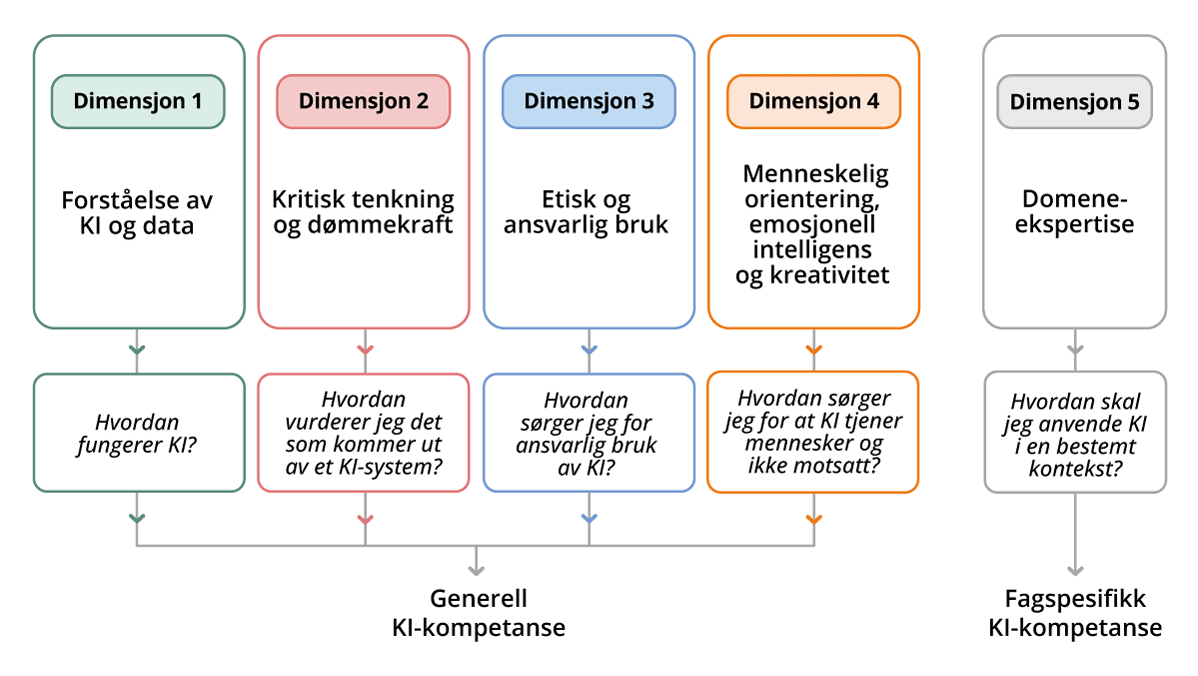
Figur 5.1 Kompetanseområder i DECs rammeverk for KI-kompetanse
Utvalgets oversettelse og reproduksjon av DECs figur.
Kilde: Digital Education Council (2025a)
-
Forståelse av data og KI omfatter det å beherske KI-relaterte begreper, for eksempel om maskinlæring; kunnskap om hvordan KI-systemer blir utviklet og om hvordan systemene fungerer.
-
Kritisk tenkning og dømmekraft omfatter det å forstå styrkene og svakhetene til KI-systemer, hvordan de kan gi feilaktige eller misvisende resultater, hvordan man kan verifisere KI-skapte løsninger, og det å kunne føre resonnementer om når man bør og ikke bør stole på et KI-system.
-
Etisk og ansvarlig bruk omfatter kunnskap om de etiske og juridiske problemstillingene KI-systemer reiser, herunder om transparens, reproduksjon av skjevheter, ansvar for resultater, personvern og opphavsrett, samt ferdigheter i hvordan man kan bruke KI-systemer på en forsvarlig måte.
-
Menneskelig orientering, emosjonell intelligens og kreativitet omfatter forståelse av hva som skjer i møter mellom mennesker og KI, herunder hvordan KI påvirker sosiale forhold, og kunnskap om hvordan KI-systemer kan støtte oss som mennesker heller enn at mennesker blir underordnet teknologien.
-
Domeneekspertise omfatter KI-relaterte kunnskaper og ferdigheter som bare kommer til uttrykk i bestemte faglige og yrkesmessige kontekster.
Merk at de fire første kompetanseområdene faller inn under det vi kan kalle generell KI-kompetanse, mens det siste – domeneekspertise – svarer til det vi kan kalle fagspesifikk KI-kompetanse. Rammeverket sporer dermed et skille som har vært brukt flere ganger i norsk sammenheng, mellom generell, fagspesifikk og spesialisert digital kompetanse – sist av kompetansebehovsutvalget (2025).5 KI-kompetanse kan i denne sammenheng forstås som en gjennomgående underkategori av digital kompetanse.
Etter hva utvalget kjenner til, finnes det ikke noe rammeverk for KI-kompetanse som er kodifisert i et regelverk. Rammeverkene har dermed en veiledende funksjon. Den eneste kjente reguleringen av KI-kompetanse er i EUs KI-forordning. KI-forordningen (art. 4) stiller krav om at leverandører og idriftsettere av KI-systemer treffer tiltak for å sikre et tilstrekkelig nivå av KI-kompetanse hos sine ansatte. Tiltakene skal ta hensyn til de ansattes tekniske kunnskap, erfaring, utdanning og opplæring, den konkrete sammenhengen KI-systemene skal brukes i, og sluttbrukernes (for eksempel studentenes) behov. Dette innebærer at institusjonene må sørge for en trygg og ansvarlig brukskontekst, og at studenter bør få nødvendig veiledning om risikoer og begrensninger, og retningslinjer for KI-bruk som ivaretar akademisk integritet.
5.4.2 Utvalgets vurdering
I tråd med at KI i økende grad kommer til å prege fagene, arbeidslivet og samfunnet i årene fremover, er det behov for mer kunnskap om og ferdigheter med teknologien. Uten det kan vi ikke aktivt forsøke å unngå risikoene ved teknologien, styrke vår evne til teknologisk selvbestemmelse eller utnytte KIs potensial for produktivitetsvekst. For å ivareta målene om faglig kvalitet og samfunns- og arbeidslivsrelevans, bør derfor studietilbudene i høyere utdanning gi kunnskap om og ferdigheter med KI. Man kan også argumentere for at KI-kompetanse blir en stadig viktigere del av hva det vil si å være dannet i vår tid.
KI-kompetanser kan ikke løsrives helt fra andre typer læringsutbytte, i to betydninger. For det første kan læringsutbytter som ikke egentlig dreier seg om KI, være forutsetninger for å utøve visse former for KI-kompetanse. Man kan for eksempel vanskelig gjøre kritiske vurderinger av KI-generert innhold uten et fundament av fagkunnskap og ferdigheter i kritisk tenkning. I dette tilfellet fungerer fagkunnskap og kritisk tenkning som det kompetansebehovsutvalget (2025, s. 59) kaller muliggjørende kompetanser.
For det andre kan det være uklare grenser for hva man skal regne som KI-kompetanse og hva man skal regne som annen kompetanse. Når en jusstudent utvikler kunnskap om hvor godt ulike KI-systemer ivaretar personvernet, så kan vi på ett plan forstå det som en anvendelse av kunnskap hun allerede har, om personvern. På et annet plan utvikler hun et stykke kunnskap om KI. Det fremstår riktigst å si at det er begge deler. Studenter lærer både om, med og gjennom KI når teknologien tas i bruk i fagene.
De ulike formene for KI-kompetanse er altså ikke fundamentale stykker med kunnskap som man kan besitte uavhengig av andre stykker med kunnskap. De behøver heller ikke være uavhengig av andre former for KI-kompetanse. Dette er tydelig ut fra hvordan DECs rammeverk for KI-kompetanse skjelner mellom ulike kompetanseområder: Skal man forstå hvilke styrker og svakheter et KI-system har – en ferdighet som blir sortert under «kritisk tenkning og dømmekraft» (Digital Education Council, 2025a, s. 12) – kan det forutsette kunnskaper og ferdigheter fra alle kompetanseområdene.
Som nevnt, vurderer utvalget DECs rammeverk for KI-kompetanse som det nyttigste av kjente, etablerte rammeverk for å tenke om KI-kompetanse i høyere utdanning. Utvalget vil likevel ikke anbefale at rammeverket brukes som noe mer enn et nyttig utgangspunkt. En utfordring med alle rammeverk for KI-kompetanse er at de ikke er laget for å fange inn fagforskjeller. For eksempel er kunnskap om KI og personvern viktigere for sykepleiere enn det er for bygningsingeniører. En annen utfordring er at rammeverkene er statiske verktøy i møte med en teknologi i rask utvikling. Det å identifisere hva slags KI-relatert læringsinnhold som fortjener plass i det enkelte studietilbud, er derfor et arbeid som er nødt til å skje løpende og som ideelt sett innebærer fagtilpasning.
Utvalget har ikke prioritert å selv utvikle et rammeverk for KI-kompetanse. I stedet følger konkrete vurderinger av noen bestemte typer kunnskap om og ferdigheter med teknologien som det er behov for å styrke, og av hvilken rolle høyere utdanning har i dette. Vurderingene er sortert under kategoriene generell KI-kompetanse og fagspesifikk KI-kompetanse.6
5.4.2.1 Generell KI-kompetanse
Generell KI-kompetanse er den kunnskapen om KI og de ferdighetene med KI som er felles for ulike fagområder. De fire første kompetanseområdene i DECs rammeverk er alle ulike dimensjoner av generell KI-kompetanse.
Det er rimelig å forvente at fremtidens studentkull vil ha mer forhåndskunnskap om KI, i takt med at KI tar mer plass som tema i skolen og i det offentlige ordskiftet. Høyere utdanning har likevel en viktig rolle i å løfte kunnskapsnivået videre, og det er i høyere utdanning man har tilgang på de faglig sett sterkeste undervisningsressursene på området.
Utvalget vil fremheve følgende kompetanser som særlig viktige. Intensjonen er ikke å gi en uttømmende liste, men et utvalg av viktige kompetanseområder med verdi for alle studenter i høyere utdanning.
Teknologiforståelse
Å ha en grunnleggende forståelse av de tekniske sidene av KI er en forutsetning for det meste av KI-kompetanse. En sentral del av dette er å beherske KI-relaterte begreper, herunder om data, maskinlæring og grunnmodeller. Det omfatter også å vite noe om spekteret av ulike typer KI-systemer og forskjellen på dem, som mellom regelbaserte og datadrevne systemer; mellom modeller til allmenne formål og spesialiserte systemer; mellom prediktive, generative og agentiske systemer; mellom åpne og lukkede modeller mv. En god teknisk forståelse av KI innebærer å vite hvordan systemene, i kraft av måten de er utviklet på, kan gi feilaktige eller misvisende resultater. En god teknisk forståelse av KI kan også innebære å vite noe om hva slags infrastruktur fremtredende KI-systemer utvikles og drives på, herunder forskjellen på lokal drift og skytjenester.
Gjennom god veksling mellom abstraksjonsnivåer, fra konkrete anvendelser til de mer abstrakte egenskapene til KI-systemer, kan undervisere bidra til at studentene utvikler en varig forståelse av teknologien som de kan bygge videre på, samtidig som de får kjennskap til de anvendelsene av teknologien som har størst betydning i samfunnet og i sine fag (se også kap. 6).
Studentenes tekniske forståelse av KI bør være på et slik nivå at den, i kombinasjon med fagkunnskap og evner til kritisk tenkning og etisk refleksjon, setter studentene i stand til å gjøre normative vurderinger av KI-systemer og KI-bruk med relevans for sine fag, herunder hva som kjennetegner egnede bruksområder og hvilket behov det er for å verifisere eller kvalitetssikre forslag fra et KI-system. Se også kapittel 5.4.2.2 om fagspesifikk KI-kompetanse.
Boks 5.1 Mikroemner for digital kunnskap, forståelse og kompetanse ved Universitetet i Bergen
Universitetet i Bergen tilbyr en rekke små studieemner for å styrke digital kompetanse på tvers av fagfelt. Flere av emnene gir generelle KI-kompetanser, slik de er beskrevet i kap. 5.4.2.1.
Per august 2026 er to av emnene innføringskurs uten studiepoenguttelling («Digital student» og «Digital kildekritikk»), og ni av emnene er mikroemner, med uttelling på 2,5 stp:
-
DIGI110 – Fantastiske data
-
DIGI111 – Algoritmer og programmering
-
DIGI112 – IKT-sikkerhet
-
DIGI113 – GDPR og personvern
-
DIGI114 – Kunstig intelligens
-
DIGI115 – Data og demokrati
-
DIGI116 – Medical Data Science
-
DIGI117 – Språkteknologi
Emnepakken adresserer kunnskapsbehov man finner i alle fagområder. Modulariteten man får med små, sammensettbare emner, gjør det enklere med individuelle prioriteringer (med utgangspunkt i hva man kan fra før) og fagspesifikke prioriteringer (med utgangspunkt i hva som har størst nytte i faget man studerer eller utøver). Disse egenskapene gjør emnepakken til et eksempel på hvordan man kan møte behovene for generell KI-kompetanse på en fleksibel måte, uten å lage egne emner for hvert fagområde.
Kilde: Universitetet i Bergens nettsider
Forståelse av kjerneutfordringer
Å ha en forståelse av de mest grunnleggende utfordringene med KI er viktig for å kunne identifisere risikoer ved utvikling og bruk av KI-systemer. Dette omfatter samsvarsproblemet (the alignment problem), kontrollproblemet og utfordringene med manglende transparens og etterprøvbarhet, bærekraftsutfordringer, utfordringen med reproduksjon av sosiale skjevheter, faren for feilaktige og misvisende resultater, utfordringer for demokratiet, samspillet mellom KI-teknologi og samfunnet og potensialet for manipulasjon. Noen av de etisk-juridiske problemstillingene med KI er også såpass store og såpass symptomatiske for teknologien at kjennskap til dem har en verdi for alle studenter i høyere utdanning, herunder problemstillinger om personvern, opphavsrett og plassering av ansvar for beslutninger og handlinger som er støttet eller utført av et KI-system. Skal integrasjonen av KI i samfunn og arbeidsliv skje på en forsvarlig måte, er det hensiktsmessig at brede lag av befolkningen og arbeidsstyrken har en grunnleggende forståelse av de største problemstillingene teknologien reiser. Se kapittel 4 for en nærmere beskrivelse av de nevnte problemstillingene.
Kjennskap til flere av problemstillingene spiller også en viktig rolle for studentene underveis i utdanningen. Studentene har for eksempel behov for å skjønne hvordan og hvorfor KI-systemer kan gi feilaktige eller misvisende resultater, og de har behov for å være bevisst opphavet til de resultatene de får ut av et KI-system. Sistnevnte er en grunnleggende forutsetning for å utøve kildekritikk.
Forståelse av konsekvenser for tenkning og læring
Som vist i kapittel 6, har KI en tvetydig effekt på læring. Mens det finnes mange muligheter for å fremme egen læring, kan ukritisk bruk av språkmodeller svekke læringsutbyttet og ha uønskede kognitive virkninger.
For studentene, som primært skal lære og som i stor grad styrer sine egne læringsaktiviteter, er det viktig å forstå hvordan deres interaksjon med KI påvirker grunnleggende kognitive funksjoner og prosesser generelt, og læring spesielt. Studenter i alle fag har nytte av å lære hvordan de kan bruke språkmodeller til å understøtte egne læringsprosesser heller enn å kortslutte dem. Dette har ikke bare en verdi underveis i studieløpet, men også for den livslange læringen.
Behovet for slik kunnskap kan sees i sammenheng med behovet for konkret veiledning i bruk av generative KI-systemer i studiearbeidet, et område hvor dagens studenter rapporterer å ha fått utilstrekkelig opplæring (kap. 6.2.4).
5.4.2.2 Fagspesifikk KI-kompetanse
Med «fagspesifikk KI-kompetanse» forstår utvalget to former for læringsutbytte:
-
Ferdigheter som setter en i stand til å bruke eller utvikle KI-systemer for å løse fagspesifikke oppgaver, for eksempel å bruke store språkmodeller for å samle eller analysere store mengder data (jf. Boks 5.2)
-
Fagspesifikk kunnskap om KI, for eksempel en økonoms kunnskap om arbeidsmarkedseffektene av KI-utviklingen eller en filosofs forståelse av talehandlingene til en samtalerobot
Fagspesifikk KI-kompetanse er en bred og viktig kategori. Skal KI i vesentlig grad bidra til at vi utvider vår kunnskap eller øker produktiviteten, vil det trolig skje gjennom fruktbare anvendelser av teknologien i bestemte faglige kontekster. Den kunnskapen og de ferdighetene som kreves for å identifisere og dra nytte av mulighetene KI gir i bestemte fag, er dermed avgjørende.
Videre, skal vi ta kloke beslutninger om hvordan vi innretter våre institusjoner og praksiser i en tid med KI, er vi avhengige av mer enn bare en generell forståelse av teknologien. Vi behøver tilgang på dybdekunnskap om spesifikke sider ved teknologien og de spesifikke måtene den preger samfunnet og livene våre.
På grunn av det høye kompetansenivået blant ansatte og utdanningenes kobling til forskning, står universiteter og høyskoler i en særstilling for å kunne fremme samfunnets tilgang på fagspesifikk KI-kompetanse. For høyere utdannings del vil dette også være et vesentlig ledd i arbeidet med å fremme og opprettholde den faglige kvaliteten i studietilbudene i årene fremover. For sektorens del betyr dette samtidig et stort behov for at ansatte utvikler fagspesifikk KI-kompetanse (se kap. 10).
Den fagspesifikke KI-kompetansen er, per definisjon, ulik i ulike fag. Utviklingen av slik kompetanse er også nødt til å skje i det enkelte fag, på fagets premisser. Boks 5.2, 5.3 og 5.4 gir eksempler på studieemnetilbud der fagspesifikke former for KI-kompetanse er sentrale læringsutbytter.
Boks 5.2 Masteremnet «Transforming Business with AI» ved Norges handelshøyskole
Emnet inngår som et av flere forretningsanalytiske emner ved Norges handelshøyskole. Et av de sentrale målene med emnet har vært å gi studentene ferdigheter til å bruke språkmodeller i stor skala, det vil si gjennom API-forespørsler heller enn ved å sende én og én forespørsel via en samtalerobot.1 En slik teknikk gjør det mulig å utnytte språkmodellenes potensial for å analysere store mengder data – i dette tilfellet: forretningsrelevant informasjon. Emnet tar utgangspunkt i underviserens erfaring med bruk av slike teknikker i egen forskning. I tillegg holder aktører i næringslivet gjesteforelesninger, med det formål at studentene får mer kunnskap om anvendelsesmulighetene i næringslivet. Emnet er bygget opp med praktiske innføringer til programmering i Python, til store språkmodeller og til API-er.
Underviser og emneansvarlig, Ingar Haaland, har meddelt (23. februar 2026) at han revurderer læringsinnholdet i lys av fremskrittene som har skjedd med agentiske systemer.
1 «API» står for application programming interface, og kan oversettes til «programvaregrensesnitt». API-en til et datasystem er broen som forbinder det til andre datasystemer. Gjennom en API kan et system motta forespørsler og sende svar. Der hvor samtaleroboten ChatGPT utgjør et brukergrensesnitt som lar meg og deg interagere med OpenAIs språkmodeller, er API-en det som lar datasystemer interagere med de samme modellene.
Kilder: Emnebeskrivelse på Norges handelshøyskoles nettsider og professor Ingar Haalands presentasjon for utvalget 23. februar 2026
Boks 5.3 Masteremnet «Operations Research 1» ved Universitetet i Tromsø – Norges arktiske universitet (UiT)
Emnet tar for seg matematisk modellering av realistiske, komplekse beslutningsproblemer. Disse problemene kjennetegnes som komplekse ved at de har mange og ofte usikre variabler. De kjennetegnes som realistiske ved at de er hentet direkte fra næringslivet og andre deler av arbeidslivet, for eksempel i logistikk og samferdsel eller i planlegging av produksjon. Studentene skal utvikle en bedre forståelse av slike problemer og hvordan de kan artikuleres presist. Studentene skal så bruke generative KI-systemer og spesialprogramvare for å utvikle optimaliseringsmodeller og simuleringsmodeller.
Optimalisering er det sentrale begrepet i såkalt preskriptiv analytikk (prescriptive analytics). En optimaliseringsmodell finner den løsningen på et problem som, for et gitt mål og definerte parametre, gir størst måloppnåelse. Simulering hører til såkalt deskriptiv analytikk (descriptive analytics). En simuleringsmodell er et verktøy for scenarioanalyse og kan støtte beslutningstakere til å finne robuste løsninger under usikre omstendigheter. Det å bruke generative KI-systemer på en etisk og ansvarlig måte i utvikling av slike modeller, er et fastsatt læringsutbytte i emnet.
Kilder: Emnebeskrivelse på UiTs nettsider og professor Hao Yus presentasjon 22. januar 2026 i forbindelse med prosjektet Nye vurderingsformer ved UiT
Boks 5.4 Bacheloremnet «Kommunikasjon og kulturformidling på digitale flater» ved Høgskolen i Østfold
Emnet gis på lavere grads nivå i språk- og kommunikasjonsfaglige bachelorprogrammer. Etter en fellesdel er emnet delt opp i ulike språkfag. I den spanskspråklige delen av emnet skal studentene produsere falske nyheter ved hjelp av KI-verktøy, blant annet språkmodeller og bildegenereringsverktøy (uten at de blir spredd utenfor undervisningskonteksten). Formålet med øvelsen er å forstå mekanismene bak desinformasjon fra innsiden, parallelt med at studentene får utviklet ferdigheter med bruk av KI-verktøy.
Kilder: Emnebeskrivelse på Høgskolen i Østfolds nettsider og tilsendt dokumentasjon fra Østfold AI Hub
5.5 Forholdet til menneskelig kompetanse
Til tross for at KI-systemer bearbeider informasjon på en helt annen måte enn mennesker, har systemene fått kapabiliteter som i mange tilfeller utgjør direkte motsvar til menneskelige ferdigheter. De kan for eksempel identifisere argumenter i en tekst, finne bevis for matematiske teoremer eller forutsi været. Det at vi har fått tilgang på systemer som kan løse intellektuelt krevende oppgaver som disse, reiser en bred utfordring for nytteverdien av læringsutbyttene man kan få ut av høyere utdanning. Når vi vurderer hva som er formålstjenlig å lære – både med henblikk på faglig kvalitet og på samfunns- og arbeidslivsrelevans – må vi ta høyde for hva maskiner kan løse bedre eller mer effektivt enn mennesker.
Automatiseringspotensialet i tidligere digitale teknologier har vært begrenset av at oppgavene må kunne kodifiseres med regler, altså har kun rutinepregede, regelstyrte oppgaver vært utsatt for automatisering (Autor et al., 2003). Maskinlæringsteknikker har i praksis opphevet denne begrensningen (Brynjolfsson et al., 2018). Mens automatiseringen av en oppgave reduserer nytteverdien av kunnskapen og ferdighetene som tidligere var nødvendig for å løse oppgaven, kan kunnskaper og ferdigheter som komplementerer KI-systemenes kapabiliteter, få større verdi, relativt sett.
Foruten at KI-systemer kan brukes til å automatisere oppgaver, kan de også endre betydelig på hvordan vi løser oppgaver. KI-systemer kan for eksempel brukes til å få løsningsforslag som vurderes av mennesker, eller til å kvalitetssikre menneskeskapte løsningsforslag. I slike tilfeller forblir menneskers selvstendige evne til vurdering viktig.
For å forstå det komplekse forholdet KI står i til menneskelig kompetanser, og de logiske følgene det har for hva vi skal lære, er følgende momenter av betydning.
-
Erstatning vs. komplementering. Et KI-system kan, for en gitt oppgave, komplementere heller enn erstatte menneskelig kompetanse (Autor, 2015).
-
Dekomponering av oppgaver. Oppgaver er ikke faste størrelser, men kan stykkes opp i deloppgaver eller settes sammen til større oppgaver. KI-systemer kan være i stand til å utføre deler av det vi ordinært regner som én oppgave. Her er det sammenheng med forrige punkt: Det å bruke et KI-system som hjelpemiddel til en oppgave kan innebære automatisering av en deloppgave.
-
Forholdet mellom oppgaver og læringsutbytter. Arbeidsoppgaver står i komplekse forhold til ulike former for læringsutbytte. Yrker og utdanninger står allerede i et komplekst forhold: Man kan kvalifisere for flere yrker gjennom en gitt utdanning, og flere utdanninger kan gi kvalifikasjoner for et gitt yrke. På et mer finmasket analysenivå – med oppgaver heller enn yrker og læringsutbytter heller enn utdanninger – er forholdene enda mer komplekse.
Til tross for at disse momentene kompliserer bildet, er det klart at effektene KI vil ha på arbeidslivet, vil ha implikasjoner for hva det er formålstjenlig å lære. Følgende underkapittel beskriver kunnskapsgrunnlaget som foreligger om hvilke deler av arbeidslivet som er mer eksponert for påvirkning av KI (5.5.1). Dernest gir utvalget sin vurdering av hva vi kan trekke ut av dette kunnskapsgrunnlaget (5.5.2).
5.5.1 Kunnskapsgrunnlaget om KI-eksponering
Det er gjennomført flere studier av hvilke arbeidsoppgaver som er mer eksponert for påvirkning av KI. Dette inkluderer studier av hva slags oppgaver som er disponert for å kunne løses ved hjelp av maskinlæring, med utgangspunkt i egenskaper ved henholdsvis oppgavene og maskinlæring som teknikk (Brynjolfsson et al., 2018; Felten et al., 2021). Det inkluderer også studier som mer spesifikt undersøker hvilke arbeidsoppgaver generative KI-systemer er i stand til å løse, eller effektivisere løsningen av (Eloundou et al., 2023; Felten et al., 2023; Handa, Tamkin, et al., 2025; Massenkoff & McCrory, 2026).7
I en innflytelsesrik studie tar Eloundou et al. (2023) utgangspunkt i en offentlig amerikansk database (O*NET) med definisjoner av yrker, oppgaver og grovt definerte ferdigheter, samt koblinger mellom disse. De kartlegger KI-eksponering ved å klassifisere oppgaver etter hvorvidt tiden det tar å gjennomføre dem kan halveres ved bruk av en stor språkmodell.8 Samlet finner de at dette gjelder 15 prosent av alle arbeidsoppgaver i databasen.
Eloundou et al. gjør videre analyser av hva slags ferdigheter og utdanningsnivå som er forbundet med KI-eksponering. De finner at oppgaver og yrker som typisk sett forutsetter høyere utdanning, er mer berørt enn dem som ikke forutsetter høyere utdanning. Når det gjelder bestemte ferdigheter, finner de riktignok at ferdigheter i kritisk og vitenskapelig tenkning er negativt korrelert med KI-eksponering. På den andre siden finner de at ferdigheter i programmering og skriving er positivt korrelert med KI-eksponering. Hovedfunnene til Eloundou et al. har støtte i studiene til Handa, Tamkin, et al. (2025) og Massenkoff og McCrory (2026).
Vigtel (2025) har brukt eksponeringsverdiene til Eloundou et al. for å si noe om KI-eksponeringen i norsk arbeidsliv, gjennom å koble amerikanske yrkes- og oppgavedata (O*NET) til norske definisjoner (STYRK-08) og annen SSB-data. Også i Norge er yrker som forutsetter høyere utdanning, mer eksponert for generativ KI enn yrker som ikke forutsetter høyere utdanning. 20,3 og 23 prosent av jobbene til dem med henholdsvis bachelorgrad og mastergrad eller høyere blir funnet å være KI-eksponert i Vigtels studie, sammenliknet med 16,8 prosent i arbeidsstyrken totalt (Vigtel, 2025, s. 18). Blant faggruppene på mastergradsnivå er økonomiske og administrative fag (25,7 prosent), ingeniørfag (25,1 prosent) samfunnsvitenskapelige fag (24,6 prosent) og juridiske fag (24,3 prosent) mer eksponert enn snittet, mens pedagogiske fag (18,2 prosent) og humanistiske fag (21,7 prosent) ligger under snittet (Vigtel, 2025, s. 18).
Merk at Eloundou et al., og dermed også Vigtel, tar utgangspunkt i GPT-4 og hva man kan løse ved hjelp av denne modellen. For så vidt som nyere grunnmodeller og systemene bygget på dem er mer kapable, vil man kunne få høyere eksponeringsverdier med samme metode.
Studiene ovenfor viser ikke – annet enn ved usikre tegn (Handa, Tamkin, et al., 2025, s. 9–10) – om påvirkningen vil ta form som erstatning eller som komplementering av menneskelig kompetanse. Studien til Brynjolfsson et al. (2025) utgjør i så måte et skritt fremover, ved å koble data om KI-eksponering med sysselsettingsdata. Hovedfunnet deres er at sysselsettingen blant unge i USA synker i de yrkene som er mest eksponert for påvirkning av generativ KI. Funnet kan forklares med at arbeidsgivere ser et mindre behov for uerfarne arbeidstakere i takt med at de får tilgang på bedre generative KI-systemer. Studien har skapt mye diskusjon og har blant annet blitt kritisert for å ikke ta høyde for at flere unge jobber oppdragsbasert, frilans og tilsvarende (Casilli, 2025). Selv om man antar at funnet er robust, er det imidlertid usikkert hvordan en slik mekanisme vil utspille seg over tid: Effekten kan f.eks. utvide seg til å omfatte mer erfarne arbeidstakere, eller den kan minke dersom arbeidsgivere tar grep.
Resultater fra Kandidatundersøkelsen 2025 viser at arbeidsledigheten blant nyutdannede masterkandidater har gått opp tre prosentpoeng i perioden 2023–2025, en økning som er høyere enn den for befolkningen samlet sett (Ballo & Wiers-Jenssen, 2026, s. 14). Det er mange mulige forklaringer på utviklingen som ikke har med KI å gjøre, men det kan heller ikke utelukkes at KI-utviklingen spiller en rolle. Kandidatundersøkelsen 2025 viser ellers at andre former for mistilpasning til arbeidsmarkedet har ligget stabilt for nyutdannede i perioden.
Hernæs og Kostøl (2026) har utviklet en indeks for å spore sysselsettingen i KI-eksponerte yrker sammenliknet med lite eksponerte yrker. I likhet med Vigtel har de koblet eksponeringsmålet til Eloundou et al. sammen med norsk yrkesklassifikasjon (STYRK-08), men tilbyr også et alternativt eksponeringsmål fra Mouchel et al. (2026). Per oktober 2026 viser indeksen en positiv sysselsettingsutvikling i yrkene som er mer KI-eksponert, sammenliknet med de mindre eksponerte, under begge eksponeringsmål.
Kompetansebehovsutvalget (2025) har gjennomgått mye av kunnskapsgrunnlaget som foreligger om KIs automatiseringspotensial og øvrige virkning på arbeidslivet. De vurderer at
Det er rimelig å anta at generativ KI i større grad enn tidligere digitale teknologier vil kunne løse en del oppgaver som høyt utdannede kunnskapsmedarbeidere gjør i dag. […] Digital teknologi og kunstig intelligens vil over tid kunne ta over stadig flere oppgaver. (Kompetansebehovsutvalget, 2025, s. 86, 95)
Kompetansebehovsutvalget viser samtidig at det eksisterende kunnskapsgrunnlaget gir oss langt fra noe sikkert utgangspunkt for å forutsi hvordan KI vil endre arbeidslivet. Kompetansebehovsutvalget har også tegnet opp scenarioer for fremtidens kompetansebehov, som vist i Figur 5.2.
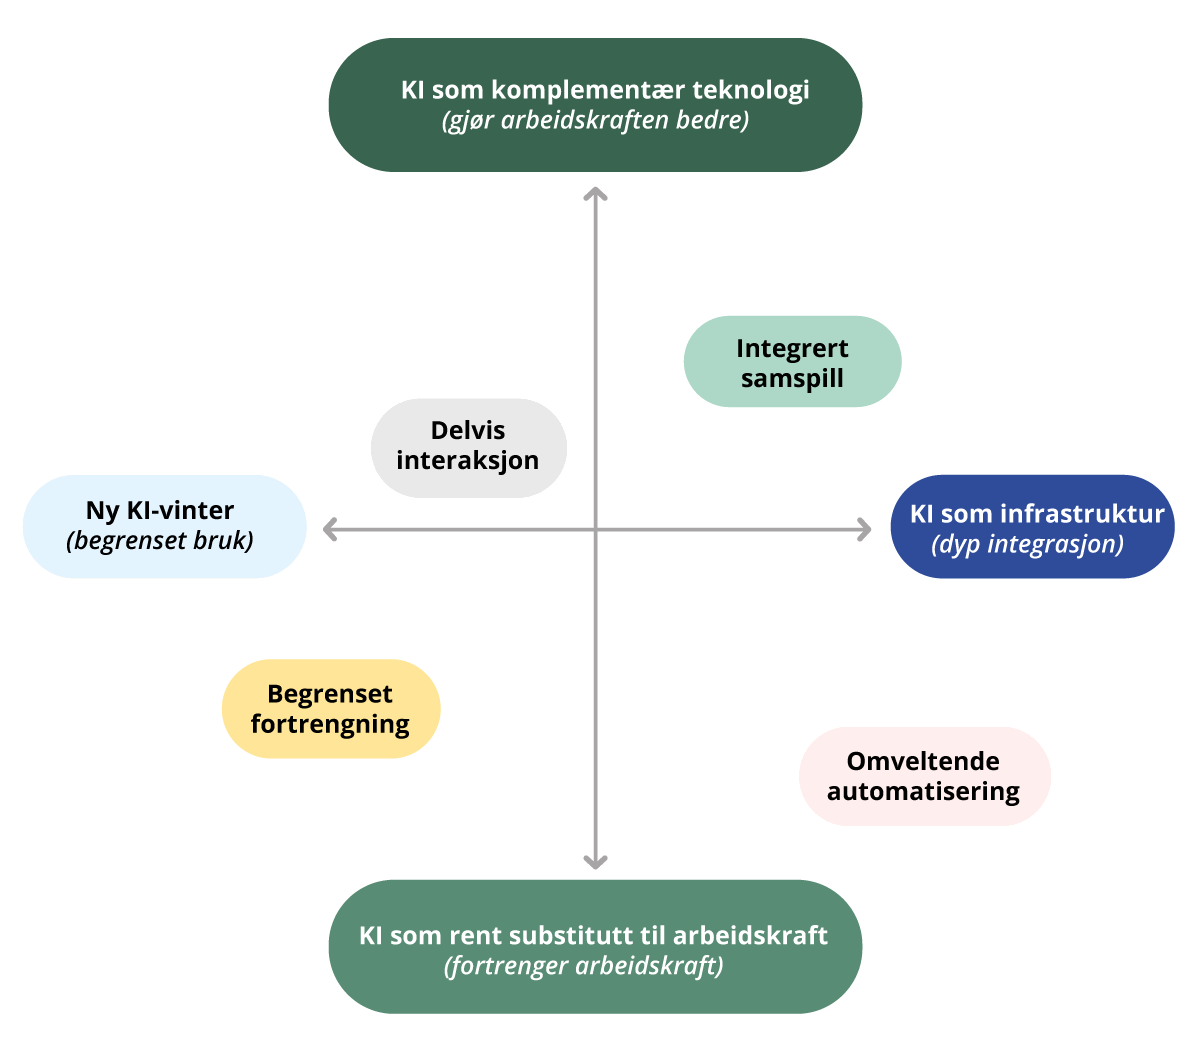
Figur 5.2 Kompetansebehovsutvalgets scenarioer for fremtidens arbeidskrafts- og kompetansebehov i en digital omstilling
Kilde: Kompetansebehovsutvalget, 2025, s. 89
Tabell 5.1 Kompetansebehovsutvalgets egne beskrivelser av scenarioene i Figur 5.2.
|
Tolkning av plassering i scenario-figur |
Arbeidskrafts- og kompetansebehov |
|
|---|---|---|
|
Scenario 1: Delvis integrasjon |
KI virker mer komplementært enn som et rent substitutt. KI-bruk er moderat. |
Arbeidskraftbehovet består og det er samtidig behov for god kompetanseutvikling og tilpasning. Det er særlig behov for generell og fagspesifikk digital kompetanse, så vel som fagkompetanse. |
|
Sammenlikning av de tre andre scenarioene, relativt til Scenario 1 |
||
|
Scenario 2: Integrert samspill |
KI virker i enda større grad komplementært. KI-bruk er dypere integrert. |
Større behov for kompetanseutvikling og endrede yrkesvalg. Økt behov for spesialisert digital kompetanse, kritisk tenkning, juridisk kompetanse og innovasjonskompetanse. Vridning mot yrker som er i samspill med KI. |
|
Scenario 3: Begrenset fortrengning |
KI virker i nokså stor grad som et rent substitutt til arbeidskraften. Men: KI-bruken er begrenset. |
Arbeidskraftbehovet faller kraftig i yrker der oppgavene enklest kan tas over av en maskin. Vridning i kompetansebehovene skjer gradvis ettersom KI-bruken er begrenset. |
|
Scenario 4: Omveltende automatisering |
KI virker i stor grad som et rent substitutt til arbeidskraften. I tillegg: KI-bruk er dypt integrert. |
Arbeidskraftbehovet faller kraftig på tvers av yrker og næringer. Behov for nytenkning. Å beholde jobben kan kreve både spesialisert digital kompetanse og innovasjonskompetanse. Norsk modell under press? |
Kilde: Kompetansebehovsutvalget (2025, s. 92)
5.5.2 Utvalgets vurdering
Kunnskapsgrunnlaget om KI-eksponering er ikke så velutviklet at vi kan trekke robuste eller detaljerte slutninger om KIs påvirkning på arbeidslivet eller fagene i høyere utdanning. Det er derfor i stor grad uvisst hvilke oppgaver som er disponert for å bli automatisert, og hvilke oppgaver hvor KI vil spille en vesentlig rolle som hjelpemiddel.
Kunnskapsgrunnlaget viser likevel at det er sannsynlig at KI vil ha en stor påvirkning, og særlig på den delen av arbeidslivet som kandidater fra høyere utdanning skal ta del i. En slik vurdering har støtte i kompetansebehovsutvalgets vurderinger og har ytterligere støtte i det vi vet om teknologiutviklingen (jf. kap. 3 og 5.3.1).
Av det som fremkommer i kunnskapsgrunnlaget, er oppgaver knyttet til programmering og tekstbehandling særlig påvirket.
Det er viktig å bemerke at det har vært betydelige teknologiske fremskritt siden mye av det beskrevne kunnskapsgrunnlaget ble utviklet. Gjennom 2025 ble det utviklet bedre resonnerende modeller og agentiske systemer, noe som ga utslag i store kapabilitetsfremskritt i områder som programmering og matematikk ved årsskiftet 2025–2026.
Vi kan oppsummere det vi vet som følger:
-
KI-systemer vil sannsynligvis ha sterk påvirkning på hvordan svært mange oppgaver blir løst, av det som i dag blir løst av kandidater fra høyere utdanning.
-
Det er generelt usikkert hvilke oppgaver som vil bli sterkest påvirket, og om påvirkningen vil skje som automatisering, delautomatisering eller ved at oppgavene blir løst med KI-systemer som (komplementært) hjelpemiddel.
-
Store språkmodeller, og systemene som bygger på dem, har i dag størst påvirkning på oppgaver knyttet til programmering, matematikk og tekstbehandling.
Punkt 1 innebærer at vi sannsynligvis står overfor store endringer i hva slags læringsutbytte som vil ha størst nytteverdi i arbeidslivet og som forutsetninger for kyndig fagutøvelse. Dette reiser en utfordring for universiteter, høyskoler og det enkelte fagmiljø, som skal utvikle læringsinnholdet i studietilbudene i møte med slike endringer. Punkt 2 innebærer at vi har et svakt utgangspunkt for å foregripe endringene som kommer. Dette setter premissene for hvordan man kan tilnærme seg utfordringen. I avsnittene nedenfor gir utvalget generelle vurderinger av utfordringen og hvordan man kan tilnærme seg den. Utvalgets vurdering av hvordan bestemte typer læringsutbytte blir berørt, gis i kapittel 5.6.
Store endringer med ukjente konturer
Det er sannsynlig at fagene i høyere utdanning og arbeidslivet generelt står overfor store endringer, både i hva slags oppgaver vi løser og hvordan vi løser dem – eventuelt hva som løser dem. Endringene drives frem gjennom en kombinasjon av teknologiske fremskritt og prøving og feiling i faglige praksiser. Noen av endringene ser vi også klare tilløp til i dag (jf. kap. 5.4 og 5.6). Samtidig er det svært vanskelig å foregripe alle endringene som kommer, idet man skal utvikle studietilbudenes læringsinnhold.
KI-utviklingen tillater ikke at man setter seg ned én gang for å fremtidssikre en utdanning. For det første er det få typer læringsutbytte, om noen, som kan regnes som «KI-sikre». Målet må være å utvikle studietilbudenes læringsinnhold med bevissthet om KI og KI-systemenes kapabiliteter (jf. Massachusetts Institute of Technology, 2026. kap. 3.1.1). For det andre er det å tilpasse studietilbudenes læringsinnhold til nye teknologiske betingelser et arbeid som er nødt til å skje løpende. KI-utviklingen vil kreve at fagmiljøene, i dialog med omverdenen, regelmessig diskuterer og revurderer hvilke kunnskaper og ferdigheter deres studietilbud er innrettet mot å gi, og hva som eventuelt mangler av læringsinnhold, for at studentene skal utvikle seg som kyndige fagutøvere tilpasset sin tid.
Når teknologien endrer seg fort og beslutninger om læringsinnhold må tas under usikkerhet, er det behov for institusjonelle rammer som gjenspeiler dette. Gjennom gode muligheter for utprøving av endringer i studietilbudene, for eksempel gjennom opprettelse av nye studieemner eller endring og utvikling av studieplaner, vil fagmiljøene mer effektivt kunne finne ut hva som er verdt å videreføre. Av samme grunn er det en fordel å legge til rette for at det kan gå kort tid fra idé til handling i utprøving av endringer i studietilbudene.
Nødvendig tilegnelse av grunnleggende læringsutbytter
Læring skjer ikke ved at man tilegner seg isolerte stykker med kunnskap ett og ett, men gjennom en sammensatt prosess hvor noen læringsutbytter bygger på andre (jf. kap. 6). For eksempel er det vanskelig å lære seg multiplikasjon uten først å lære seg addisjon. Læringsutbytter kan også gjensidig bygge på hverandre. For eksempel innebærer teorianvendelse en form for gjensidig forsterkende læring. Man får en bedre forståelse av teorien ved å anvende den, og parallelt får man en bedre forståelse av det som man anvender teorien om.
Det å bli en kyndig fagutøver – en som kan tenke som en fysiker, som en lærer eller som en filosof – innebærer å lære seg en rekke ting som vi isolert sett kunne overlatt til KI-systemer å løse. KI-systemer kan gi utmerkede løsninger på svært mange av de oppgavene studenter blir bedt om å besvare gjennom sine utdanningsløp, enten det handler om å forklare hva som ligger i et begrep eller en teori, å identifisere argumentet i en tekst eller å gjengi etablert, vitenskapelig kunnskap. Mange slike læringsutbytter er imidlertid viktige for at man skal tilegne seg et læringsutbytte som går utover hva maskiner kan eller bør løse. For eksempel er det å utvikle en forståelse av begreper og teorier i sitt fagfelt en forutsetning for å kunne problematisere dem, og videre, for selv å kunne bidra til å utvikle nye begreper og teorier.
Teknologiavhengighet
Slutter vi å tilegne oss bestemte kunnskaper eller ferdigheter, basert på at KI-systemer kan forsyne oss med det vi trenger, så gjør vi oss avhengig av KI for det formålet. Dette kan være risikabelt, sett i lys av KI-systemers typiske underskudd på transparens, etterprøvbarhet og forklarbarhet (jf. kap. 4). Risikoene som følger av slik avhengighet, bør vurderes konkret ved større endringer i studietilbudenes læringsinnhold.
Langsiktighet og dannelse
På sitt beste gir høyere utdanning studentene et varig læringsutbytte med en verdi som går utover den nytten det har i bestemte arbeidskontekster. Kanskje får man ikke anvendt alt man har lært direkte i de jobbene man går inn i etter endt utdanning, men ferdighetene man utvikler og den ofte abstrakte kunnskapen man tilegner seg, kan vise sin nytte og sin verdi over et livsløp, i og utenfor arbeid.
Det å tilegne seg begreper, lære seg teorier og metoder, bli kjent med fremragende bidrag i filosofi- og vitenskapshistorien, det å lære seg å tenke kritisk, kreativt og selvstendig, og å kunne uttrykke seg klart, alt dette er læringsutbytter som er verdt å etterstrebe for sin egen skyld, som noe iboende verdifullt. Verdien av dannelse opphører ikke i møte med KI.
5.6 Utvalgets vurdering av hvordan utvalgte former for læringsutbytte blir påvirket av KI-utviklingen
5.6.1 Programmeringsferdigheter
Store språkmodeller og systemene som bygger på dem, som agentiske systemer, har utviklet seg til å bli særlig gode på programmering.9 Gjennom enkle instruksjoner gitt i naturlig språk, kan man få velfungerende programkode i retur.
Dette gjør at programmering ikke lenger er forbeholdt dem som kan skrive programkode manuelt. Det kan slik sett redusere behovet for å utvikle tekniske ferdigheter i programmering for ikke-spesialister. For eksempel kan samfunnsvitere og medisinere enklere kode regresjonsanalyser med hjelp fra KI-systemer.
Behovet for tekniske ferdigheter i programmering opphører ikke dermed. Programmeringsferdigheter vil trolig ha en verdi både for å skjønne hva slags programmer det kan være mulig å skrive og hvordan de fungerer, for å identifisere og utbedre feil og ineffektive løsninger, og for å utvikle programkode som tilgjengelige KI- systemer ikke får til å utvikle.
I grove trekk tyder utviklingen på et skifte fra produksjonsevne til vurderingsevne. Det å produsere programkode har blitt forholdsvis enkelt med dagens KI-systemer, mens det fortsatt er et behov for å kunne vurdere programkode. I seg selv er dette en vesentlig endring, men den praktiske betydningen må utforskes. Et viktig spørsmål blir i hvilken utstrekning disse produksjons- og vurderingsferdigheter kan skilles fra hverandre: Hvor god kan man bli på å vurdere programkode uten å produsere det? Hvis målet er å bli god på å vurdere programkode, uten nødvendigvis å kunne produsere det, hvor annerledes ser de mest effektive læringsløpene ut? Dette er spørsmål som vi bare får gode svar på gjennom utprøving i praksis.
5.6.2 Matematisk problemløsning
Et annet område hvor de fremste språkmodellene har utviklet seg til å bli spesielt gode, er i matematikk, og nærmere bestemt i matematisk problemløsning.10 Det er verdt å presisere at modellene er høyst feilbarlige og kan produsere skinnbevis. Allikevel har språkmodeller gjennom det siste året blitt brukt til å lage verifiserte løsninger på mange hittil uløste problemer, blant annet mange av de såkalte Erdős-problemene.
8. september 2026 kunngjorde OpenAI (2026) at et internt KI-system hadde løst et av de syv såkalte millenniumsprisproblemene i matematikk (om Navier-Stokes-likningene). Hendelsen illustrerer flere aspekter ved utviklingen av KI i matematikk. For det første gir hendelsen nok en indikasjon på hvilken kapabilitet dagens KI-modeller har innenfor matematisk problemløsning. For det andre illustrerer hendelsen en tendens til at løsningen på matematiske problemer nå blir lansert utenfor tradisjonelle fora med tilhørende normer for hvordan bevis skal presenteres og forklares. For det tredje er det ikke klart hvilke menneskelige bidrag som har vært avgjørende for at systemet kunne komme frem til løsningen: Beviset til OpenAIs modell speiler – og muligens utnytter det – arbeid som ble utført parallelt av Tristan Buckmaster og Levent Alpöge (Buckmaster, 2026; OpenAI, 2026). De to sistnevnte aspektene bidrar til å gjøre KIs betydning for matematikkfaget mer problematisk.
Den ledende matematikeren Terence Tao (2026) viser hvordan utviklingen av mer kapable modeller gjør det nødvendig å vurdere nærmere hva som inngår i matematisk problemløsning, og hva vi ønsker å få ut av aktiviteten. Der hvor bevisutvikling tidligere har vært forstått som en sammensveiset aktivitet, kan vi nå skille mellom produksjon av bevis, verifisering av bevis, forklaring av bevis, formidling av bevis og «kanonisering» av bevis (Tao, 2026).11 Et hovedpoeng er at matematiske bevis har liten verdi for oss med mindre vi kan forstå dem, bekrefte at de holder og formidle dem til fagfeller og studenter.
Som for programmering, har ikke behovet for menneskelig kompetanse i matematisk problemløsning opphørt, men vi ser at menneskers rolle kan dreie seg bort fra ren produksjon og over på verifisering, forklaring og formidling. Som for programmering, er det også her et ubesvart spørsmål i hvilken utstrekning ferdigheter i verifisering mv. kan utvikles uavhengig av evnen til å produsere løsninger. Igjen tilsier utviklingen et behov for utprøving.
5.6.3 Lesing og skriving
Et tredje område hvor store språkmodeller har betydelige styrker, er å analysere, sammenfatte og produsere tekst i naturlig språk. KI-systemene har med dette en overlappende funksjon med lesing og skriving, forstått som menneskelige ferdigheter. I stedet for selv å lese en tekst og formidle innholdet til andre, kan man la et KI-system raskt prosessere og sammenfatte innholdet i teksten, under hvilke føringer man måtte gi. Tilsvarende kan tekstskriving overlates til KI-systemer uten at kvaliteten på produktet nødvendigvis blir dårligere.
Det at det er blitt mulig å overlate ulike typer lese- og skriveoppgaver til KI-systemer, endrer likevel ikke verdien av det å kunne lese og skrive godt. Lesing og skriving har lenge vært helt sentrale virkemidler for å lære seg å tenke klart, kritisk og kreativt. Ved å lære seg å lese og skrive argumenterende tekster med avansert innhold, lærer man seg å forstå og selv utforme logiske resonnementer og analyser av saksforhold.
Skriftspråket disiplinerer oss som tenkere. Gjennom å uttrykke ideene våre i skriftlig form kan vi for eksempel oppdage at ideen vi hadde ikke var like klar eller velbegrunnet som vi trodde. Tilsvarende kan vi, når vi leser, gå forfatterens tankerekke nøye etter i sømmene.
Av disse grunnene er det ikke ønskelig å la våre skrive- og leseferdigheter bli erstattet av KI-systemenes kapabiliteter. Lesing og skriving er i praksis grunnleggende forutsetninger for det læringsutbyttet høyere utdanning skal gi oss.
For avgrensede formål kan det likevel være hensiktsmessig å overlate lese- og skriveoppgaver til KI-systemer. For eksempel kan det være hensiktsmessig å la et KI-system sile store tekstmengder for relevans, dersom man er ute etter informasjon om et bestemt tema eller en bestemt problemstilling. Eller man kan bruke KI-systemer for å omarbeide muntlige presentasjoner man har holdt (i muntlig stil), til artikkelutkast som kan bearbeides videre.
Lese- og skriveferdigheter er også under press fra maskinlæringsalgoritmer som er trent for å maksimere engasjementet til brukere av nettplattformer og strømmetjenester. Det er vanskeligere å opprettholde konsentrasjon til lesing og skriving jo flere og mer kapable krefter som konkurrerer om vår oppmerksomhet. Verdien av lese- og skriveferdigheter blir ikke mindre av dette. Snarere blir det trolig enda viktigere å hegne om lese- og skriveferdigheter, også i høyere utdanning, sett i lys av deres betydning for tenkning. Se også kapittel 6 om bruk av KI-systemer i bestemte læringsaktiviteter.
5.6.4 Fagkunnskap
Med utviklingen av internett har fagkunnskap, bredt forstått som substansiell kunnskap om et domene, blitt mer tilgjengelig enn tidligere. KI-systemer tar dette et skritt videre. Språkmodellbaserte KI-systemer kan hente frem innholdet i svært mange kilder til fagkunnskap, i det formatet, omfanget og den presentasjonsstilen man ønsker. I tillegg kan man kan lettere finne frem til autoritative kunnskapskilder med KI-forsterkede søk.
Selv om vi har bedre tilgang på fagkunnskap enn noen gang, er det å tilegne seg fagkunnskap stadig avgjørende. Det er flere grunner til dette.
For det første er det noe annet å ha innarbeidet kunnskap i eget langtidsminne enn å ha kunnskapen tilgjengelig på en maskin. Hvis man ikke har kunnskapen i hodet, vet man ikke når den er relevant å ta i betraktning, og det blir vanskeligere å bruke kunnskapen i resonnementer.
For det andre er det nødvendig å tilegne seg fagkunnskap for å utvikle høyere ordens ferdigheter, slik som ferdigheter i kritisk tenkning. Fagkunnskapen kan slik sett ha en viktig rolle i et bredere læringsløp.
For det tredje er fagkunnskap en betingelse for å kunne vurdere og verifisere KI-formidlet og KI-generert informasjon. Vet man ikke nok om et saksfelt, blir det vanskelig å ta kritisk stilling til den informasjonen man blir formidlet om saksfeltet. Fagkunnskap er slik sett en muliggjørende kompetanse for ansvarlig bruk av KI-systemer.
Disse tre argumentene tilsier ikke at alt som i dag går under rubrikken fagkunnskap, må stå fast i studietilbudene. Utvalgets vurdering er at fagkunnskap som bred kategori forblir like viktig som før. I noen tilfeller kan det også være behov for høyere nivåer av fagkunnskap (se kap. 5.8).
5.6.5 Kritisk tenkning
Kritisk vurdering av informasjon er avgjørende for kollektiv kunnskapsdannelse i et mer krevende informasjonslandskap. Skal vi treffe gode beslutninger i møte med en transformativ teknologi som KI, må vi også kunne tenke kritisk om hvordan teknologien preger samfunnet og livene våre. Kritisk tenkning er slik sett en muliggjørende kompetanse for ansvarlig integrasjon av KI i fag, samfunn og arbeidsliv. Verdien av å kunne tenke selvstendig og kritisk er etter alt å dømme blitt større med KI-utviklingen.
Det å lære seg å tenke kritisk, er et helt grunnleggende læringsutbytte i høyere utdanning. Kritisk tenkning er imidlertid ikke en ferdighet man kan besitte uten å besitte en rekke andre ferdigheter og stykker med kunnskap. Å kunne tenke kritisk kan innebære å beherske faglige begreper og metoder, kjenne til slutningsregler og typiske slutningsfeil, besitte fagkunnskap, å kunne tenke abstrakt og hypotetisk osv.
En dimensjon av kritisk tenkning som er særlig berørt av KI, gjelder kildebruk og kildekritikk. God kildebruk og henvisningspraksis er en grunnleggende del av hvordan akademisk kunnskap utvikles og etterprøves. Generative KI-systemer er ikke kunnskapskilder på linje med fagfellevurderte publikasjoner, men de kan formidle innhold fra kunnskapskilder – med eller uten korrekte henvisninger – og de kan spille andre roller i kunnskapsutvikling. Å kunne tenke kritisk om informasjonen som kommer ut av et generativt KI-system er også en vesentlig del av det å utvikle seg som kritisk tenkende i dag.
5.6.6 Problemforståelse
Idet KI-systemer blir sterkere integrert i arbeidsprosesser på ulike måter, blir problemforståelse viktigere som et læringsutbytte. Det å ha en god problemforståelse er en betingelse for å få nyttiggjort seg KI-systemer og KI-teknikker for å løse et gitt problem.
Det viktigste man kan gjøre for å få god kvalitet på bidragene fra et KI-system drevet på store grunnmodeller, er å gi systemet klare og formålstjenlige instruksjoner. I praksis krever dette en god forståelse av problemet man ønsker å løse. Tilsvarende er en maskinlæringsalgoritme avhengig av et veldefinert mål som systemet kan trenes for. Med en god problemforståelse kan man lettere se hvilke deler av problemet som kan løses ved hjelp av maskinlæringsteknikker.
Nytten av en god problemforståelse har også å gjøre med hvordan man organiserer arbeidsprosesser. KI-systemenes kapabiliteter står ikke i et enkelt forhold til menneskelige yrker, og det er derfor lite sannsynlig at yrker vil bli erstattet ett etter ett, i den grad arbeidsoppgaver automatiseres. KI-systemer vil kunne løse mer spesifikt definerte oppgaver selv om de ikke løser alt som hører til et yrke eller en arbeidsrolle, eller deloppgaver av disse igjen (jf. kap. 5.5 om dekomponering av oppgaver). Her spiller problemforståelse inn: Det å ha en god forståelse av hvilket problem man ønsker å løse gjør at man kan se hvordan problemet kan stykkes opp i mindre problemer. Da kan man lettere se hvilken rolle KI-systemer kan spille i løsningen av det større problemet.
5.7 Dagens regulering av læringsutbytte
Læringsinnholdet i høyere utdanning er regulert nasjonalt gjennom Nasjonalt kvalifikasjonsrammeverk for livslang læring (NKR), som setter overordnede rammer for hva slags læringsutbytte studentene skal oppnå gjennom å ta utdanning på ulike nivåer. NKR er laget i samsvar med Det europeiske kvalifikasjonsrammeverket for livslang læring (EQF) og har som formål å stimulere til livslang læring og mobilitet over landegrenser.
Universitetene og høyskolene har myndighet og plikt til å fastsette og beskrive læringsutbyttene for sine studietilbud, i samsvar med NKR (universitets- og høyskoleforskriften § 1-11 c). Enkelte utdanninger har også nasjonale, forskriftsfestede rammeplaner, som gir mer detaljerte rammer for hva slags læringsutbytte de berørte utdanningene skal gi.
5.7.1 Forskrift om NKR og EQF
Nasjonalt kvalifikasjonsrammeverk for livslang læring beskriver de formelle nivåene på kvalifikasjoner i det norske utdanningssystemet, fra grunnskole til doktorgrad (forskrift om NKR og EQF). NKR gir overordnede beskrivelser av hva en kandidat skal ha lært etter fullført utdanning på et gitt nivå, med progressivt større og mer komplekst læringsutbytte jo høyere nivået er. NKR gir dermed overordnede rammer for hva studenter skal lære. Nivåbeskrivelsene er delt inn i kategoriene kunnskap, ferdigheter og generell kompetanse.
Av høyere utdanningstilbud er bachelorgraden innplassert på nivå 6, mastergrader på nivå 7 og doktorgrader på nivå 8. Læringsutbyttebeskrivelsene i NKR er overordnede og gjelder uavhengig av fagområde. For eksempel skal en masterkandidat ha «avansert kunnskap innenfor fagområdet og spesialisert innsikt i et avgrenset område» (forskrift om NKR og EQF, vedlegg I).
Læringsutbyttet for hvert studietilbud skal beskrives i samsvar med NKR. Læringsutbyttebeskrivelsene for enkeltstudier fungerer dermed som operasjonaliseringer av NKRs skjematiske beskrivelser.
I tråd med Stortingets vedtak om å åpne for at høyere yrkesfaglig utdanning (fagskoleutdanning) kan gi kompetanse på nivå 6–7 i en egen yrkesfaglig søyle, er det nå en pågående prosess med å endre NKR. I denne sammenhengen blir også beskrivelsene for høyere utdanning, nivå 6–8, revurdert for å ivareta helheten. Regjeringen har gitt HK-dir i oppdrag å utvikle et forslag til nye nivåbeskrivelser, hvor kompetanse knyttet til «internasjonalisering, innovasjon og digitalisering og norsk fagspråk» skal inngå (Kunnskapsdepartementet, 2026b).
5.7.2 Nasjonale rammeplaner
Universitets- og høyskoleloven § 3-8 gir Kunnskapsdepartementet hjemmel til å fastsette forskrift om nasjonale rammeplaner for enkelte studier. Dette er gjort for lærerutdanningene og profesjonsutdanninger innenfor helse- og sosialfag (Kunnskapsdepartementet, 2025b).
Alle de forskriftsfestede rammeplanene regulerer utdanningenes læringsutbytte. Noen rammeplaner gjenspeiler krav fra EUs yrkeskvalifikasjonsdirektiv. Utdanningene er med dette regulert på et mer detaljert nivå enn hva samsvar med NKR krever, men fortsatt ikke på et så detaljert nivå at man ikke vil finne variasjon på tvers av institusjoner. Detaljnivået på bestemmelsene i rammeplanene varierer mye, og dermed varierer det også hva slags handlingsrom de etterlater til universitetene og høyskolene.
For lærerutdanninger er det per i dag én rammeplan for hver av de elleve utdanningene. Det pågår en prosess med å endre disse, herunder hvordan utdanningenes læringsutbytte er regulert. Målet for arbeidet har endret seg underveis, fra å gjøre styringen «mer overordnet» til at styringen skal bli «bedre og tydeligere» (Kunnskapsdepartementet, 2026a). Som en del av arbeidet er det foreslått å redusere dagens elleve rammeplaner til to rammeplaner: Én rammeplan for (ikke-samisk) lærerutdanning og én for samisk lærerutdanning. I departementets (2026a) forslag, som høsten 2026 er på høring, er det lagt opp til at forskriften skal ha en hoveddel med felles kjernekompetanser for alle lærere, og underkapitler for ulike undervisningskontekster (barnehage, trinn 1–4, 5–7, 8–10, studieforberedende VGO, videregående fag- og yrkesopplæring). Underkapitlene gir nærmere krav om læringsutbyttet i lærerutdanningene som skal gjøre studentene kvalifisert for gjeldende undervisningskontekst.
For profesjonsutdanningene i helse- og sosialfag er det én felles rammeplan, samt utfyllende rammeplaner («retningslinjer») for hver av utdanningene. Rammeplanstyringen av helse- og sosialfagutdanningene skjer gjennom styringssystemet RETHOS. RETHOS har en styringsgruppe satt sammen av representanter for ansvarlige departementer, et sekretariat i HK-dir og programgrupper for hver av utdanningene, med representasjon fra fagmiljøer og arbeidsliv.
Følgende læringsutbytte er fastsatt i felles rammeplan for helse- og sosialfagutdanningene: «Kandidaten […] har digital kompetanse og kan bistå i utviklingen av og bruke egnet teknologi både på individ- og systemnivå.» (forskrift om felles rammeplan for helse- og sosialfagutdanninger § 2). I retningslinjene for de enkelte utdanningene er læringsutbytter knyttet til teknologi og digital kompetanse utbrodert i varierende grad. For eksempel er dette kompetanseområdet særlig godt utbrodert i retningslinjen for sykepleierutdanning (forskrift om nasjonal retningslinje for sykepleierutdanning §§ 17–19).
5.7.3 Utvalgets vurdering
Et viktig, overordnet spørsmål er hvorvidt KI gjør krav på sterkere eller svakere nasjonal regulering av læringsinnholdet i høyere utdanning.
Det er ingen tvil om at KI påvirker hva som er formålstjenlig å lære, og at alle fagområder er berørt av utviklingen, skjønt i varierende utstrekning. Samtidig er det problematisk å bruke et statisk virkemiddel som nasjonal regulering for å ramme inn hva studentene trenger å lære om – eller som følge av – en teknologi i rask utvikling. En eventuell føring kan gjøres helt overordnet for å unngå å holde studietilbudene fast i en teknologisk virkelighet som ikke lenger finnes. På den andre siden vil et slikt grep gi mindre retning til arbeidet med å utvikle studietilbudenes læringsinnhold. Man kan da stille spørsmål om hvilken funksjon en helt overordnet føring fyller.
For NKRs del er det i tillegg et behov for at nivåbeskrivelsene fungerer godt for hele bredden av studietilbud, med profesjonsutdanninger, disiplinfagsutdanninger og tverrfaglige utdanninger av ulike slag. Tilsvarende gjelder ikke for de nasjonale rammeplanene, som allerede er avgrenset til bestemte fag og fagområder.
Av grunnene gitt ovenfor, vurderer utvalget at hovedvekten av arbeidet med å utvikle studietilbudenes læringsinnhold bør skje lokalt, på den enkelte institusjon og for det enkelte studietilbud. Det pågående arbeidet med å lage nye nivåbeskrivelser i NKR bør derfor ikke gå for langt i å detaljere hva slags digital kompetanse, herunder om og med KI, som skal gjelde for alle høyere utdanningstilbud. Samtidig mener utvalget at det er et klart behov for å utvikle mer generell og fagspesifikk KI-kompetanse. Der hvor det vil variere mellom fag hvilken konkret nytte KI-systemer og maskinlæringsteknikker har, vil alle studenter utdannes i og til et samfunn og arbeidsliv mer preget av KI. Generell KI-kompetanse, slik utvalget har beskrevet det, omfatter læringsutbytter som har verdi for alle studenter. Utvalget anbefaler derfor at de nye nivåbeskrivelsene for høyere utdanning, nivå 6–8, er kompatible med og informert av behovene for generell KI-kompetanse, slik utvalget har beskrevet dem.
Utvalget har gitt innspill til Kunnskapsdepartementet om utviklingen av nye rammeplaner for lærerutdanninger. Se vedlegg 1.
Flere kunnskapskilder viser at helse- og omsorgstjenesten vil være tjent med sterkere KI-kompetanse, samtidig som slik kompetanse i liten grad er utbrodert i gjeldende rammeplan og retningslinjer for helse- og sosialfagutdanninger. Som beskrevet gjennom kapittelet er KI-kompetanse, både den generelle og den fagspesifikke, en forutsetning for å identifisere og dra nytte av mulighetene KI gir på en ansvarlig måte. For en sektor hvor tjenestebehovene vokser, parallelt med at tilgangen på kvalifisert arbeidskraft blir mindre, blir det særlig viktig å dra nytte av mulighetene KI gir for å utvikle personelleffektive tjenester (NOU 2023: 4, kap. 12). I sitt innspill til utvalget oppfordrer Helsedirektoratet sterkt til at alle retningslinjene for helse- og sosialfaglige utdanninger blir oppdatert med nye læringsutbyttebeskrivelser knyttet til KI og digitale teknologier. Helsedirektoratet har også flere initiativer for å identifisere bruksområder for KI i helse- og omsorgstjenestene, samt vilkår for trygg innføring (Helsedirektoratet, 2024, u.å.).
Utvalget har ikke helse- og sosialfaglig ekspertise og vil være forsiktig med å fremme egne vurderinger av behovet for forskriftsfesting av ulike former for KI-kompetanse for helse- og sosialfagutdanningene. Med utgangspunkt i innspillene utvalget har mottatt, den raske teknologiutviklingen, det vi vet om KIs generelle påvirkning på høyere utdanning, samfunnet og arbeidslivet, og det sektorspesifikke kunnskapsgrunnlaget som utvalget har orientert seg om, fremstår det klokt å gjøre nye vurderinger av forskriftene på dette området. Utvalget anbefaler derfor at det blir gjort nye vurderinger av hvilket KI-relatert læringsutbytte som bør fastsettes for helse- og sosialfagutdanningene gjennom RETHOS.
5.8 Et mer avansert læringsutbytte
Flere av observasjonene og vurderingene som er gjort gjennom dette kapittelet, peker mot at fremtidens studenter vil ha behov for å utvikle et mer avansert læringsutbytte. Dette kan sees gjennom tre utviklingstrekk.
For det første gir KI-utviklingen behov for kunnskap om og ferdigheter med teknologien, og et større behov for enkelte andre former for læringsutbytte. Samtidig ser ikke utvalget store læringsutbyttekategorier som KI-utviklingen gir oss gode grunner til å nedprioritere. Mange typer læringsutbytte har sin plass i utdanningene, ikke fordi de er spesielt verdifulle kun i seg selv, men fordi de spiller en viktig rolle i en større læringsprosess, hvor endemålet er å lære seg å tenke og handle som en utøver av faget man studerer.
For det andre ser utvalget tendenser til en verdidreining fra produksjonsferdigheter til vurderingsferdigheter (Lee et al., 2025; Tankelevitch et al., 2024). Dette gjelder spesifikt de områdene hvor KI-systemene er mest kapable, som programmering og matematisk problemløsning, hvor KI-systemer kan stå for mer av produksjonen. Å kunne gjøre kritiske vurderinger av faglige produkter er imidlertid og generelt sett en mer avansert kompetanse enn å produsere dem.
For det tredje finnes det indikasjoner på det vi kan kalle et juniorproblem, hvor de med lite eller ingen arbeidserfaring får større vanskeligheter med å skaffe seg relevant arbeid, og dermed også svekkede muligheter til å utvikle seniorkompetanse. Ikke all evidensen peker i denne retningen, men enkelte av funnene i kapittel 5.5 gir slike indikasjoner, herunder den økende arbeidsledigheten blant nyutdannede. Dette må sees i sammenheng med det forrige utviklingstrekket: En erfaren fagutøver med god evne til å vurdere faglige produkter kan utrette svært mye med KI-systemer som produksjonsassistenter. Slik kan KI-systemer fortrenge ferske fagutøvere som ellers kunne ha stått for produksjonen. Juniorproblemet, hvis det er reelt, er i utgangspunktet et arbeidspolitisk problem. Samtidig kan det være nyttig å utforske nye samarbeidsflater og ansvarsfordeling mellom høyere utdanningsinstitusjoner og arbeidsliv for å sikre at kandidatene blir tilstrekkelig kvalifisert for yrkesdeltakelse.
Disse utviklingstrekkene utfordrer høyere utdanningsinstitusjoner til å gi studentene et mer avansert læringsutbytte. Samtidig er ikke utviklingstrekkene fullt ut bekreftet eller målt, og utvalget har ikke kommet til bunns i å utrede problemstillingen. Utvalget ser dette som et viktig tema for videre politikkutvikling på området.
5.9 Anbefalinger
At underviserne i høyere utdanning har riktig kompetanse, er en viktig forutsetning for hva studentene kan lære. Se kapittel 10 for vurderinger av og anbefalinger om universitets- og høyskoleansattes kompetanse.
Utvalget anbefaler universiteter og høyskoler å
-
sørge for at alle studenter utvikler generell KI-kompetanse
-
sørge for at alle studenter utvikler tilstrekkelig fagspesifikk KI-kompetanse
-
sørge for at fagmiljøene gjør regelmessige, KI-bevisste vurderinger av læringsinnholdet i sine studietilbud
-
legge til rette for utprøving av endringer i studietilbudenes læringsinnhold
Utvalget anbefaler sentrale myndigheter å
-
sørge for at de nye nivåbeskrivelsene knyttet til digital kompetanse i nivå 6–8 i Nasjonalt kvalifikasjonsrammeverk for livslang læring er kompatible med og informert av behovene for generell KI-kompetanse, slik utvalget har identifisert dem
-
sørge for at de nye rammeplanene for lærerutdanninger speiler læreres behov for KI-kompetanse, jf. vedlegg 1 med innspill til Kunnskapsdepartementet om nye rammeplaner
-
sørge for at det blir gjort nye vurderinger av hvilket KI-relatert læringsutbytte det er hensiktsmessig å fastsette for helse- og sosialfagutdanningene, gjennom RETHOS
6 Hvordan skal vi lære?
6.1 Innledning
Som vi har sett i kapittel 5, er kunstig intelligens (KI) i ferd med å endre på hva vi trenger å lære for å være kyndige fagutøvere. Der KI-systemene er mest kapable vil fag og oppgaver i økende grad kreve ferdigheter til å vurdere fremfor ferdigheter til å produsere – i den grad disse kan skilles fra hverandre. KIs inntog i fag, arbeidsliv og samfunn gir også et behov for mer kunnskap om og ferdigheter med KI-systemer – både generelle og fagspesifikke.
Samtidig står mange former for læringsutbytte fast som minst like viktige som før. Dette gjelder blant annet fagkunnskap og det å beherske faglige begreper, ferdigheter i lesing, skriving og kritisk tenkning. En av grunnene til at slike læringsutbytter forblir viktige, er at de spiller en rolle i en større læringsprosess. Å lære seg å tenke som en kyndig fagutøver, innebærer å lære seg både innhold og arbeidsprosesser som isolert sett kunne vært løst av KI-systemer. Læring skjer gjennom sammensatte prosesser hvor læringsutbyttet på ett stadium legger grunnlaget for videre læring.
Generativ KI endrer premissene for hvordan undervisning og læringsaktiviteter best kan planlegges, gjennomføres og tilpasses studenter i høyere utdanning. Det viktigste spørsmålet i dag er ikke om KI vil påvirke undervisning og læring, men hvordan integrasjonen av KI i læringsaktiviteter kan formes for å understøtte meningsfull læring og menneskelig handlekraft (Rattray, 2026).
Prinsippet om meningsskapende samsvar (constructive alignment) legger føringer for utforming av studietilbud.12 Ifølge dette prinsippet skal det være sammenheng mellom de tilsiktede læringsutbyttene, læringsaktivitetene som studentene engasjerer seg i og vurderingsformene som måler om læringsutbyttene er oppnådd (Biggs & Tang, 2011).
I tråd med prinsippet om meningsskapende samsvar innebærer planlegging av studieemner å identifisere ønsket læringsutbytte og å utvikle aktiviteter og oppgaver som er egnet for å gi dette læringsutbyttet. Når studentene kan få KI-systemer til å løse oppgaver for dem kan det bety at de gjennomfører en annen aktivitet enn den som var tilsiktet. Det faglige produktet kan se likt ut, men prosessen bak er fundamentalt ulik, med følger for hva slags og hvor stort læringsutbytte studenten oppnår. I dette tilfellet har KI-systemet forstyrret det meningsskapende samsvaret, ved at læringsaktiviteten ikke gjennomføres slik den var designet. Videre blir samsvaret mellom læringsaktivitetene og vurderingsformene utfordret, en problemstilling som diskuteres i kapittel 7.
I tråd med resonnementene i kapittel 5 vil akademiske kjerneferdigheter, basert på faglig forståelse og kunnskap, forbli sentrale i høyere utdanning. Kjerneferdighetene er viktige for evnen til å engasjere seg i komplekse problemer, ikke bare for problemløsning, men også for problemdefinering når kraftfulle teknologier endrer arbeids- og samfunnsliv. Hvordan KI påvirker vilkårene for å tilegne seg slik kunnskap og slike ferdigheter, er tema for dette kapittelet.
Kapittelet har følgende oppbygning: 6.2 gir en oversikt over det vi vet om studentenes bruk av generative KI-systemer. 6.3 tar for seg hvordan KI kan endre vilkårene for læring. 6.4 tar for seg KIs rolle i læringsaktiviteter som er utbredt i høyere utdanning. KIs betydning for læringsmiljø og inkludering blir vurdert i 6.5. Kapittel 6.6 gir forslag til hvilke råd institusjonene kan gi til studentene om læringsfremmende bruk av KI-systemer, og 6.7 gir videre anbefalinger på grunnlag av vurderingene som er gjort.
6.2 Studentenes bruk av KI
Studentenes bruk av generativ KI er etter hvert godt dokumentert i Norge. Studiebarometeret har inkludert spørsmål om KI-bruk siden 2023 (HK-dir, 2026b; NOKUT, 2025). Den systematiske kartleggingen gir et godt utgangspunkt for å følge utviklingen over tid. Tre mønstre trer frem: Studentene rapporterer økt bruk, en dreining fra ren tekstproduksjon over mot støttefunksjoner, og studentene opplever i liten grad å få veiledning i hva som er god faglig bruk.
6.2.1 Utbredelse
Nasjonalt har studentenes bruk av KI-systemer økt i perioden 2023–2025. I 2023 oppga 39 prosent av studentene at de ikke brukte KI i studiearbeidet, mens dette kun gjaldt ni prosent i 2025 (HK-dir, 2026b).
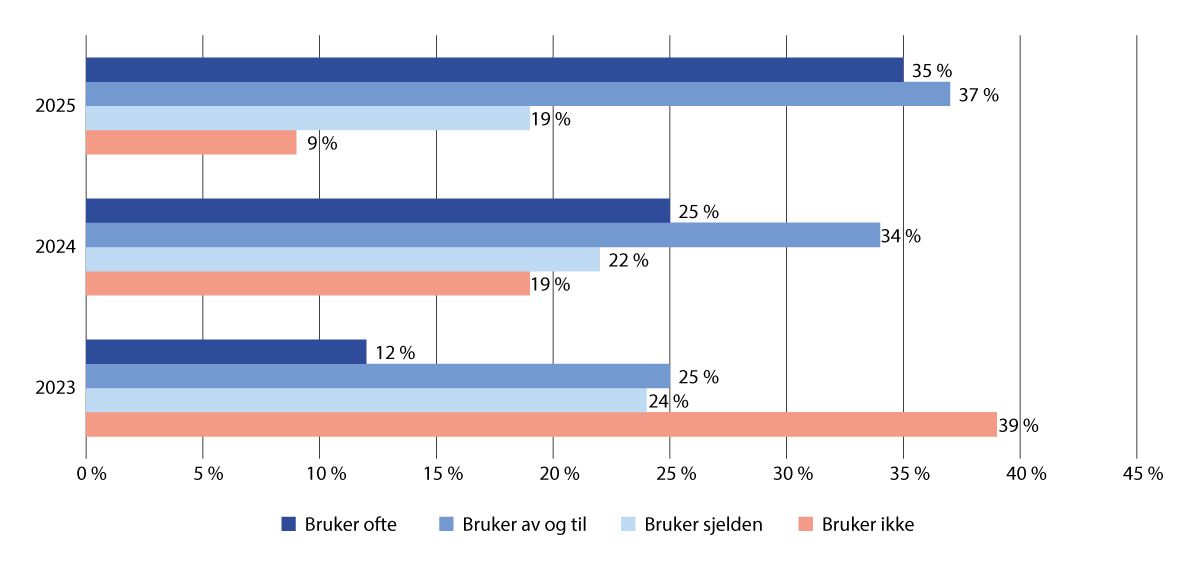
Figur 6.1 Studentenes bruk av kunstig intelligens i studiearbeid. 2023–2025. Prosent
Kilde: HK-dir (2026b, s. 57)
Hyppig bruk av KI har også økt markant. Nasjonalt brukte 12 prosent av studentene KI-systemer ofte i 2023, og i 2025 hadde denne andelen steget til 35 prosent. Ytterligere 37 prosent brukte det av og til, slik at 72 prosent av studentene i 2025 brukte KI-systemer enten ofte eller av og til (HK-dir, 2026b). Andelen som brukte KI-systemer sjeldent falt fra 24 til 19 prosent i perioden.
Parallelt med økt bruk av KI viser Studiebarometeret at studentenes selvrapporterte tidsbruk på faglige aktiviteter har gått noe ned de siste årene, fra 35,5 timer per uke i 2016 til 32,5 timer i 2024 (NOKUT, 2025). Studenter som oppgir at de aldri bruker KI, rapporterer mer tid brukt på studier enn studenter som bruker KI ofte, uten at det er avgjort hva som forklarer denne sammenhengen.
6.2.2 Bruksområder
Studentene bruker KI-systemer til en rekke formål, og nesten alle bruksområder har vist vekst gjennom perioden. Forklaring og forståelsesstøtte er det dominerende bruksområdet. Nasjonalt økte bruken av KI til å forklare tema, pensum, konsepter og terminologi fra 67 prosent i 2023 til 73 prosent i 2025. Tekstbehandling har hatt den sterkeste veksten. Nasjonalt benyttet 41 prosent av studentene KI-systemer til kvalitetssikring og redigering av tekst i 2023, mot 61 prosent i 2025 (HK-dir, 2026b).
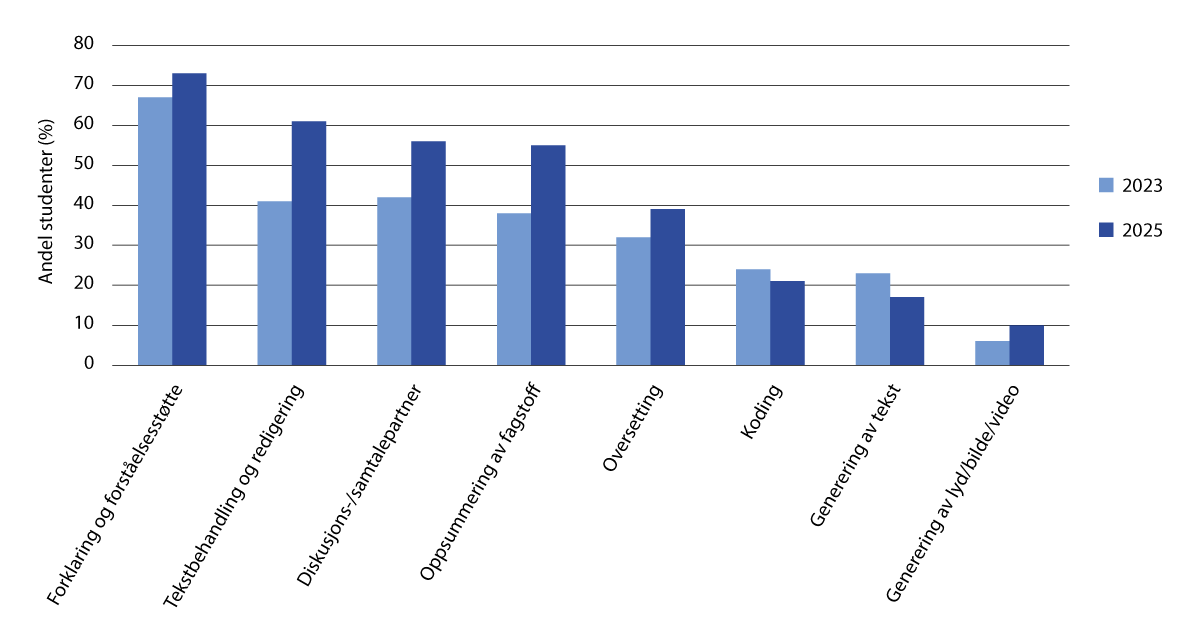
Figur 6.2 Studenters bruk av KI etter formål. 2023–2025. Prosent
Kilde: HK-dir (2026b)
Bruk av KI-systemer som diskusjonspartner eller samtalepartner har også økt mye. Nasjonalt rapporterte 42 prosent slik bruk i 2023 og 56 prosent i 2025 (HK-dir, 2026b). I en studie fra Høgskulen på Vestlandet (Ludvigsen et al., under utgivelse) beskriver studentene hvordan de bruker KI-systemer til å utarbeide ideer, jobbe med problemstillinger, stimulere til diskusjon og fordele oppgaver i grupper. De forteller at samtaleroboten kan fungere som et ekstra gruppemedlem med et alternativt blikk, men også at den kan få rollen som «dommer» og gjøre jobben med å sy sammen et felles produkt av bidrag fra gruppemedlemmene. KI inngår altså i økende grad som en del i studentenes faglige samarbeid.
Ren generering av tekst viser en nedadgående tendens i studentenes rapportering, fra noe 23 prosent gjorde i 2023 til 17 prosent i 2025. Generering av lyd, bilde eller video økte moderat, fra 6 til 10 prosent nasjonalt (HK-dir, 2026b).
Det samlede bruksmønsteret har altså, ifølge studentene selv, dreid bort fra ren tekstgenerering og mot kvalitetssikring, støtte for forståelse av fagstoff og dialogbasert bruk. Studenter som bruker KI-systemer ofte, bruker dem dessuten på flere ulike måter, mens de som bruker KI-systemer sjeldent, typisk bruker dem på ett til tre områder. Bruken har med andre ord blitt mer differensiert og variert over tid (HK-dir, 2026b; NOKUT, 2025).
6.2.3 Fagforskjeller i KI-bruk
Det er betydelig variasjon mellom fagområder. Andelen studenter som bruker KI-systemer ofte eller av og til, er høyest i økonomiske og administrative fag med 88 prosent, etterfulgt av naturvitenskapelige fag, håndverksfag og tekniske fag med 85 prosent og primærnæringsfag med 82 prosent. Over 80 prosent av studentene i disse fagområdene bruker altså KI-systemer regelmessig. Humanistiske og estetiske fag skiller seg ut som det fagområdet med minst bruk, der 38 prosent av studentene bruker KI-systemer ofte eller av og til (HK-dir, 2026b).
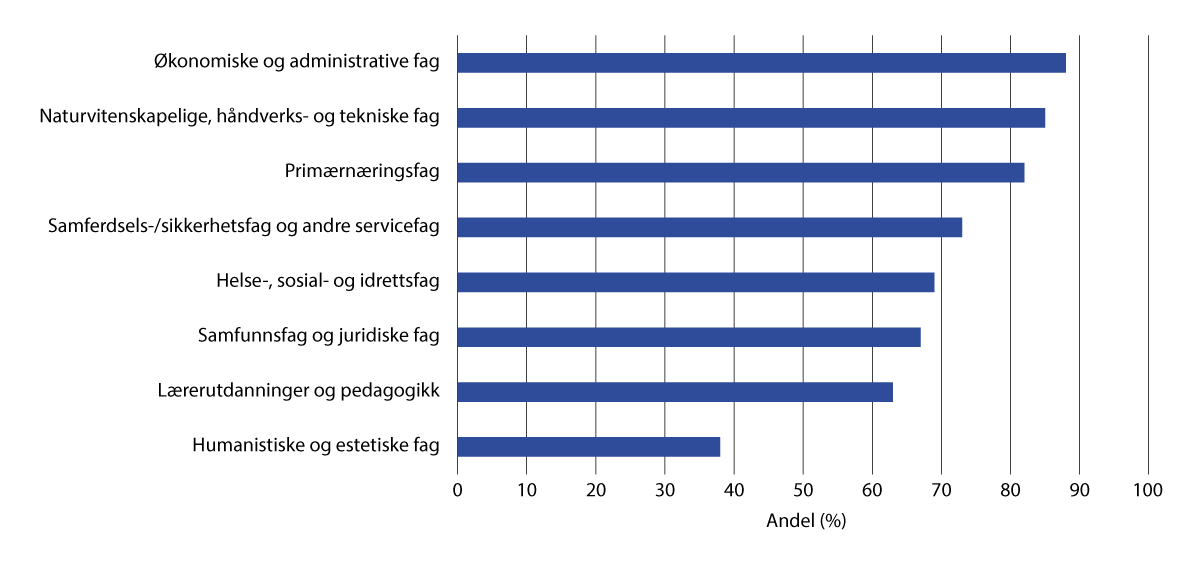
Figur 6.3 Andel studenter som bruker KI ofte eller av og til, etter fagområde. 2025. Prosent
Kilde: HK-dir (2026b)
Brutt ned på enkeltstudier var samfunnsøkonomi og sivilingeniørutdanning de utdanningene hvor studentene gjorde mest bruk av KI-systemer i 2024, med 87 prosent av studentene som brukte generativ KI ofte eller av og til. På den andre siden av spekteret finner vi arkeologi med kun 17 prosent, og musikk, dans og drama med 20 prosent regelmessige brukere (NOKUT, 2025, s. 44).
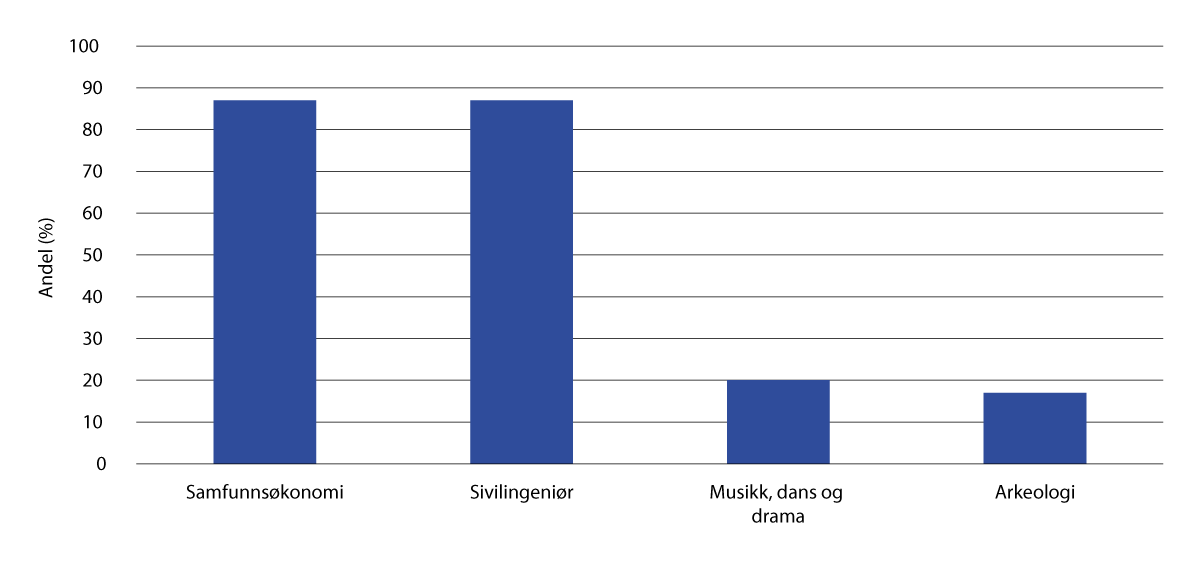
Figur 6.4 Enkeltstudier med høyest og lavest KI-bruk, 2024. Prosent
Kilde: NOKUT (2025, s. 45)
Forskjellene kan ha sammenheng med ulike fagtradisjoner i bruk av teknologi til undervisning og læring. Allerede etablert digital praksis er forskjellig mellom ulike disipliner og fag, og særtrekk ved fagene vil dermed kunne påvirke hvordan studentene tar KI-systemer i bruk (Korseberg et al., 2024). I de matematisk-naturvitenskapelige fagene har mange erfaring med avansert digital teknologi, noe som kan gjøre overgangen til KI-systemer mindre dramatisk enn for andre fagområder. Fagenes ulike læringsformer, vurderingstradisjoner og læringsmål tilsier at pedagogisk integrasjon må skje fagspesifikt.
6.2.4 Opplæring i bruk av KI
Et flertall av studentene opplever utilstrekkelig opplæring i bruk av KI-systemer. Nasjonalt oppga 55 prosent i 2025 at de i liten eller mindre grad fikk tilstrekkelig opplæring (skår 1 eller 2 på en skala fra 1 til 5), mens 21 prosent mente de hadde fått tilstrekkelig opplæring (skår 4 eller 5). De resterende 24 prosent plasserte seg på midten (HK-dir, 2026b).
Det er likevel en positiv utvikling. I Studiebarometerets 2024-måling svarte 67 prosent at opplæringen var utilstrekkelig (skår 1 eller 2) og bare 17 prosent at den var tilstrekkelig (skår 4 eller 5) (NOKUT, 2025). Fra 2024 til 2025 har altså andelen som opplever utilstrekkelig opplæring falt med 12 prosentpoeng nasjonalt, og andelen som opplever tilstrekkelig opplæring har økt med 4 prosentpoeng.
Studenter som oppgir å ha fått tilstrekkelig opplæring, bruker KI i større grad på bruksområdene som er kartlagt i Studiebarometeret. Sammenhengen er sterkest for tekstbehandling, koding, generering av lyd/bilde/video, bruk som samtalepartner og generering av tekst. For oversettelse er sammenhengen noe svakere, mens den ikke er statistisk signifikant for oppsummering og forklaring.
Aktivitetene oppsummering og forklaring synes å være mer selvdrevne og uavhengige av formell opplæring. Når studenter bruker KI-systemer til de andre formålene, kan det virke som om dette øker behovet for veiledning fra undervisere (HK-dir, 2026b). Alternativt er det opplæringen som utløser slik bruk. At studentene bruker KI-systemer til oppsummering og forklaring uavhengig av opplæring, kan tilsi at disse bruksområdene er intuitive. Et lignende funn er gjort internasjonalt, der lavere selverklært KI-kompetanse blant studentene henger sammen med lavere interesse for å få opplæring i KI-bruk (Digital Education Council, 2026b).
6.2.5 Utvalgets vurdering
Studentenes økende bruk av KI-systemer henger sammen med fagenes egenart, studentenes opplevde KI-kompetanse og institusjonelle vilkår knyttet til opplæringstilbud og retningslinjer for bruk i vurdering og eksamen.
Rapportert bruk av KI gjelder i stor grad bruk av generelle verktøy i studiearbeidet. Vi vet mindre om bruk av fagspesifikke KI-systemer og aktiviteter der KI-systemer inngår i oppgaver og fastsatt læringsutbytte. Det er ønskelig å få mer kunnskap om den fagspesifikke bruken og hvor mye av bruken som skjer som en integrert del av studietilbudet, til forskjell fra hva studentene gjør på eget initiativ.
Institusjonene har et selvstendig ansvar for å legge til rette for best mulig faglig bruk av KI-systemer, der også progresjon i KI-kompetanse er sett i sammenheng med faglig utvikling og egenart. Dette medfører et behov for å revurdere læringsaktiviteter i tråd med fagenes utvikling når det gjelder metoder og verktøybruk, og for å støtte pedagogisk progresjon i det som blir viktig menneskelig kompetanse i utøvelsen av faget.
Videre er tydelige og klare rammer for bruk av KI-systemer avgjørende for at studentene kan gjøre faglig god og forsvarlig bruk av dem.
6.3 Vilkår for læring i lys av generativ KI
Læring er en kompleks prosess der man utvikler kunnskap og ferdigheter, påvirket av kulturelle, sosiale, kognitive og biologiske forhold (National Academies of Sciences, Engineering, and Medicine, 2018). Studentenes egen regulering av læringsprosessen har betydning for læringen. Et gjennomgående premiss i det meste av forskning på læring, er at læring krever aktiv kognitiv innsats fra studentens side. Læring er ikke en passiv mottakelse av informasjon, men en aktiv konstruksjon av forståelse gjennom utforsking, bearbeiding, refleksjon og bruk. Motivasjonen vår for å lære noe nytt påvirkes også av målene vi setter, av erfaringene vi har med oss fra før og av den sosiokulturelle konteksten vi befinner oss i. Motivasjonen for læring styrkes når vi opplever tilhørighet, handlekraft og mening i et trygt læringsmiljø. Læringsaktiviteter som støtter studentenes behov for autonomi, kompetanse og tilhørighet, vil lettere fremme indre motivasjon (Ryan & Deci, 2000, 2020).
Dersom KI-systemer erstatter den kognitive innsatsen læring krever, undergraves læringsprosessen og muligens motivasjonen for læring, uansett hvor sofistikerte verktøyene er. Dersom KI-systemer derimot retter den kognitive innsatsen mot mer produktive ledd i studiearbeidet, kan de styrke læring og øke motivasjonen for videre arbeid. Det samme kan sies om ferdigheter og forståelse i kunstfaglige og estetiske fagområder. Dersom KI-systemer overtar mye av den skapende og uttrykksformende prosessen, vil det kunne hindre den nødvendige utforskingen som er viktig for læringen.
Læring er også en sosial prosess, der kunnskap og faglig forståelse utvikles gjennom samhandling, kommunikasjon og deltakelse i et felleskap. Studenter lærer fag ved å delta i felles aktiviteter i fagfeltet og dets studiemiljø, der normer, metoder og problemløsning prøves ut i fellesskap. KI-systemer brukes i økende grad inn i slike prosesser, for eksempel i gruppearbeid. Se kapittel 6.4.5 for nærmere omtale.
6.3.1 Hva er det overordnete budskapet fra forskningen om generativ KI og læring?
Forskningsfeltet om generativ KI i utdanning og læring har økt kraftig i volum siden ChatGPT ble allment tilgjengelig høsten 2022. Men kvaliteten på både enkeltstudier og metastudier varierer betydelig. Det er også få studier som skiller systematisk mellom læring målt som resultatet på en oppgave der KI-systemer har vært eller kan ha vært brukt, og det reelle læringsutbyttet (jf. kap. 7 om utfordringen med å vurdere oppnådd læringsutbytte). Flere av metastudiene som har vært publisert på feltet har vært kraftig kritisert, blant annet med utgangspunkt i at de fleste enkeltstudiene som finnes i den eksisterende litteraturen, blander pedagogisk metode sammen med teknologisk redskap, slik at man ikke kan vite om observerte effekter skyldes teknologien eller pedagogikken (Weidlich et al., 2025). I all hovedsak er forskningen det vises til, forskning om bruk av generelle generative KI-systemer.
De overordnede signalene fra forskningen så langt er at både forkunnskaper i faget og gode metakognitive ferdigheter er nødvendige for å kunne nyttiggjøre seg generativ KI i læringen (Fesler et al., 2026). Funn fra den siste PISA-undersøkelsen viser at sammenhengen mellom KI-bruk for læring og læringsutbytte er tvetydig, men overveiende problematisk (OECD, 2026c). På tvers av landene i studien er sammenhengen mellom bruk av KI til ulike læringsformål og prestasjon på PISA-prøven i naturfag, moderat negativ.
På tvers av de nyeste metastudiene fremstår den samlede effekten av KI-støttet læring i utdanning som positiv, men beskjeden (Chen & Cheung, 2025; Han et al., 2025). Et gjennomgående problem med metastudiene, er at læringsutbyttet ofte ikke blir godt målt i enkeltstudiene de bygger på. Når læringsutbyttet måles gjennom karakterresultater og studentene har hatt tilgang på generativ KI under gjennomføring av vurderingsaktiviteten, så gir det svak dokumentasjon på læringsutbytte som sådan (Chen & Cheung, 2025, s. 14; Han et al., 2025, s. 12).
Blant de metodologisk sterkeste enkeltstudiene som er gjennomført om generativ KI og læring er Bastani et al. (2025) og Strömberg et al. (2026), som tar for seg elever fra henholdsvis trinn 9–11 og trinn 7–12. Begge studiene viser at det å introdusere generative KI-systemer for elever, uten videre tilpasning, har negative konsekvenser for læringsresultatene.
Bastani et al. (2025) delte nesten 1000 tyrkiske matematikkelever inn i tre grupper: En gruppe som fikk tilgang på en vanlig samtalerobot drevet på GPT-4; en gruppe som fikk et KI-system, også basert på GPT-4, spesielt instruert til å fungere som læringsassistent; og en kontrollgruppe uten tilgang på generativ KI. Mens den første gruppen presterte 127 prosent bedre enn kontrollgruppen på øvelsesoppgaver, presterte den 17 prosent dårligere på eksamen uten hjelpemidler. Gruppen med læringsassistent presterte 48 prosent bedre enn kontrollgruppen på øvelsesoppgaver, og jevngodt med kontrollgruppen på eksamen uten hjelpemidler.
Studien til Strömberg et al. (2026) baserer seg på mer enn 25 000 kinesiske elever, fulgt over 30 måneder i ni forskjellige fag. Det ble registrert hvilket tidspunkt den enkelte elev, på eget initiativ, begynte å ta i bruk KI-systemer. Det ble ikke gjort noen systematiske intervensjoner i hvilke verktøy elevene tok i bruk eller hvordan de brukte dem. Innen seks måneder etter at de hadde tatt i bruk KI-systemer, viste elevene seg å prestere 18 prosent bedre på hjemmelekser – samtidig som de brukte 30 prosent mindre tid på dem – men 20 prosent dårligere på månedlige eksamener uten hjelpemidler. Læringstapet ble også større over tid, frem til to års bruk. Det er ellers verdt å merke at de elevene som brukte KI-systemer uten å bruke mindre tid på hjemmelekser, hadde et vesentlig mindre læringstap enn dem som fulgte det generelle mønsteret.
Disse studiene gir et sterkt signal om at det rammer læringen negativt dersom generative KI-systemer blir gjort tilgjengelig uten at systemene, eller bruken av dem, tilpasses målet om læring i ulike former. Samtidig er det viktig å påpeke at studiene er gjennomført på lavere utdanningstrinn, med større grad av lærerorganiserte aktiviteter.
Utvalget er også blitt presentert foreløpige resultater fra et pågående forskningsprosjekt ved NTNU, HELAI, hvor de undersøker sammenhengen mellom studentenes bruksvaner med KI-assistenter og deres eksamensprestasjoner. Studien omfatter ca. 1200 studenter på et utvalg programmeringsemner vår og høst 2026, fra ulike studieprogrammer. Undersøkelsen besto av en spørreundersøkelse for å kartlegge studentenes bruksvaner, fulgt opp av gruppeintervjuer. Gjennom syv utsagn i spørreundersøkelsen ble studentene gruppert etter om de viser tegn på «autoavhengig» KI-bruk, det vil si at de raskt søker hjelp fra KI-systemer og opplever seg avhengig av dem for å løse oppgaver.
Justert for bakgrunnsvariabler som karakterer fra videregående skole og egenrapporterte programmeringsferdigheter, presterte studentene med høy grad av autoavhengighet 1,4 karakterpoeng lavere enn studentene som ikke brukte KI-systemer. Studentene med en viss (lav) grad av autoavhengighet lå 0,7 karakterpoeng under sistnevnte. Uten å justere for bakgrunnsvariabler var forskjellene større. Studien finner også tegn til at studenter som synes emnene er vanskeligere, utvikler mer autoavhengighet, og at flere av studentene har blindsoner for hva som skal til for at de oppnår læringsutbyttet.
6.3.2 Hukommelse, kognitive prosesser og kognitiv belastning
God læring krever at studentene koordinerer flere kognitive prosesser, og fremmes av at de klarer å overvåke og regulere læringen. Studentene bruker kognitive funksjoner som oppmerksomhet, arbeidsminne og langtidsminne for å bearbeide, lagre og gjenfinne informasjon. Omgivelsene påvirker også hva og hvor mye informasjon studentene klarer å ta til seg og utvikle som kunnskap (National Academies of Sciences & Medicine, 2018).
Teorien om kognitiv belastning kan brukes til å forstå hvordan undervisningsdesign kan tilpasses studentenes kapasitet for bearbeiding av informasjon (Sweller, 1988). Teorien skiller mellom tre former for kognitiv belastning: indre belastning, som er knyttet til kompleksiteten i selve lærestoffet; ytre belastning, som handler om måten stoffet presenteres på; og relevant belastning, som er den kognitive innsatsen som går med til å lage varige kunnskapsstrukturer i langtidsminnet (Sweller et al., 2019). Ideen bak denne inndelingen er at man lærer mer effektivt når den ytre belastningen minimeres og den relevante belastningen maksimeres: Det vil si at studentene bruker sine kognitive ressurser på å bearbeide innholdet fremfor på unødvendig kompleksitet. Når læringsinnholdet er godt organisert og tilpasset studentenes nivå av forkunnskap, vil de ha mer ledig arbeidsminne til den dypere bearbeidingen som er nødvendig for varig læring (Sweller, 2024). Forskning på det som er kalt ønskelige vanskeligheter i læringen viser at en viss grad av kognitiv anstrengelse er nødvendig for at kunnskap fester seg i langtidsminnet (Bjork & Bjork, 2011).
Motsatt beskriver begrepet om kognitiv avlastning (cognitive offloading) det å overlate tankeoppgaver til eksterne verktøy (Risko & Gilbert, 2016). Kognitiv avlastning er i seg selv ikke problematisk. Det avgjørende er hvilke kognitive prosesser som avlastes når noe skal læres. Dersom KI-systemer avlaster uvesentlige, rutinemessige oppgaver slik at man får mer tid til å bryne seg på oppgaver som krever at man tenker kritisk eller kreativt, kan avlastningen være læringsfremmende. Medfører kognitiv avlastning derimot at oppgaver som er nødvendige for videre læring og forståelse blir hoppet over, er avlastningen læringshemmende.
Studien til Corbett og Tangen (2026) tar for seg psykologutdanning, der det er viktig å kunne identifisere, forstå og reflektere over egne fordommer og faglige misforståelser. Et KI-system som var laget slik at det oppdaget fordommene og misforståelsene og forklarte dem til studentene, gjorde at studentene fikk bedre testresultater sammenliknet med studenter som bare leste generelle tekster om fenomenet, og sammenlignet med studenter som brukte en generisk samtalerobot til å diskutere fagstoffet. Men effekten av KI-systemet forsvant noen måneder etter intervensjonen, så den varige læringseffekten var lav. Det er viktig å være oppmerksom på effekten av kognitiv avlastning, fordi varig forståelse utvikles gjennom å møte kompleksitet og streve med fagstoffet (Kapur, 2016).
Begrepene kognitiv belastning og avlastning gir dermed et nyttig utgangspunkt for å kunne vurdere virkningen av KI-systemer på læring. Begrepene kan brukes til å forklare behovet for å opprettholde et produktivt arbeid med fagstoffet. Hva som er riktig nivå av belastning, avhenger av studentenes forkunnskaper. Dette betyr at lærings- og undervisningsmetoder og -verktøy som effektivt støtter læringsprosessen for ferske studenter med få forkunnskaper, kan være ineffektive eller direkte hemmende for læringen for mer viderekomne studenter, og vice versa (Kalyuga & Sweller, 2014).
Sett fra perspektivet til undervisere betyr dette at man må tenke gjennom hvilken rolle KI-systemer skal spille i læringsaktivitetene, både når overordnet studieforløp beskrives, når konkrete læringsaktiviteter planlegges og når valg av KI-systemer foretas.
6.3.3 Metakognisjon, selvregulert læring og læringsstrategier
«Selvregulert læring» viser til studentenes evne til å sette mål for sin egen læring, velge hensiktsmessige strategier, overvåke sin egen fremgang og justere innsatsen basert på tilbakemeldinger (Zimmerman, 2002). Selvregulert læring er særlig viktig i høyere utdanning fordi studenter i stor grad arbeider selvstendig og har ansvar for egen læring (Panadero, 2017).
Selvregulert læring krever at studentene aktivt konstruerer forståelse gjennom prøving og feiling, kildevurdering og gjennom å bygge opp mentale modeller gradvis. Kunnskapen studentene har fra før, kan lette ny læring, men kan også skape hindringer når de støtter seg på eksisterende mentale modeller som hindrer dem i å ta inn ny informasjon.
Metakognisjon, evnen til å tenke om egen tenkning, er en komponent i selvregulert læring. Studenter som har velutviklede metakognitive ferdigheter, er bedre i stand til å identifisere hva de forstår og ikke forstår, og til å velge effektive læringsstrategier deretter.
KI-systemer har potensial til å støtte de ulike fasene i selvregulert læring. I planleggingsfasen kan KI-systemer hjelpe studenter med å søke relevant informasjon og strukturere sine læringsmål. I gjennomføringsfasen kan KI fungere som et verktøy for støtte til problemløsning, og i en refleksjonsfase kan KI gi tilbakemeldinger som støtter egenvurdering.
I modellen for selvregulert læring er planleggingsfasen avgjørende for kvaliteten på den videre læringsprosessen. Dersom en student begynner en oppgave med å henvende seg til et KI-system for å få et utkast fremfor å selv planlegge, forbigår studenten en kognitiv prosess som er sentral for utviklingen av selvregulering. Over tid kan dette føre til at studenten ikke utvikler de metakognitive evnene som er nødvendig for å planlegge og styre læringsoppgaver.
Dette er en mulig, uheldig spiral: Studenter som allerede har god evne til selvregulering, får mest utbytte av KI, mens studentene som trenger mest støtte, risikerer å bruke KI-systemer på måter som ytterligere svekker deres selvreguleringsevne. Enkel tilgang til raske KI-løsninger kan redusere viljen og evnen til langvarig og krevende selvregulert læring (Aru & Rozgonjuk, 2022). Slik bruk av KI-systemer fører da til at vesentlige trinn i utvikling av faktakunnskap og begrepsforståelse blir utelatt. Studentene kan dermed gjennomføre oppgaver og levere arbeider uten å ha gått gjennom de dypere læringsprosessene som gir dem genuin forståelse av stoffet.
Mye tyder derfor på at KI-systemer støtter studentenes selvregulerte læring mest effektivt når de tas i bruk innenfor klare pedagogiske rammer. Lämsä og Järvelä (2026) viser at spesiallagde KI-systemer kan støtte selvregulert læring, gjennom å gi tilbakemeldinger som forsiktig dytter de lærende videre dersom de opplever et kognitivt, emosjonelt eller motivasjonsmessig hinder.13 Uten slike rammer er det en risiko for at studenter utvikler overavhengighet av KI (Lan & Zhou, 2025). Med utgangspunkt i at studievaner bygges over tid, betyr dette at de første semestrene som student er særlig viktige for å lære seg å lære med KI.
Effektive læringsstrategier hjelper studentene til å hente frem relevant informasjon og til å oppsummere og forklare lærestoff. Hvor effektive strategiene er, påvirkes av forkunnskapene til studentene, hva slags stoff de skal lære, og målene for læringen (National Academies of Sciences & Medicine, 2018). God bruk av KI-systemer kan synliggjøre og forenkle formulering av læringsmål og fremlegge fagstoff på måter som støtter forståelse, men antakeligvis ikke uten at studenten selv har et aktivt og bevisst forhold til hvordan KI-systemer kan brukes godt til læring. Dette medfører at god bruk av KI-systemer og gode læringsstrategier i prinsippet kan forsterke hverandre gjensidig og bidra til at studentenes selvregulerte læring blir styrket.
Selv om generative KI-systemer har et potensial for å øke produktiviteten i arbeidslivet, krever utdanning en tilnærming som verdsetter både prosess og produkt, fremmer kognitiv utvikling fremfor umiddelbare resultater og fremmer metakognitiv utvikling gjennom refleksjon, selvregulering og bevissthet om egne læringsprosesser.
Ifølge en veletablert modell for læring blir studenter i stand til å gjøre progressivt mer avanserte kognitive oppgaver, fra å huske og forstå begreper og faglig innhold, til å kunne anvende begreper og teorier og analysere informasjon, for til slutt å være i stand til å evaluere og skape eget faglig innhold (Anderson et al., 2001; Bloom et al., 1956). Når læringsprosessen lykkes, beveger studenten seg oppover i dette hierarkiet og utvikler gradvis kritisk vurderingsevne og kreativ faglig kompetanse. Gjennom prosessen aktiveres høyere kognitive funksjoner ved at studentene søker å forstå underliggende prinsipper og sammenhenger. Fravær av slik aktivering gjør at studentene primært forsøker å memorere og reprodusere informasjon.
Studenter vurderer ofte hvilken innsats de mener er nødvendig for å nå et ønsket mål eller læringsutbytte gjennom å se ulike krav mot hverandre. Fagstoff og oppgaver må altså være krevende, men ikke uoverstigelige, innrammet med passende støtte underveis og passende for studentenes strategiske vurderinger av hvilken innsats som trengs (Chaiklin, 2003; Meyer, 2008).
6.3.4 Læring som sosial prosess og samarbeidslæring
Læring er også en sosial prosess, som kan støttes aktivt. Kjernen i prosessen ligger i spenningen mellom hva studentene allerede behersker, og hva de kan få til med støtte. God undervisning retter seg slik mot sonen mellom det studentene kan gjøre alene, og det de kan mestre gjennom veiledning eller samarbeid med andre (Vygotsky, 1978). Denne støtten kan gradvis fjernes etter hvert som ferdighetene internaliseres (Chaiklin, 2003; Wood et al., 1976).
Forståelse utvikles videre gjennom at studenter formulerer, argumenterer og forhandler om mening i faglige fellesskap (Biggs & Tang, 2011). Skriving, diskusjon og tilbakemeldinger fra medstudenter og undervisere er slik sett avgjørende læringsaktiviteter. Å lære faget innebærer å lære tenkemåter, argumentasjonsmønstre og kvalitetskriterier gjennom deltakelse (Greene et al., 2016). God design av undervisning og læring innebærer derfor å legge til rette for felles læringsarenaer og samarbeid mellom studentene.
Samarbeidslæring kan være verdifullt på flere måter. Det kan dreie seg om en umiddelbar sosial og emosjonell verdi, et forsterket læringsutbytte eller en verdi for faglig nyorientering (Reimann, 2024). Samarbeidslæring har også verdi i lys av uttrykte behov om samarbeidsevner som den mest etterspurte ferdigheten i arbeidslivet (Furholt et al., 2026), og er egnet for å få erfaring med realistiske og komplekse oppgaver som krever koordinering og integrasjon av bidrag fra flere aktører eller fagområder.
6.3.5 Utvalgets vurdering
Forskningen som er gjort om konsekvensene generativ KI har for læring, gir ikke grunnlag for å si at teknologien har en entydig negativ eller entydig positiv effekt. Siden generative KI-systemer kan brukes på et utall forskjellige måter i læringsaktiviteter, ville det også være overraskende om man kunne trekke en slik konklusjon. Det vi har tydelige signaler om – særlig med funnene til Strömberg et al. (2026), Bastani et al. (2025) og fra PISA-undersøkelsen (OECD, 2026c) – er at tilgang på generativ KI kan hemme læringen dersom det ikke tas grep om hvilke systemer som blir brukt eller hvordan de brukes. Behovet for KI-systemer som er utviklet for å støtte læring, blir tatt opp igjen i kapittel 8.
Det har mye å si hvordan generative KI-systemer tas i bruk. Det vi vet om læring – uavhengig av det spesifikke kunnskapsgrunnlaget om generativ KIs betydning for læring – kan gi oss pekepinner på hva som kan være egnede roller for KI-systemer i læringsprosesser. De mest grunnleggende poengene i denne sammenheng er behovet for aktivering av høyere kognitive funksjoner rettet mot produktive innsatsområder, og behovet for selvregulering for mer effektiv læring. Vi lærer på den annen side ikke godt hvis den kognitive anstrengelsen blir for stor; om det rett og slett blir for vanskelig. Å få ting forklart eller forenklet, kan gi fremgang i læringsprosessen. Siden bruk av KI både kan påvirke aktiveringen av høyere kognitive funksjoner og tilrettelegge for forståelse av vanskelig læringsinnhold, betyr dette at det blir enda viktigere for dagens studenter å utvikle gode studievaner tidlig, og bli bevisst de nødvendige fasene i gode læringsprosesser.
6.4 KI som støtte i læringsaktiviteter
Studentene lærer gjennom ulike typer aktiviteter. De tilegner seg fagstoff for eksempel gjennom å følge forelesninger eller ved å lese tekster. De utfordrer og utvikler sin faglige selvstendighet gjennom problemløsning, prøving og feiling, og gjennom tilbakemeldinger. Aktiviteter som diskusjon og samarbeid gjør at studentene må begrunne synspunkter i samspill med andre, mens øvelse i praksis er en vesentlig del av utdanningen for mange studietilbud. Et variert repertoar av læringsaktiviteter er med på å sikre at studentene oppnår et bredere læringsutbytte. De følgende underkapitlene (6.4.1–6.4.7) beskriver og gir en vurdering av KI-systemers betydning som støtte i lesing, oppgaveskriving, tilbakemeldinger, veiledning, samarbeidslæring og erfaringsbasert læring.
6.4.1 Lesing og KI
Lesing av fagtekster er en sentral læringsaktivitet i høyere utdanning, og det er viktig å se på detaljer i hvordan KI-systemer brukes til lesing blant studenter. I en del fag, spesielt i humaniora og samfunnsvitenskap, har tekster i stor grad vært den formen fagkunnskap utvikles, forvaltes og formidles gjennom. Men også i tekniske og naturvitenskapelige domener, og i ulike profesjonsfag, er lesing og tekstforståelse avgjørende i læringsprosessene. Samtidig er det bekymring i fagmiljøene for at studentene i dag leser mindre og mer overflatisk enn før, og at evnen til å engasjere seg dypt og lese lange tekster går ned. Dette er en lengre utvikling som blant annet knyttes til endring i befolkningens lesevaner, og som kan forsterkes ytterligere av tilgang på KI-systemer (Hakemulder & Mangen, 2024).
Forskningen om hvordan lesing henger sammen med kunnskapstilegnelse, refleksjon og vurderingsevne har tematisert hvordan teknologisk utvikling har ført til en fragmentering og økning i mangfoldet av tekster studenter navigerer i. Kritisk vurdering av kilder og integrasjon av informasjon fra ulike kilder – også når kildene motstrider hverandre – blir dermed sentrale ferdigheter (Strømsø & Kammerer, 2016). Forskningen har vist at strategisk kildevurdering er krevende kognitivt, der studentenes forkunnskaper og epistemiske antakelser (epistemic beliefs) spiller en stor rolle (Anmarkrud et al., 2022). Lesestrategier og strategisk kildevurdering henger positivt sammen med evnen til å fremstille kunnskap muntlig og til å skrive argumenterende tekster, som er avgjørende for å utvikle forståelse i fagene. Samtidig må slike metakognitive strategier læres, og dermed støttes gjennom undervisning og læringsdesign (Bråten et al., 2025).
Med tilgang på språkmodellbaserte KI-systemer blir disse utfordringene aktualisert. Strategisk bruk av høyere kognitive funksjoner i møte med ulike kunnskapskilder er fremdeles avgjørende for læring, og utvikling av menneskelig kapasitet til å undersøke og vurdere informasjon blir en enda viktigere oppgave for høyere utdanning. KI-systemer som oppsummerer faglige artikler og pensumbidrag, for eksempel NotebookLM, markedsføres offensivt og er svært populære da de kan gi raske og komprimerte versjoner av krevende stoff. Akkurat denne bruken er lite dokumentert i forskningen, men ut fra den omfattende bruken er det tenkelig at systemene både kan bidra til at studentene leser en større bredde fagstoff, men også at de engasjeres mindre i kritisk lesing, kan gå glipp av viktige nyanser og få presentert tolkninger preget av KI-bias (Corbin & Walton, 2025).14
Samtidig kan KI-systemer støtte disse læringsprosessene på personlig tilpassede og meningsfulle måter. Enkelte studier argumenterer for at verktøy som ChatGPT kan støtte studenters lesing av fagtekster på en interaktiv måte som ivaretar motivasjon og behov for autonomi (Pan et al., 2026). Andre understreker at vi foreløpig vet lite om studentenes forståelse av hvordan KI-generert tekst fremkommer, og at metakognitive ferdigheter er sentrale for å nyttiggjøre seg slike verktøy i akademisk lesing og skriving (Bråten et al., 2026; Malmström et al., 2025; Urban et al., 2025).
6.4.2 KI i oppgaveskriving
Skriving er også en sentral læringsaktivitet i høyere utdanning. Det å formulere tanker, strukturere argumenter og revidere formuleringer er viktig for å utvikle evner til kritisk og kreativ tenkning og dypere forståelse av fagets innhold. Skriving tvinger studentene til å gjøre implisitt kunnskap eksplisitt, til å organisere informasjon og til å identifisere feilslutninger og mangler i egen forståelse. Skriving har en signifikant positiv effekt på læring på tvers av fag som naturfag, samfunnsfag og matematikk (Graham et al., 2020). Gjennom å skrive innarbeider studentene fagbegreper som helt vesentlige byggeklosser i deres fagkunnskap.
Dersom KI-systemer reduserer studentenes selvstendige skriveaktivitet, kan dette ha konsekvenser som strekker seg langt utover skriveferdigheter – det påvirker studentenes samlede læringsutbytte.
Ukritisk bruk av generative KI-systemer påvirker både læringsutbyttet man får ut av skrivingen og selve resultatet av skriveprosessen. Kosmyna et al. (2025) målte hjerneaktiviteten (EEG) hos studenter i tre ulike grupper: de som skrev med hjelp fra samtaleroboter (KI-gruppen), studenter som kun fikk bruke søkemotorer, og en gruppe som skrev uten hjelpemidler. KI-gruppen viste lavest hjerneaktivitet. KI-gruppen presterte også dårligst på språklige og atferdsmessige målinger. Over tid utviklet denne gruppen mer passive arbeidsmetoder, og mange endte hovedsakelig med å lime inn tekst direkte fra samtaleroboten. Arbeidene deres, i dette tilfellet skriftlige essay, ble beskrevet som «sjelløse» av eksterne sensorer. Gruppen som skrev uten noen hjelpemidler, viste høyest hjerneaktivitet, spesielt i hjernedeler knyttet til idéutvikling, bruk av hukommelse og språklig mening. De rapporterte økt engasjement, nysgjerrighet og tilfredshet med tekstene de skrev. De husket også best innholdet i det de hadde laget. Til slutt fikk disse studentene tilgang til samtaleroboter som de brukte til å forbedre tekstene sine, men uten å vise redusert engasjement, motivasjon eller hukommelse. Gruppen som bare brukte søkemotorer, presterte også godt, viste høy hjerneaktivitet og god tilfredshet med arbeidet sitt (Kosmyna et al., 2025).
Brutt ned på skriveprosessens faser virker det som om den mest hensiktsmessige bruken av KI i skriving for læring, er der studentene bruker KI-systemet som en sparringpartner i revisjonsfasene, fremfor som en kilde til ideer, en planlegger eller en produsent av ferdige tekstsegmenter. Dette stiller krav til studentenes læringsstrategier. Det er også verdt å reflektere over hvordan KI-systemer kan påvirke studentenes utvikling av fagspesifikke skriveferdigheter. Akademisk skriving er ikke bare en generell kommunikasjonsform, men en måte å tenke på innenfor et bestemt fagfelt. Gjennom skriving lærer studenter å anvende fagets begrepsapparat, argumentasjonsformer og krav til evidens. Det er derfor viktig at KI-systemer brukes på en måte som understøtter heller enn forstyrrer denne prosessen.
6.4.3 KI-genererte tilbakemeldinger
Det å få og nyttiggjøre seg tilbakemeldinger er en viktig del av effektive læringsprosesser. De mest læringsfremmende tilbakemeldingene hjelper studentene til å forstå hvordan de kan forbedre tilnærmingen til egen læring, ikke bare til å korrigere konkrete feil. I tillegg er tilbakemelding som er spesifikk, som kommer i rett tid og er knyttet til tydelige kriterier, effektivt for læring (Hattie & Timperley, 2007). Spørsmålet er om en av de mest markedsførte funksjonene i generativ KI for utdanning, individuelle tilbakemeldinger, kan fylle denne funksjonen.15
Generative KI-systemer gjør det mulig for studenter å få individuelle tilbakemeldinger i stor skala, og tilbakemeldingene kan komme umiddelbart. Å gi individuelle tilbakemeldinger i undervisningen er noe som ellers er svært ressurskrevende (Hopfenbeck et al., 2023). Det er indikasjoner på at KI-genererte tilbakemeldinger og forklaringer kan bidra til at studentene identifiserer faglige misforståelser tidlig. KI-systemene kan potensielt også tilby støtte helt frem til studentene mestrer læringsmålene, noe som kan bidra til dypere forståelse og mer avansert kunnskap (Laak & Aru, 2024).
Videre kan kvaliteten på slik veiledning være på nivå med hva undervisere kan tilby, dersom verktøyet er designet pedagogisk (Kestin et al., 2025). En metaanalyse av Kaliisa et al. (2026) fant ingen statistisk signifikant forskjell i oppnådde læringsresultater mellom studenter som mottok KI-generert tilbakemelding og studenter som mottok tilbakemelding fra mennesker. Enkeltstudiene i metaanalysen spriker mye, og resultatene må tolkes med forsiktighet, men andre studier indikerer også at den faglige og pedagogiske kvaliteten til KI-basert veiledning i noen sammenhenger kan tilsvare kvaliteten til menneskelige veiledere (Jongkind, 2026; Sessler et al., 2025).
Forskningen på KI-tilbakemeldinger har fokusert mest på tilbakemeldinger på oppgaveløsning og prosesser. Selv om det metakognitive nivået, der studentene reflekterer over egen læring, er mindre utforsket, er det en økende trend med studier som kombinerer alle tre nivåer, noe som indikerer at KI kan ha et potensial også her (Ba et al., 2025).
Det er også indikasjoner på at menneskelige tilbakemeldinger kan oppfattes som mer motiverende og mer emosjonelt støttende av studentene (Kaliisa et al., 2026), men det motsatte kan også være tilfellet, særlig i nettbaserte studier (Yilmaz et al., 2026). Det er naturligvis mulig å kombinere menneskelige tilbakemeldinger med KI-genererte tilbakemeldinger på forskjellige måter, for eksempel kan KI gi rask tilbakemelding på oppgavenivå, mens undervisere gir tilbakemeldinger på prosessnivået og det metakognitive nivået.
I rene nettbaserte kurs kan bruk av samtaleroboter styrke studentenes engasjement og motivasjon gjennom umiddelbare tilbakemeldinger. Tilbakemeldingene kan bidra til å forbedre studentenes læringsutbytte, særlig i asynkrone læringsmiljøer hvor samhandlingen med lærere eller veiledere er begrenset. Samtaleroboter kan brukes til å veilede studenter i å sette egne mål, overvåke faglig utvikling og progresjon og støtte refleksjon over egen læring (Engeness et al., 2025).
Over tid kan tilbakemeldinger fra samtaleroboter bidra til å opprettholde studentenes motivasjon og dermed forbedre læringsresultatene. Men den kognitive belastningen ved å tolke tilbakemeldingene varierer med studentenes faglige utgangspunkt (Yin et al., 2024). Dersom samtalerobotene i tillegg forklarer tilbakemeldingene sine, kan det styrke utbyttet. Dette tyder på at utformingen av tilbakemeldingene er viktig, noe som forutsetter KI-systemer som er egnet til å kunne utforme gode tilbakemeldinger (Afzaal et al., 2024).
Boks 6.1 KI-basert matematikkveileder ved Universitetet i Stavanger
Ved Universitetet i Stavanger har de utviklet en KI-basert matematikkveileder som kan tilpasse forklaringer, hint og oppgaver til studentenes læringsnivå og tidligere arbeid. Prosjektet utvikler et rammeverk kalt Living Knowledge Atlas, som skal holde oversikt over studentenes progresjon og bruke pedagogiske regler til å styre hvordan systemet velger oppgaver, forklaringer og videre læringssteg. Målet er å gå fra enkeltstående KI-svar til mer langsiktig og pedagogisk styrt veiledning tilpasset studentens progresjon og mestring.
Arbeidet bygger på forskning og undervisning ved Universitetet i Stavanger, blant annet med KI-støttet STEM-undervisning, studentorientert læring og kobling mellom faglige verktøy og språkmodeller. Utviklingen skjer i et samspill mellom forsknings-, undervisnings- og innovasjonsmiljøer ved universitetet.
Kilder: Informasjon til utvalget fra professor Yihan Xing ved Universitetet i Stavanger og Lars Petter Eliassen i Validé.
6.4.4 KI i veiledningsprosessen
Generativ KI utfordrer forholdet mellom veileder og student. KI-systemer kan øke veileders effektivitet, men kan være problematisk med tanke på tillitsbåndet mellom veileder og student, etisk ansvarlighet og faglig troverdighet (Omodan, 2025). Som veileder er det viktig å kunne finne ut om studentene har utviklet for stor avhengighet av KI-systemer, og å kunne lese om studentene har tatt med KI-generert materiale som mangler originalitet gjennom å tolke underliggende betydning i teksten. Studenter på alle nivåer trenger ofte veiledning i grunnleggende akademiske ferdigheter, som litteratursøk og korrekt kildehenvisning, for å ivareta akademisk integritet. Det er altså betydningsfullt at veiledere får innblikk i studentenes arbeidsprosess og at studentene kan delta i evaluerende diskusjoner om hvordan de bruker KI-systemer. Veilederen bør dermed både modellere god bruk av KI-systemer og samtidig fremme selvstendig kritisk tenkning og etiske prinsipper hos studentene (Adewunmi, 2026).
Mye tyder på at vellykket bruk av generativ KI i veiledningsprosessen på bachelor- og masteroppgaver handler om at studentene mottar raske formative tilbakemeldinger som er lagt opp etter tydelige faglige kriterier. Bruk av KI-støtte mellom veiledningsmøtene kan styrke studentenes faglighet, ved å øke volumet og tilgjengeligheten på tilbakemeldinger og frigi tid for menneskelige veiledere til mer overordnet faglig veiledning (Jongkind, 2026). KI-basert veiledning kan oppleves som verdifullt av studentene, men da som et supplement og ikke en erstatning for menneskelig veiledning (Jongkind, 2026).
Ulempene med KI-basert veiledning er i mange sammenhenger de samme som for individuell læring (jf. kap. 6.3), men veiledning innebærer også tilhørighet og emosjonell støtte: slike funksjoner er problematisk å overlate til KI-systemer (Jongkind, 2026).
6.4.5 KI og samarbeidslæring
Samarbeidslæring foregår i stor grad i uformelle settinger på campus, i kollokvier og i selvorganiserte nettsamfunn. Samarbeidslæring finner også sted uformelt i formelle settinger, for eksempel når studenter spør hverandre om hjelp til å forstå noe under forelesninger. Disse sidene ved studentenes læring er viktige, også for sosialiseringen inn i en faglig og akademisk rolle.
I tillegg kan samarbeidslæring inngå i læringsdesignet, gjennom oppgaver og læringsaktiviteter. Det kan for eksempel gjøres gjennom ulike former for prosjektbasert læring og undersøkende aktiviteter etter modell av fagets forskningspraksiser. Utdanningsforskeren Peter Reimann har foreslått at samarbeidslæring ikke bør organiseres som tradisjonelle gruppeoppgaver av kort varighet, men inngå i et pedagogisk design med utforskende oppgaver som strekkes over tid, og som er orientert mot ulike typer verdiskaping for studentene i langvarige læringsfellesskap (Reimann, 2024). En av tankene bak er at dette vil gi et bedre grunnlag for å utvikle nye, fagspesifikke ferdigheter og ny kunnskap. Digitale løsninger og KI-systemer kan bidra inn i en slik modell. For det første kan KI-systemer brukes på fagspesifikke måter, for eksempel i analyse av større informasjonsmengder eller gjennom andre utforskningsmetoder. For det andre er det etter hvert et økende antall studier som ser på hvordan egenskapene ved KI-systemer kan støtte mer persontilpasset læring, øke studentenes engasjement og forbedre faglige resultater (Kovari, 2025; Sichterman et al., 2025). Studiene gir indikasjoner om at KI-systemer som er pedagogisk godt designet, både kan bidra til å administrere, aktivt forme og forbedre de komplekse sosiale prosessene i samarbeidslæring.
En lovende egenskap ved spesialdesignete KI-systemer er muligheten for å skreddersy støtte i sanntid for samarbeidslæring. KI-systemer kan analysere gruppediskusjoner og individuelle bidrag og gi persontilpassede tilbakemeldinger på både gruppeprosesser og faglig innhold. De kan anbefale relevante læringsressurser basert på gruppens spesifikke utfordringer og gi adaptiv veiledning som hjelper dem med å holde seg på sporet (Kovari, 2025). Denne formen for «stillasbygging» kan bidra til at studentene får riktig støtte på riktig tidspunkt, noe som fremmer dypere kunnskapsbygging i fellesskap (Sichterman et al., 2025).
Det er likevel tegn på at KI-systemer kan styre interaksjonsmønstre i grupper på måter som ikke alltid støtter felles utvikling av kunnskap. For eksempel kan studenter som har tilgang til en samtalerobot i en gruppeprosess, ha en tendens til å samhandle mer med KI-systemet enn med medstudentene. Gruppen utvikler dermed et KI-sentrert samhandlingsmønster som går ut over student-til-student-samhandlingen (Feng, 2025). Dette peker mot at pedagogisk tilrettelegging også må rettes mot å regulere den sosiale adferden i gruppen, dersom KI-systemer skal styrke kvaliteten i samarbeidslæringen.
KI-systemer kan også brukes til å sette sammen grupper ut fra studentenes faglige ferdigheter, nivå og bakgrunn (Sichterman et al., 2025). Når gruppen jobber, kan studentene få felles bidrag og felles fremdrift visualisert i sanntid, noe som bidrar til å styrke den metakognitive bevisstheten til deltakerne. Synliggjøring av gruppens fremdrift fremmer sosialt delt regulering som en prosess der gruppen kollektivt overvåker og justerer sin egen læringsprosess (Kovari, 2025; Sichterman et al., 2025). Det er funn som tyder på at når samtaleroboter brukes i gruppe- og samarbeidsprosesser, blir selvreguleringen styrket mer, sammenliknet med når studenter bruker verktøyet individuelt. Den sosiale konteksten kan fungere som en buffer mot passiv KI-bruk ved at studenter utfordrer og diskuterer KI-generert innhold med hverandre (Younis, 2024).
Godt utformete KI-systemer, laget for å fremme samarbeid, kan mislykkes om studentene oppfatter systemet som inkompetent, upålitelig eller uklart. Studentenes opplevelse av verktøyet kan være like viktig som selve teknologien: Om et system oppleves som forstyrrende eller irrelevant, vil studentene raskt slutte å bruke det, uavhengig av de pedagogiske intensjonene bak (Edwards et al., 2025).
Selv om kognitive og etiske sider ved KI i egenlæring begynner å bli bedre forstått, er påvirkningen på de sosiale aspektene av læring mindre utforsket. Å søke hjelp er en sosialt forankret praksis som fremmer samarbeid, tillit og delt læringsansvar, og gir tilgang til ulike perspektiver, alternative problemløsningsstrategier og taus kunnskap om fagets normer og praksis. Spesialdesignede KI-systemer kan styrke samarbeidslæring, men det studentene bruker mest er generiske KI-systemer. Disse kan fortrenge eller erstatte sosiale interaksjoner. Samarbeidslæringen kan forstyrres konkret av at KI-systemet fungerer som en «mellommann» som passiviserer studentene og plasserer dem i en faglig underlegen rolle. Når barrierene for faglig kontakt mellom studentene øker, forstyrres utviklingen av sosiale fellesskap som er avgjørende for kunnskapskonstruksjon, faglig identitet og sosial tilhørighet – med negative konsekvenser for læring, motivasjon og akademisk måloppnåelse (Hou et al., 2025).
Kunnskapsgrunnlaget peker mot at KI-systemer som er designet for å fremme samarbeidslæring bør være formålsspesifikke, tilby pedagogisk støtte på riktig tid i riktige deler av prosessene, og sikte mot å styrke gruppeinteraksjon og metakognitiv refleksjon. I det internasjonale forskningsfeltet arbeides det med hvordan samarbeidslæring best kan støttes i multimodale teknologiske omgivelser (Järvelä et al., 2023).
Boks 6.2 Gruppearbeid med KI-støttet tilbakemelding ved Universitetet i Oslo
Samarbeid i grupper over tid kan innebære utfordringer som skjev deltakelse, uklare roller, mangelfull kommunikasjon, sosioemosjonelle dynamikker og vansker med å følge progresjonen i gruppearbeidet. For å møte slike utfordringer har forskningsprosjektet TeamLearn ved Universitetet i Oslo utviklet et teknologistøttet læringsdesign som kombinerer læringsforskning, informatikk og læringsanalyse i en KI-basert løsning for gruppearbeid.
Læringsdesignet ble prøvd ut i et studieemne i rettsvitenskap, der grupper på 4–5 studenter arbeidet over en periode på 12 uker med komplekse, virkelighetsnære prosjekter. Gruppearbeidet omfattet diskusjon av ideer og juridisk kunnskap, planlegging og koordinering av oppgaver, fordeling av ansvar, deltakelse i møter, samt felles utvikling av produkter og en grupperapport.
Datakildene omfatter lydopptak fra gruppemøter, gruppens produkter under utvikling og studentenes egne refleksjoner om samarbeidet. Dataene ble analysert ved hjelp av KI og multimodal læringsanalyse for å identifisere mønstre i interaksjonen og generere tilbakemeldinger på gruppearbeidet. Analysene ble visualisert i et studentrettet dashbord som blant annet viste taletid og aktivitetsnivå i møter, samt konkrete tilbakemeldingspunkter på grupperapportene. De KI-støttede tilbakemeldingene bygget på fastsatte vurderingskriterier for emnet. Studentene kunne også stille spørsmål til KI-agenten om tilbakemeldingene, og velge om de ønsket ytterligere veiledning fra faglærer.
Gjennom objektive representasjoner av deltakelse og gruppedynamikk legger dashbordet til rette for at studentene mer effektivt kan reflektere over eget samarbeid og justere sine praksiser. Prosjektet utvikler også en lærerversjon av dashbordet, som skal støtte undervisere ved å gi bedre innsikt i gruppenes progresjon og interaksjon mellom veiledningsøkter. Undervisere fra fire fagområder – jus, medisin, utdanningsvitenskap og informatikk – samarbeider med utdanningsforskere for å ta i bruk modellen i sine emner.
Kilde: Informasjon til utvalget fra professor Crina Damşa, Universitetet i Oslo.
6.4.6 KI, simulering og læring
Høyere utdanning har tradisjonelt hatt begrensede muligheter for læring i realistiske yrkessituasjoner. Selv der studentene har praksis som en del av utdanningen, kan praksisperiodene gi begrensede muligheter for mengdetrening, for å øve på sjeldne situasjoner eller for å prøve oppgaver som det er etisk uforsvarlig å overlate til noen som ikke er en autorisert profesjonsutøver (Chernikova et al., 2020).
Helse- og sosialfagutdanningene har over tid gjort større bruk av simulering til å forberede studentene til praksis og yrkesutøvelse. Simulering er også brukt innen andre fagområder, som naturfag, tekniske fag og ingeniørutdanning. I sykepleie gir simulering studentene mulighet til ferdighetstrening og utvikling av klinisk kompetanse i et trygt læringsmiljø. Ved å øve under simulerte omstendigheter kan pasientsikkerheten ivaretas samtidig som studentene får øvelse i komplekse kliniske situasjoner (Karlsen, 2025).
Teknologistøttet simulering gjør at studenter kan øve i trygge miljøer som etterlikner reelle situasjoner, uten risiko for seg selv eller andre. Simuleringer kan også fremme motivasjon, aktiv deltakelse, refleksjon og bedre bruk av kunnskap (Cook et al., 2011). Et vanlig eksempel på simuleringstrening i sykepleieutdanningen i Norge er bruk av fysiske dukker, som er relativt kostbare og som studentene ofte har begrenset tilgang til (Skogedal, 2024).
Boks 6.3 KI i medisinutdanning
I oktober 2025 hadde mer enn 2490 forskere publisert vitenskapelig om bruk av generativ KI i medisinsk utdanning. Forfatterne og artiklene med størst innflytelse gir en pekepinn om hvilke konkrete tema knyttet til KI i medisinsk utdanning som får mest oppmerksomhet. Det mest omtalte temaet handler om KI-støttet vurdering og tilrettelegging for optimale læringsforløp. Så følger to mer spesifikke temaer: KI-basert analyse av hjernebilder (neuroimaging), etterfulgt av multimodal KI, som 3D-simuleringer og virtuell virkelighet for undervisning i anatomi og radiologi.
Et felles budskap fra studiene er at KI-baserte simuleringer ikke er feilfrie, at studentene har behov for å kunne kritisk vurdere anbefalingene de får fra systemene og at simuleringer må balanseres med «ekte» praksis (Wang et al., 2025).
KI-utviklingen har åpnet nye muligheter for simulering av autentiske situasjoner, ved å gjøre det enklere, billigere og mer tilgjengelig å lage realistiske, tilpassede og interaktive læringsmiljøer (Mollick et al., 2024). KI-genererte scenarioer og adaptive læringssystemer kan skape dynamiske læringsomgivelser som ligger tettere opp mot yrkesvirkeligheten.
I helsefaglig utdanning kan samtalebaserte virtuelle pasienter være effektive for å utvikle studentenes kliniske kompetanse og resonneringsevner (García-Torres et al., 2024). Generative KI-systemer kan bidra til at virtuelle pasienter blir mer realistiske, og responsene mer nyttige for egen læring (Peralta Ramirez et al., 2025). Mye tyder på at kombinasjonen av virtuell virkelighet (VR) og generativ KI kan gi svært realistiske og gode simuleringer (Chance, 2025). Gjennom VR får studentene delta i realistiske simuleringer som gjenskaper kritiske kliniske hendelser.
KI-drevne simuleringer er testet i designutdanning for å fremme dialog, refleksjon og kritisk tenkning gjennom deltakende designprosesser, og for å støtte studentene med å navigere komplekse utfordringer (Hautopp et al., 2025). Dybdelæring kan bli fremmet med bruk av bedriftssimuleringer i økonomisk-administrative fag (Baksaas & Nygård, 2021), og i lærerutdanning kan KI-baserte løsninger styrke læringseffekten av virtuell simulering (Bauer et al., 2025).
I maritime fag er det utstrakt bruk av simulering i undervisningen. Når «simulering er faget», som det er beskrevet av studenter, ligger det muligheter for å bruke KI til å skape mer avanserte og adaptive simuleringer (Korseberg et al., 2024). Her kan KI løse noen av de begrensningene studentene opplever, hvor de ikke får øvd på alle typer operasjoner.
Samtidig reiser KI-basert simulering spørsmål om autentisitet. Det er et åpent spørsmål i hvilken grad KI-baserte scenarioer med KI-generert video og syntetiske personer (pasienter, elever) kan styrke den faglige læringen (Korseberg et al., 2024).
Boks 6.4 Simulering ved bruk av KI og utvidet virkelighet i sykepleierutdanning
Gjennom å bruke KI-basert utvidet virkelighet (XR) til å simulere kliniske miljøer og pasientinteraksjoner, skal prosjektet XRHealthEdu gi sykepleierstudenter og ansatte tilgang til engasjerende og interaktive læringsformer som styrker kliniske ferdigheter og beslutningstaking. Simuleringene skal blant annet omfatte virtuelle, tredimensjonale læringsmiljøer; KI-genererte, menneskeliknende avatarer og innovative løsninger for veiledning på finsk, samisk og norsk. Prosjektet er et samarbeid mellom UiT Norges arktiske universitet, Uleåborgs universitet og Lapplands yrkeshøyskole og inngår i det europeiske Interreg-programmet for regionalt samarbeid.
Simuleringene vil benytte adaptive læringsteknikker støttet av KI for individuelt tilpasset og behovsbasert undervisning, tilbakemelding og vurdering i sanntid gjennom læringsprosessen. Målet er å integrere en XR-basert læreplan med moduler i ordinær sykepleierutdanning og på den måten bidra til bedre kvalitet og økt pasientsikkerhet i helsetjenesten.
Kilde: Prosjektets hjemmesider og informasjon til utvalget fra førsteamanuensis Anita Carin Gudmundsen, UiT Norges arktiske universitet.
6.4.7 Utvalgets vurdering
KI endrer ikke de grunnleggende mekanismene i hvordan læring foregår, gjennom kognitive prosesser og samhandling mellom mennesker og miljø. Imidlertid endres vilkårene for læringsaktiviteter betydelig, blant annet når det gjelder måten kunnskap gjøres tilgjengelig på, hvordan kunnskap kan utforskes og bearbeides, og hvordan utvikling av forståelse og ferdigheter kan støttes i utdanningene. I tillegg er det sannsynlig at arbeidsmåtene i mange fag vil endres, med implikasjoner for hvordan studentene kan og bør engasjere seg i det faglige innholdet. Utvalget mener derfor at det er behov for å gjøre helhetlige gjennomganger av aktivitetene i emner og studieprogrammer, og for å styrke bevissthet om forholdet mellom faglige premisser og tilrettelegging av innhold og aktiviteter i undervisningen. KI-systemer tilbyr nye muligheter for å styrke undervisning og læring, blant annet gjennom tilpasset veiledning, mer kontinuerlig tilbakemelding, forbedrede muligheter for simulering, presentasjon og utforskning av fagkunnskap i ulike modaliteter, og engasjering av studenter på nye måter i fagets metoder og forskningstilnærminger. Samtidig kan utstrakt bruk av KI-systemer innebære en fare for at studiearbeidet ytterligere individualiseres, der det store omfanget av egenorganisert tid i studiehverdagen kan forsterke forskjeller i ressurstilgang og studentenes forutsetninger for å lykkes.
Akademisk skriving og lesing er helt sentrale måter å tilegne seg fagets begrepsapparat, argumentasjonsformer og krav til evidens, og det er derfor viktig at KI-systemer ikke brukes på en måte som forstyrrer denne prosessen.
Tilbakemeldinger bør settes i en gjennomtenkt pedagogisk sammenheng, der KI-systemer kan sørge for rask tilbakemelding i stor skala, mens undervisere sørger for grundigere tilbakemeldinger på både produkter og arbeidsmåter.
Utvalget understreker videre at KI-systemer må brukes med forsiktighet i veiledningsprosessen for å ivareta tillitsrelasjonen mellom studenter og veiledere, og for å ivareta studentenes selvstendige faglige progresjon. Ansvaret her ligger både på institusjonsnivået med tanke på gode retningslinjer og god opplæring i hensiktsmessig bruk av KI, samt på den indviduelle veileder og student. Utvalget mener at insititusjonene fortsatt må legge til rette for og styrke menneskelig oppfølging av studentene.
Den læringsaktiviteten hvor undervisere har mulighet til å komme tettest på studentene, er i veiledning. Som vi har sett, betyr tilgangen på generativ KI at gode arbeidsvaner har enda mer å si for læringen. Utvalget vil på grunnlag av dette anbefale å sørge for en veiledningspraksis der veileder kan komme tett på studentenes arbeid, for å kunne støtte dem til å utvikle gode arbeidsmetoder og -vaner, med og uten KI-systemer. Det er viktig å legge til rette for sosial interaksjon og gode rammer for samarbeidslæring. For campusbaserte utdanninger er fysisk oppmøte avgjørende for å opprettholde kvaliteten på studietilbudene og læringsaktivitetene de rommer. Også for nettbaserte utdanninger er deltakelse i læringsaktivitetene viktig, selv om det ikke innebærer fysisk oppmøte. For å motvirke individualiserende og sosialt isolerende virkninger av KI-systemer, vil utvalget anbefale universiteter og høyskoler å vurdere sterkere krav til obligatorisk deltakelse i læringsaktiviteter.
I lys av observasjonene og vurderingene som er gjort i dette underkapittelet og det foregående (6.3), er det liten tvil om at det har stor betydning for læringen hvordan man bruker KI-systemer. Når dette settes sammen med studentenes rapportering om utilstrekkelig opplæring i bruk av KI-systemer (kap. 6.2.4), viser det et klart behov for å styrke opplæringstilbudet. Dette kan gjøres gjennom eksisterende studieemner, i støttetjenester og ved hjelp av klare og tilgjengelige veiledende retningslinjer.
6.5 Læringsmiljø og inkludering
Utformingen av læringsmiljøet i høyere utdanning legger rammer for undervisningen og læringsaktivitetene studentene gjennomfører. Blant faktorer i læringsmiljøet, påvirker presentasjonen av læringsmål og det faglige innholdet, samt valg av aktiviteter og vurderingsformer, studentenes muligheter til å tilegne seg kunnskap. Dette kan dreie seg om fleksibilitet og variasjon i måtene studentene får tilgang til læringsmateriellet, hva slags undervisnings- og læringsaktiviteter de kan ta del i, og hvordan de kan demonstrere hva de har lært. I tillegg til å fjerne barrierer kan en mer inkluderende undervisningspraksis øke studentenes motivasjon og prestasjoner (HK-dir, 2024b).
6.5.1 Retten til et godt læringsmiljø
Studenter har krav på et læringsmiljø som ivaretar deres helse, velferd og sikkerhet (jf. universitets- og høyskoleloven § 10-1). Begrepet læringsmiljø omfatter både de fysiske omgivelsene på lærestedet, det pedagogiske opplegget, organisatoriske og psykososiale forhold, samt de digitale løsningene studentene møter gjennom utdanningen. Oppfølging av læringsmiljøet skal være en del av institusjonenes systematiske arbeid med kvalitetssikring, og loven stiller krav om læringsmiljøutvalg for å sikre medvirkning i prosesser som gjelder læringsmiljøet.
KI åpner for nye måter å sikre et tilgjengelig og inkluderende læringsmiljø på. Samtidig har teknologien klare begrensninger og fører med seg nye utfordringer. Institusjonene har derfor et stort ansvar for hvordan KI påvirker studentenes læringsmiljø.
En viktig del av arbeidet med læringsmiljø er inkludering og ivaretakelse av studenter med funksjonsnedsettelse eller særskilte behov. En av fem studenter oppgir å ha en funksjonsnedsettelse som begrenser dem i studiene (Fredborg, 2024). Disse studentene kan møte en rekke barrierer som begrenser eller forsinker deres tilgang til utdanning, som gjør det vanskeligere å gjennomføre utdanningen eller påvirker studiekvaliteten negativt (HK-dir, 2025a). Universell utforming er en sentral strategi for å motvirke slike barrierer.
6.5.2 Universell utforming
Universell utforming handler om at både de fysiske og digitale forholdene ved utdanningsinstitusjonene skal være utformet med tanke på mangfoldet i studentgruppen. Universelle løsninger gir bedre kvalitet for alle, ikke bare de gruppene som trenger det mest.
I takt med at digitaliseringen av høyere utdanning har endret studenttilværelsen og åpnet for andre måter å lære på, er kravene til universell utforming av det digitale læringsmiljøet gradvis blitt skjerpet gjennom lovverk, rapporteringskrav og tilsyn. Løsningene må være utformet slik at alle studenter har mulighet til å delta aktivt i undervisning, vurdering og i det sosiale og faglige studentmiljøet. Kravene omfatter både nettsider, videotjenester, digitale læremidler og lærings- og eksamensplattformer.
Institusjonenes egen rapportering viser tydelige utfordringer med å oppfylle kravene, samtidig som det er stor variasjon. Samlet sett har de digitale eksamensløsningene og læringsplattformene i underkant av 60 prosent samsvar med gjeldende krav til universell utforming av IKT-løsninger. Dette kan gå ut over studentenes læringsutbytte og eksamensprestasjoner (HK-dir, 2025d).
KI-støttet veiledning og bistand til undervisere og andre som legger inn innhold i løsningene, kan forenkle og effektivisere arbeidet med universell utforming. Automatisk teksting av video har for eksempel frigitt mange arbeidstimer som tidligere gikk til å skrive tekstene manuelt. KI-systemer kan forbedre struktur og språk i dokumenter og nettsider og foreslå tekstforklaringer til visuelt innhold (Pedemonte et al., 2025). Testing av løsninger og innhold opp mot tilgjengelighetskravene kan også delvis automatiseres ved hjelp av KI (López-Gil & Pereira, 2025).
Likevel er det fortsatt behov for menneskelige vurderinger og håndtering av universell utforming. Man kan heller ikke stole på at KI-systemer produserer korrekt kode eller er i stand til å rette feil, når løsningene de er trent opp på har mangler (Bufdir, 2026). Uten korreksjonsmekanismer kan resultatet være at KI gir mindre universell utforming, ikke mer.
KI-systemer som tilbys studentene må i seg selv følge kravene til universell utforming. Det gjelder både for brukergrensesnittet og innholdet løsningene genererer. Siden innholdet ikke er forhåndsdefinert, men et individuelt og personalisert resultat av interaksjonen mellom bruker og robot, oppstår det en rekke nye utfordringer. Inkonsekvent struktur, komplekst eller utydelig språk, manglende eller mangelfulle beskrivelser av visuelt innhold, samt usikkerhet knyttet til personvern og databehandling, er eksempler på forhold som særlig kan gå ut over utsatte brukergrupper. For personer med kognitive utfordringer kan informasjonsmengde og raske temaskifter være en ekstra belastning. I tillegg kan den kontinuerlige endringen av innhold skape problemer for skjermlesere og gjøre tastaturnavigasjon vanskelig.
6.5.3 Individuell tilrettelegging
Når løsningene ikke er tilstrekkelig universelt utformet, har utdanningsinstitusjonene plikt til å sørge for egnet individuell tilrettelegging av blant annet undervisning, læremidler og eksamen (jf. universitets- og høyskoleloven § 10-5). Vurderingen av tiltak skal være individuell, konkret og gjøres i samarbeid med studenten.
KI-systemer åpner for en langt større grad av persontilpassede løsninger enn det som tidligere har vært praktisk mulig. Det kan lette institusjonenes arbeid med tilrettelegging for enkeltstudenter. Potensielt kan det også redusere behovet for individuell tilrettelegging ved at flere behov dekkes av standardløsninger. For eksempel kan personer med synshemminger få hjelp av automatiserte verktøy til å tolke visuelle omgivelser (Ahmed et al., 2025). Mobilapplikasjoner som gjenkjenner og leser opp tekst fra papir, eventuelt forenklet eller oversatt til et annet språk, kan bidra til å gjøre pensumlitteratur tilgjengelig for flere (Marais et al., 2024). Personer med dysleksi kan få økt leseforståelse ved at KI-systemer leser teksten høyt, markerer ord og deler dem opp i stavelser. Skriveassistenter kan fange opp feil, gi økt trygghet og redusere stress. Teknologien kan fjerne barrierer for bruk ved å forstå flere former for inndata, som tale, bevegelser eller ansiktsuttrykk.
Utover forbedret hjelpemiddelteknologi kan KI også bidra til mer effektiv administrasjon av tilretteleggingsarbeidet, blant annet i vurderingen av behov og mulige løsninger.
På den annen side kan bruk av persontilpassede KI-assistenter føre med seg store etiske utfordringer. Lagring og bruk av sensitive personopplysninger, herunder biometriske data, kan være risikabelt. Skjevheter i treningsdata kan gi diskriminerende utslag. Forskjellig tilgang til løsningene, av økonomiske eller andre årsaker, kan forsterke ulikheter. Utviklingen kan baseres mer på hvilke muligheter teknologien byr på, enn på brukernes reelle behov. I tillegg kommer bekymringen for at innføring av slike KI-systemer kan opprettholde en ukritisk tro på at teknologi kan løse eller kompensere for funksjonsnedsettelser – såkalt tekno-ableisme – som underkjenner verdien av menneskelig mangfold og overser strukturelle barrierer som bidrar til ekskludering (Linsenmayer, 2025; Shew, 2020).
6.5.4 Psykososialt læringsmiljø
Undervisningsaktiviteter, samarbeids- og vurderingsformer legger til rette for og påvirker sosialisering og interaksjoner mellom studenter, og mellom student og underviser. Her kan KI fungere både som en tilrettelegger og som en isolator.
Den isolerende virkningen KI kan ha, kommer til uttrykk i en undersøkelse ved Høgskulen på Vestlandet (HVL) (Ludvigsen et al., under utgivelse). Enkelte av studentene som er sitert i undersøkelsen, uttrykker bekymring for at medstudenter ikke lenger er interessert i å diskutere faglige spørsmål, at de snakker med samtaleroboten i stedet for med hverandre, og at bruk av KI fjerner læringseffekten ved samarbeidet. Mens noen setter pris på at en samtalerobot kan oppklare uenigheter i gruppen, uttrykker andre frustrasjon over medstudenter som ikke er i stand til å ta ansvar for eller forklare egne bidrag fordi innholdet er KI-generert.
Undersøkelsen ved HVL viser også at 40 prosent av studentene som svarte i 2025, bruker generativ KI for noe de savner i studiehverdagen: noen å snakke med, diskutere med, samarbeide med; noen som ser dem og er opptatt av det samme som dem; veiledning, støtte og oppfølging fra undervisere; tilbakemelding og forklaring, tilgjengelig døgnet rundt (Ludvigsen et al., under utgivelse).
Når KI erstatter menneskelig kontakt og overtar disse rollene fra medstudenter og undervisere, kan det sosiale fellesskapet forvitre. Terskelen blir høyere for å be andre om hjelp og avsløre egen usikkerhet eller uvitenhet. Resultatet kan bli økt isolasjon, mindre følelse av fellesskap og redusert evne til å håndtere motgang og uenigheter i samarbeidsrelasjoner. På den annen side kan KI bidra til å fylle behov studentene ellers ikke ville fått dekket, slik som å våge å stille dumme spørsmål, eller hjelp til å sette i gang diskusjoner og få fremdrift i gruppearbeid. Kombinert med gode aktiviteter i læringsdesignet kan det tenkes å gi en opplevelse av økt støtte og trygghet i læringsmiljøet.
6.5.5 Utvalgets vurdering
Studentene er en mangfoldig gruppe, med ulike behov for støtte og tilrettelegging av læringsaktiviteter. En viktig oppgave for universiteter og høyskoler er å nå ut til enda flere målgrupper, for å styrke inkludering, likestilling og mangfold, motvirke utenforskap og bidra til økt deltakelse i arbeidslivet. Utvalget forventer derfor at studentpopulasjonen blir ytterligere sammensatt i tiden fremover. KI-systemer kan åpne muligheter for flere, forutsatt god bruk og gode verktøy. Studenter med behov for tilrettelegging kan også bruke generativ KI som en utjevnende faktor i studiene sine. I tillegg kan fleksibiliteten i tid og sted som KI-systemene tilbyr, legge til rette for læringsstøtte når studentene trenger det, gjerne i kombinasjon med andre digitale og ikke-digitale ressurser. Samtidig innebærer det institusjonelle ansvaret for læringsmiljøet at risikoen for mulige negative effekter av KI-bruk må håndteres.
6.6 Råd til studenter om læringsfremmende bruk av generativ KI
Utvalget har vurdert hva slags råd institusjonene og fagmiljøene kan gi til sine studenter, om hvordan de skal bruke generative KI-systemer på en måte som fremmer og ikke hemmer deres læring. Rådene som følger, er ikke å anse som varige og ufravikelige regler. De er ment å støtte institusjonene og fagmiljøene i deres selvstendige ansvar for å gi veiledning og opplæring til studentene.
-
Tenk, les og prøv først; gjør eventuelt bruk av KI-systemer senere i arbeidet.
-
Læring krever kognitiv anstrengelse. Det er fristende å få raske svar når anstrengelsen blir stor, men det kan undergrave læringen.
-
Instruer KI-modellen til å stimulere din egen tenkning heller enn å gi deg ferdige løsninger, til å gi deg kilder heller enn å gi deg sammendrag, og til å gi deg tilbakemeldinger på ditt eget arbeid heller enn utkast og redigeringsforslag.
-
Vær bevisst på forskjellen mellom de oppgavene og øvelsene hvor det å bruke KI-systemer er en del av formålet, og de hvor du skal lære noe annet enn å bruke KI.
-
Vær oppmerksom på KI-modellenes svakheter med tanke på feilaktige resultater, språk, skjevheter i treningsgrunnlaget, hallusinasjoner og tendens til å smigre brukeren.
-
Test dine kunnskaper og ferdigheter i faget uten å søke hjelp fra KI-systemer.
-
Ikke bruk KI som en erstatning for diskusjoner med dine medstudenter og undervisere, eller som en unnskyldning for ikke å dra på campus.
-
Planlegg din egen læring og hvilken bruk du eventuelt kan gjøre av KI-systemer i tråd med dette.
-
Sett deg inn i institusjonens retningslinjer om forsvarlig bruk av KI-systemer.
6.7 Anbefalinger
Hvilken kompetanse undervisere har, hvilke KI-systemer som tas i bruk og hvordan vurdering gjennomføres, er viktige faktorer for hvordan vi skal lære. Anbefalinger om vurderingsformer gis i kapittel 7, anbefalinger om utvikling og anskaffelse av KI-systemer gis i kapittel 8 og anbefalinger om universitets- og høyskoleansattes kompetanse gis i kapittel 10.
Utvalget anbefaler universiteter og høyskoler å
-
sørge for at fagmiljøene gjør regelmessige, KI-bevisste vurderinger av studietilbudenes læringsaktiviteter
-
sørge for at alle studenter får opplæring i læringsfremmende bruk av KI-systemer gjennom
-
klare, tilgjengelige og oppdaterte retningslinjer
-
å bygge slik opplæring inn i emnetilbud og i støttetjenester for studentene
-
-
sørge for en tett veiledningspraksis slik at veileder har innblikk i studentens arbeidsmetoder og -vaner, og kan støtte studenten i å utvikle dem
-
vurdere sterkere krav til obligatorisk deltakelse i læringsaktiviteter
Utvalget anbefaler sentrale myndigheter å
-
prioritere forskning på fagspesifikk læring med KI-systemer i finansiering av utdanningsforskning
7 Eksamen og vurdering
7.1 Innledning
Når kunstig intelligens (KI) medfører endringer i studienes innhold og læringsaktiviteter, får det implikasjoner også for hvordan læring vurderes. Kapittel 6 Hvordan skal vi lære? fremhevet betydningen av selvregulering og metakognisjon for læringen og for at studentene skal ta KI-systemer i bruk på en konstruktiv måte. Fagenes innhold og metoder kan også endre seg, med fagspesifikke implikasjoner for hva det vil si å utføre analyser, undersøke holdbarheten i argumenter eller utvikle ny innsikt. Samtidig utfordres faglærerne på å integrere KI i et helhetlig læringsdesign, både for enkelte studieemner og studieprogrammer. Både generell og fagspesifikk KI-kompetanse utvikles over tid, og i møte med fagenes innhold og arbeidsmåter. Tilsvarende må vurderingsformene tilpasses disse endringene.
En vedvarende spenning gjelder forholdet mellom vurdering som støtte til læring og vurdering som kontroll av læringsutbytte, det som ofte omtales som henholdsvis formative og summative aspekter i vurdering. Institusjonene skal både gi og sertifisere læringsutbytte. For begge hensyn skaper og forsterker KI en rekke muligheter og utfordringer. Mulighetene dreier seg blant annet om hvordan KI-systemer kan bidra til vurderinger av og tilbakemeldinger på studentbesvarelser, og i utformingen av oppgaver og vurderingsformer. De største utfordringene dreier seg om hvordan man kan måle hva studenter kan og vet når de har tilgang på verktøy som kan produsere og bearbeide faglig innhold, og hvilke gråsoner dette skaper i eksamensregelverket.
KI-systemer gir altså parallelt muligheter for å styrke formative vurderinger, samtidig som sertifiseringen av oppnådd læringsutbytte blir mer krevende. KI-systemer gir også et innovasjonsrom for å utvikle nye vurderingsformer, herunder adaptive og persontilpassede prøver.
Et gjennomgående tema i kapittelet er hvordan vi kan innrette vurderingsaktiviteter slik at de samlet både fremmer læring og gir en prøving av hva studentene kan og vet. Kapittel 7.2 beskriver hvordan eksamen og vurdering er regulert i dag, hva som skiller ulike vurderingsformer fra hverandre, og hvilke hensyn som ligger til grunn for valg av vurderingsform. Kapittel 7.3–7.11 tar for seg de ulike utfordringene og mulighetene KI stiller for hvordan man gjennomfører vurdering i høyere utdanning.
7.2 Hvordan vurdering gjennomføres og reguleres
7.2.1 Dagens regulering
Universitets- og høyskoleloven (uhl.) § 11-6 fastsetter at universiteter og høyskoler skal «sørge for at studentenes kunnskaper og ferdigheter blir prøvd og vurdert på en upartisk og faglig betryggende måte» og videre at vurderingen skal «sikre det faglige nivået på studiet». Loven gir ellers ingen føringer på hvordan eksamen og arbeidskrav skal gjennomføres.
Eksamen og arbeidskrav er videre regulert av den enkelte institusjon. Universitets- og høyskoleloven gir institusjonene hjemmel til å fastsette forskrift om gjennomføring av eksamen (§ 11-6) og aktiviteter og oppgaver som må gjennomføres for å kunne gå opp til eksamen (§ 11-4). Institusjonenes forskrifter fastsetter regler som gjelder på alle eksamener, f.eks. definisjoner av fusk. I tillegg lager institusjonene supplerende regler for den enkelte vurdering, f.eks. hvilke hjelpemidler som er tillatt.
7.2.2 Vurderingsformer
Kvalitetsmeldingen (Meld. St. 16 (2016–2017)) satte som mål at studenter skal møte varierte vurderingsformer i høyere utdanning. Det finnes et spekter av muligheter, både når det gjelder rent formmessige valg og vurderingens innhold, f.eks. hvilke oppgaver som gis og hvordan de er strukturert. Vurderingsformene kan kategoriseres på mange måter, og her trekker vi frem noen skillelinjer som vil benyttes i diskusjoner i kapitlet:
-
Eksamen og arbeidskrav: Vurderinger kan gjennomføres som eksamener eller som arbeidskrav. En eksamen er en vurdering som gir uttelling i studiepoeng og hvor resultatet påføres vitnemålet. Et arbeidskrav er en aktivitet som studentene må gjennomføre for å kunne gå opp til eksamen, uten at arbeidskravet i seg selv gir uttelling i studiepoeng.16
-
Format: Det er vanligst med skriftlige oppgaver i høyere utdanning, men også muntlige eksamener er utbredt på tvers av fagområder. I mange utdanninger utgjør også praktiske og estetiske oppgaver en viktig kategori, f.eks. i helsefag med klinisk praksis eller i utøvende musikkfag.
-
Sammensatte og ikke-sammensatte vurderinger: I stedet for å avholde eksamen som en enkelt vurderingsenhet er det mulig å sette sammen flere vurderingsenheter, slik at man får en samlet vurdering av oppnådd læringsutbytte på tvers av enhetene. For eksempel kan eksamen holdes som en mappeeksamen, hvor studentene skal levere et knippe med arbeider. Gjennom å dele opp eksamen i flere vurderingsenheter kan man også kombinere ulike formater, f.eks. skriftlige med praktiske eller muntlige oppgaveformater. Dersom en eksamen består av vurderingsenheter med ulike formater kalles det gjerne for en kombinasjonseksamen.
-
Individuelt arbeid eller samarbeid: Individuelle oppgaver er det vanligste i høyere utdanning, men over tid er det blitt vanligere å åpne for eller gi samarbeidsoppgaver.
-
Lokasjon: Vurderingsaktiviteten kan gjennomføres på campus (herunder som skoleeksamen), i eksternt eksamenslokale eller et hvilket som helst sted med internettilkobling (som hjemmeeksamen). Det blir også gjennomført vurderinger i utplassert praksis, f.eks. på skoler og sykehus, og det kan være mulig med fysiske eksamenslokaler utenfor campus.
-
Kontrollerte og ikke-kontrollerte vurderingsformer: I det vi kaller en kontrollert vurderingsform føres det tilsyn med hvordan oppgaven besvares, f.eks. hvilke hjelpemidler kandidaten tar i bruk. En skoleeksamen vil typisk sett være kontrollert, mens en (uovervåket) hjemmeeksamen vil være ikke-kontrollert.
-
Varighet: Det er et stort spenn i hvor lenge vurderingsaktiviteter kan pågå, fra mindre enn en time til et år eller mer.
-
Omfang: Vurderinger har varierende omfang målt i studiepoenguttelling, fra arbeidskrav til masteroppgaver på 60 studiepoeng. Omfang henger sammen med varighet, men er ikke identisk: En eksamen på seks timer kan ha et større omfang enn et arbeidskrav som man har flere uker på å besvare.
7.2.3 Utbredelse av ulike vurderingsformer
Det er et stort mangfold av vurderingsformer. Riksrevisjonen viser i sin rapport om universitetene og høyskolene sitt arbeid med å videreutvikle kvaliteten i studieprogrammene (2023) et oversiktsbilde over vurderingsformer for perioden 2016–2021. I denne perioden var det ifølge institusjonenes emnebeskrivelser lite endring i hvilke vurderingsformer som ble benyttet, men med en nedgang i bruken av skriftlig eksamen. For å få en bedre oversikt over utviklingen i norsk høyere utdanning de seneste årene, hentet utvalget inn data fra Felles studentsystem (FS) om omfanget av ulike eksamensformer fra 2016 til 2025.17 Datasettet omfatter alle studieemner ved 29 institusjoner, som sammen står for om lag 90 prosent av den totale studentmassen i norsk høyere utdanning.18 Figur 7.1 viser den årlige utviklingen i bruk av ulike eksamensformer som andel av alle eksamener.
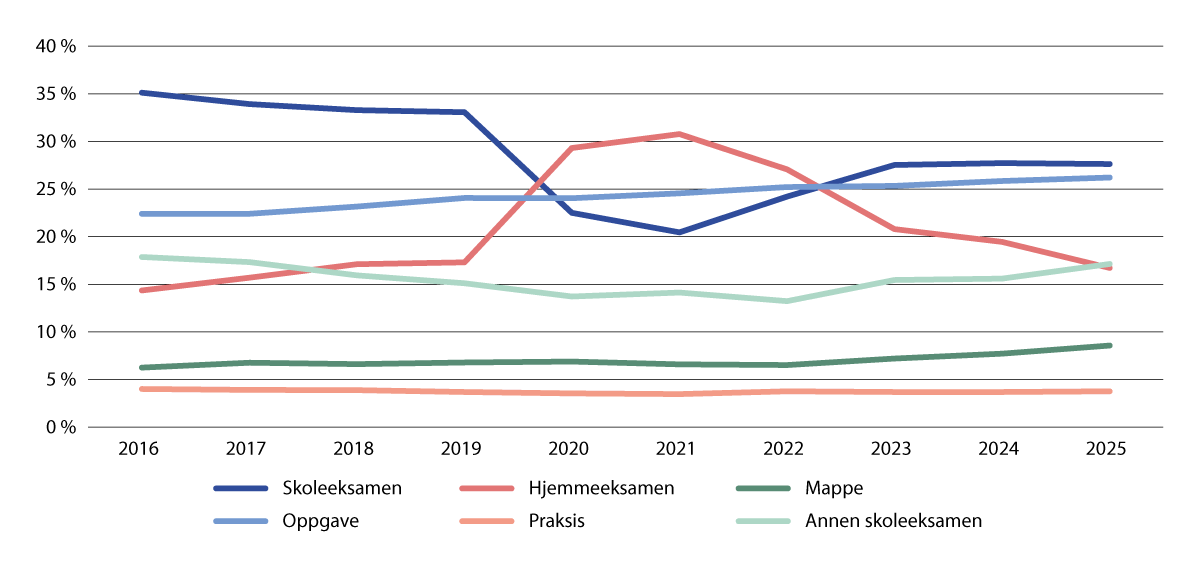
Figur 7.1 Eksamensform som andel av total
Kategoriene «Skoleeksamen» og «Annen skoleeksamen» viser i hovedsak til henholdsvis skriftlige og muntlig eksamener som blir gjennomført på campus under en form for tilsyn, «Praksis» til godkjente praksisstudier, og «Hjemmeeksamen», «Mappe» og «Oppgave» i hovedsak til ikke-kontrollerte eksamensformer. Statistikken tar utgangspunkt i forhåndsdefinerte kategorier i FS som alle institusjonene rapporterer på. FS gir i gitte tilfeller rom for tvetydighet i institusjonenes bruk av kategoriene, og datagrunnlaget lar seg derfor ikke fullt ut kvalitetssikre. Siden feilmarginen er lav og dataomfanget er stort er det likevel god grunn til å stole på tendensene som fremkommer.
Kilde: Felles studentsystem
De største endringene er i pandemiårene, hvor bruken av skoleeksamen sank betydelig og bruken av hjemmeeksamen steg betydelig. Det har ikke vært en tilsvarende endring siden ChatGPT ble lansert for allmennheten i november 2022: Hjemmeeksamen er i dag omtrent på nivå med 2019, mens skoleeksamen har ligget omtrent flatt i perioden 2023–2025. Bruken av annen skoleeksamen (stort sett muntlig eksamen) har hatt en utvikling med forsiktig nedgang frem til utgangen av pandemien, hvor utviklingen snudde til en forsiktig oppgang. Andelen emner hvor denne eksamensformen benyttes er nå omtrent på samme nivå som for ni år siden. Det er verdt å merke seg at det er en treghet i endringer i eksamensformer, ettersom det er fastsatte frister for dette, vanligvis årlig.
Data om hvilke vurderingsformer som blir brukt ved institusjonene er registrert i Felles studentsystem, men ligger ikke enkelt tilgjengelig. Dersom en sammenstilling av disse dataene hadde vært gjort tilgjengelig, ville sentrale myndigheter og institusjonene selv lettere kunne følge med på den nasjonale utviklingen og ha et kunnskapsgrunnlag på dette feltet. Utvalget vil derfor anbefale at sentrale myndigheter i samråd med institusjonene sørger for bedre tilgang til statistikk om vurderingsformer.
7.2.4 Ressursbehov ved ulike vurderingsformer
Utvalget kjenner ikke til at det finnes oversikter som sammenlikner ressursbehovet for ulike vurderingsformer på nasjonalt nivå. Universitets- og høyskolelovutvalget diskuterte kostnader knyttet til krav om to sensorer ved eksamen (NOU 2020: 3). Lovutvalget slår fast at det er utfordrende å kartlegge og vurdere kostnadene ved å innføre et krav om to sensorer ved eksamen, fordi slike kostnader i stor grad varierer avhengig av studieretning og eksamensomfang. Videre diskuterer lovutvalget kostnadsdrivere ved bruk av sensor, og identifiserer tre kostnadstyper: lønn til interne sensorer, honorar til eksterne sensorer og reise- og oppholdskostnader for eksterne sensorer.
Universitets- og høyskolelovutvalgets diskusjon var avgrenset til kostnader til sensur. Siden vi har en bredere problemstilling, har utvalget henvendt seg til et utvalg UH-institusjoner med ulik størrelse, med en forespørsel om estimater på kostnader per kandidat for skoleeksamen, muntlig eksamen og hjemmeeksamen. Institusjonene hadde ikke nøyaktige estimater med alle kostnadselementer, men utvalget fikk gode vurderinger av hvilke kostnadsdrivere som inngår i disse vurderingsformene.
En del av kostnadsdriverne er felles på tvers av de tre vurderingsformene. Dette inkluderer vitenskapelig ansattes tidsbruk til eksamensforberedelser med studenter, å utarbeide oppgaver, finne ekstern sensor, dialog med sensor, sensurering av eksamen og samsensur; honorar til ekstern sensor; administrativt personales tidsbruk til eksamensadministrasjon; veiledning med eksamensrelaterte akademiske eller tekniske spørsmål; og utgifter til digitalt eksamenssystem. Honorar til ekstern sensor er avhengig av sensors kompetansenivå og lønnsplassering. Kostnaden vil også variere med eksamensform, antall kandidater, eksamenens varighet, behov for sensormøter og eventuelle reise- og oppholdsutgifter.
For skriftlig eksamen bruker man i tillegg ressurser på håndtering av karakterbegrunnelse og klager, IT-brukerstøtte og digitalt system for plagiatkontroll. For skriftlig eksamen med tilsyn kommer det i tillegg kostnader til tilsynspersonale, inkludert honorar og administrasjon. For eksamen med fysisk oppmøte (skoleeksamen og en andel muntlige eksamener) kommer det kostnader til klargjøring av lokaler, og eventuelt ekstra utgifter til eksamenslokaler. Arealkostnader inkluderer husleie, strøm, renhold og vedlikehold.
Institusjonene rapporterer om at kostnadene til de ulike eksamensformene varierer betydelig med hensyn til fag og emnestørrelse for de enkelte eksamensformene. En del av kostnadene inngår i institusjonens ordinære drift og kan være vanskelige å tallfeste. To av de tre institusjonene som estimerte kostnader i sitt svar til utvalget, indikerte at kostnadene til skoleeksamen er høyere enn til hjemmeeksamen. Sett i lys av alle usikkerhetsmomentene har ikke utvalget et tilstrekkelig grunnlag for å estimere kostnadene ved de ulike eksamensformene.
Det er likevel verdt å bemerke at lokaler og infrastruktur kan bli en stor kostnadsdriver dersom bruken av skoleeksamen øker mye. Det vil ha mye å si om institusjonen har tilstrekkelig dekning i eksisterende lokaler, om man må leie ekstra arealer, eller om man må anskaffe nye lokaler. Økt bruk av enkelte former for sammensatte vurderinger (se kapittel 7.6) kan også gi økte kostnader.
7.2.5 Formative og summative aspekter i vurdering
Det formative aspektet av vurdering dreier seg om hvor stor læringsgevinst det gir å gjennomføre vurderingsaktiviteten, og det summative om hvorvidt og hvordan vurderingsaktiviteten tjener til å få frem og måle hva studenten kan og vet. Begge aspektene opptrer gjerne i en og samme vurderingsaktivitet, selv om hovedformålet med vurderingen kan være det ene fremfor det andre.
De formative og summative aspektene ved vurdering speiler to grunnleggende funksjoner for universiteter og høyskoler: Institusjonene skal både gi og sertifisere læringsutbytte. Beslutninger om vurderingsform og oppgaveinnhold hviler på hensynet til disse to funksjonene.
Et annet hensyn er at vurderingen skal henge sammen med undervisningen og være egnet til å prøve studietilbudets fastsatte læringsutbytte. I norsk høyere utdanning er dette prinsippet delvis forskriftsfestet som et krav til akkreditering av studietilbud, jf. neste underkapittel om meningsskapende samsvar.
De formative og summative aspektene ved vurderingsaktiviteter speiles også i de ulike typene vurderinger studentene kan få på sine arbeider. Det å vurdere besvarelser som godkjent, ikke godkjent eller med bokstavkarakterer, har et summativt formål. Summative formål kan være å sikre en terskelverdi for videre studier, sertifisere bestemte kompetanser for yrkespraksis, eller å rangere kandidater. Tilsvarende skal karakterbegrunnelser primært sette studenten i stand til å forstå hvorfor det ble fattet et bestemt karaktervedtak. De tilbakemeldingene studentene får underveis i arbeid med en oppgave har, til forskjell fra karakterer og karakterbegrunnelser, typisk sett rent formativt formål. Tilbakemeldinger og formativ vurdering er nærmere diskutert i kapittel 7.7.
7.2.6 Meningsskapende samsvar
Undervisnings- og vurderingsformene i et studietilbud skal bidra til at studentene oppnår de fastsatte læringsutbyttene, og til å sertifisere at de har oppnådd dem. Den kunnskapen og de ferdighetene studentene skal utvikle (kapittel 5), og hvordan de skal utvikle dem gjennom utdanningen (kapittel 6), legger dermed vesentlige premisser for vurdering. Prinsippet om at det skal være sammenheng mellom det studentene lærer, undervisnings- og læringsaktivitetene og måten man vurderer hva studentene har lært, kalles meningsskapende samsvar (constructive alignment) (Biggs & Tang, 2011).
Prinsippet om meningsskapende samsvar er delvis forskriftsfestet som akkrediteringsvilkår, altså som krav alle studietilbud må innfri. Universitets- og høyskoleforskriften (§ 1-11) fastsetter:
-
d. Studietilbudets innhold, oppbygging og progresjon skal være tilpasset læringsutbyttet.
-
e. Undervisnings-, lærings- og vurderingsformer skal være tilpasset læringsutbyttet og utformet slik at de fremmer at studentene tar en aktiv rolle i å forme læringsprosessen.
Disse formuleringene fremhever betydningen av et helhetlig læringsdesign, slik et studietilbud er organisert fra institusjonens og faglærers side. Samtidig anerkjenner ordlyden i forskriften at læringsutbyttet er avhengig av de konkrete læringsaktivitetene studentene utfører og de læringsprosessene de går gjennom, der deres egen innsats og orientering er avgjørende.
7.2.6.1 Utvalgets vurdering
KI både utfordrer og forsterker behovet for helhetlig pedagogisk tenkning og sammenheng. Variasjonen i studentenes deltakelse og orientering kan forsterke utfordringer med å planlegge god sammenheng mellom læringsaktiviteter og læringsutbytte. Sammenhengen mellom læringsaktiviteter og vurderingsformer utfordres, spesielt når det gjelder vurdering for sertifisering av læringsutbytte. I mange tilfeller vil den type oppgaver og aktiviteter som fremmer læring ikke være egnet for pålitelig sertifisering. For eksempel kan læringsfremmende oppgaver ta form av utforskende prosesser og analyser uten faste svar, mens sertifisering kan kreve kontrollerte omgivelser og testing av utvalgte kompetanser. Mens prinsippet om meningsskapende samsvar fremdeles gir viktige føringer, blir det sentralt å vurdere hvilke relasjoner som er viktig å avstemme når ikke alle hensyn kan ivaretas. Det blir viktigere å skille mellom de ulike formålene ved summativ vurdering når vurderingsform bestemmes, og hvilke relasjoner til andre elementer i studiedesignet som da er viktige å ivareta. For eksempel kan ulike vurderingsformer være egnet for, på den ene siden, å sikre et terskelnivå for å gå videre i et studieprogram, og på den andre siden, det å sertifisere kandidatenes kompetanse med henblikk på at de skal inn i en bestemt yrkesrolle.
7.3 Eksamensregelverk og KI-retningslinjer
Eksamensregelverket er hierarkisk organisert.19 Universitets- og høyskoleloven og universitets- og høyskoleforskriften gir helt grunnleggende føringer for gjennomføring av eksamen og fuskesaksbehandling, og dermed rammer for eksamensregelverket ved den enkelte institusjon. Hovedreglene på institusjonsnivå fastsettes i forskrift vedtatt av styret og er bindende for hele institusjonen. Denne gir de rettslige rammene for vurdering og sensur. På program- og fakultetsnivå suppleres forskriften av interne retningslinjer som tilpasser vurderingsordninger til faglig egenart. Den konkrete gjennomføringen skjer på emnenivå gjennom emnebeskrivelser som angir eventuelle arbeidskrav og vekting av delvurderinger, eksamensform og hvilke hjelpemidler som er tillatte.
Generative KI-systemer har utfordret fastsatte eksamensregler og retningslinjer om bruk av KI-systemer. Språkmodellbaserte KI-systemer kan produsere utkast til tekst og de kan gi forslag til litteratur, metoder, standpunkter og argumenter. De kan også gi tilbakemeldinger på og endringsforslag til egenproduserte tekstutkast – både på språk, struktur og innhold. Interaksjonen mellom studenten og samtaleroboten kan i varierende grad ha kjennetegnene til en dialog eller til en bestilling (Handa, Bent, et al., 2025).
Mangfoldet i bruksmetoder har skapt større gråsoner for flere eksamensregler, herunder grunnleggende regler som at kandidaten ikke skal presentere andres arbeid som sitt eget. Dersom et utkast til besvarelse går gjennom mange nok endringer foreslått eller foretatt av et KI-system, vil besvarelsen på et eller annet punkt opphøre å være studentens eget arbeid. Hvor den grensen går er imidlertid vanskelig å avgjøre. Muligens er visse KI-baserte forslag til standpunkter, begrunnelser, motforestillinger, argumentstruktur og språkforedling akseptable å ta inn hver for seg, men i sum kan de gjøre at besvarelsen ikke lenger kan regnes som studentens eget arbeid.
Et vedtak om fusk medfører annullering av eksamen og kan medføre utestengelse. Om ikke reglene og retningslinjene er klare nok, vil studenter kunne vegre seg for å benytte KI-systemer selv i tilfeller der bruken er tillatt og formålstjenlig, av frykt for å bli mistenkt for fusk. Tidligere har mange tatt til orde for nasjonale retningslinjer om KI-fusk og grader av tillatt KI-bruk på eksamener, med det formål å sikre likebehandling av vitnemål på tvers av institusjonene. Andre har vektlagt behovet for både lokale og faglige tilpasninger.
7.3.1 Utvalgets vurdering
Utvalget merker seg at universitetene og høyskolene arbeider aktivt med å utvikle sine eksamensregler og retningslinjer for bruk av KI.
Utvalget mener at institusjonene bør ha eierskap til sine eksamensregelverk og retningslinjer for bruk av KI-systemer, fremfor at dette gis nasjonalt. Institusjonene kan bedre ivareta faglig diversitet og organisatorisk utvikling, og tilpasse seg endrede behov raskere og bedre. Her legger utvalget vekt på at eksamensreglementer blir utformet i lys av institusjonenes ulike studieporteføljer. Institusjonene kan innenfor samme fagområde ha særegne program- og vurderingsstrukturer, og denne faglige diversiteten bør beholdes.
Samtidig støtter utvalget arbeidet med samordning som pågår i sektoren, styrket av erfaringsdeling og tilbakemeldinger fra studentene. Universitets- og høgskolerådet (UHR) vedtok i 2025 veiledende retningslinjer for fusk, med formål om å samordne institusjonenes praksis (jf. Dahle et al., 2025). Flere institusjoner har siden da fulgt opp disse anbefalingene. Utvalget oppfordrer, der det ansees som hensiktsmessig, til videre nasjonal samordning gjennom UHR.
Et velutformet eksamensregelverk gir studentene og institusjonene forutsigbarhet. Det bidrar til å ivareta studentenes rettssikkerhet, kvaliteten i studietilbudene og tilliten til institusjonen. Utvalget legger til grunn følgende forståelse av hva som kjennetegner et velutformet regelverk:
-
Formålstjenlighet: Eksamensreglene og retningslinjene bidrar til å gjøre det mulig å vurdere studentenes oppnådde læringsutbytte på en upartisk og faglig betryggende måte.
-
Klarhet: Reglene og retningslinjene er forståelige både for studentene som er bedt om å følge dem og for dem som skal vurdere om reglene har vært fulgt.
-
Etterprøvbarhet: Det er mulig å finne ut om reglene har vært fulgt.
-
Likhet: Reglene for den enkelte vurdering varierer ikke mer fra andre vurderinger enn hva som kan begrunnes med utgangspunkt i vurderingsform og hva slags kunnskap og ferdigheter studentene prøves i. Reglene varierer heller ikke uforholdsmessig mye mellom universiteter og høyskoler.
Utvalget vurderer formålstjenlighet som det viktigste og mest grunnleggende kriteriet, etterfulgt av klarhet og etterprøvbarhet. Likhet på tvers av emner, fag og institusjoner er en fordel, spesielt for studentene som kan bytte studier og som etter endt studium blir sammenliknet på tvers av institusjoner. Samtidig er det gode grunner for å ikke holde alt likt: For at regelverk skal fungere godt over tid er det hensiktsmessig med et lokalt handlingsrom for utprøving og forbedring.
De listede kriteriene må sees i sammenheng med vurderingsform. Mange regler, for eksempel om hvilke hjelpemidler som er tillatt, er etterprøvbare kun når eksamen blir gjennomført under tilsyn.
7.4 Vurdering av oppnådd læringsutbytte
7.4.1 Utfordringen med å vurdere oppnådd læringsutbytte
Eksamen skal være en prøving av hvor stort læringsutbytte studentene har oppnådd, i samsvar med læringsutbyttebeskrivelsene for det enkelte emne og den enkelte utdanning. Etter universitets- og høyskoleloven § 11-6 skal universiteter og høyskoler sørge for en faglig betryggende vurdering av studentenes kunnskaper og ferdigheter.
Utviklingen av store språkmodeller og annen generativ KI har skapt en grunnleggende utfordring for det å vurdere hva eksamenskandidater kan og vet. Samtaleroboter og agentiske systemer kan, på grunnlag av enkel instruksjon, produsere svært gode svar på mange oppgaver det er hensiktsmessig å gi studenter i høyere utdanning. Dette rammer oppgaver som ellers hadde gitt et godt grunnlag for å prøve de læringsutbyttene studentene skal utvikle.
Utfordringen med å vurdere oppnådd læringsutbytte foreligger også om man ser bort fra at KI-systemer kan generere fullstendige oppgavebesvarelser. Språkmodellbaserte KI-systemer kan bidra med alt fra grunnleggende ideer til hvordan en oppgave kan besvares, til å gi struktur på argumenter, produksjon av avsnitt, bearbeidelse av egenprodusert språk og innhold, og så videre. Får man ikke identifisert kandidatens bidrag til besvarelsen, får man ikke vurdert hva kandidaten kan og vet.
Generativ KI har gjort det vanskelig, om ikke umulig, å identifisere hva som har vært skapt av et menneske og hva som har vært skapt av en maskin. Markører for KI-generert tekst – f.eks. skrivestil eller hallusinerte referanser – er feilbarlige, utilstrekkelige og blir mindre pålitelige i takt med teknologiutviklingen. Menneskers evne til å identifisere KI-generert innhold er ofte ikke bedre enn tilfeldig, spesielt når det kommer til vitenskapelige tekster (Chein et al., 2024; Scarfe et al., 2024; Schneider et al., 2025). KI-systemer kan brukes til å bearbeide menneskeskapt innhold, noe som gjør det mer komplisert å trekke et enkelt skille mellom KI-genererte og menneskeskapte deler av en besvarelse. Motsatt vei kan KI-genererte forslag omarbeides både maskinelt og manuelt (Schneider et al., 2025).
Så sant generative KI-systemer har vært tilgjengelig for bruk under gjennomføring av eksamen, uten tilsyn, er det i sum svært vanskelig for sensor å identifisere hva som er bidragene til kandidaten og hva som er bidragene til et KI-system. Generative KI-systemer har slik sett forsterket den logiske avstand mellom kvaliteten på en besvarelse og hva besvarelsen sier om kandidatens kunnskap og ferdigheter.
Utfordringen med å vurdere oppnådd læringsutbytte må ikke forstås for snevert, det vil si utelukkende som en utfordring med fusk. Hvorvidt en student har fusket avhenger av hvilke regler som gjelder for den enkelte eksamen. Så sant bruk av KI-systemer ikke er forbudt eller svært strengt regulert, kan en students bruk av KI-systemer utgjøre en vesentlig feilkilde til sensorens vurdering av oppnådd læringsutbytte, samtidig som bruken er i samsvar med eksamensreglene.
Utfordringen med fusk på hjemmeeksamener er ikke ny av art. Mye av det man kan få til med KI-systemer, om man er innstilt på å oppnå uærlige resultater, var allerede mulig med tilgang på andres hjelp eller arbeider. Endringen er likevel vesentlig: Det er enklere, raskere og rimelig å bruke KI-systemer, og risikoen for sosiale og formelle sanksjoner er lavere. Studenten behøver heller ikke å ha en intensjon om å fuske. I en kompleks interaksjon med en samtalerobot kan det være krevende å vurdere nøyaktig hvilke eller hvor mange bidrag fra KI-systemet som er innenfor gjeldende regler (se kap. 7.3). Også om vi ser bort fra fuskeproblematikken har hjelp fra andre vært en feilkilde i vurdering av oppnådd læringsutbytte ved hjemmeeksamener, og KI-systemer har forsterket denne feilkilden.
Utfordringen KI har skapt for vurdering av oppnådd læringsutbytte har flere konsekvenser:
-
Studentene kan få ufortjent gode eller ufortjent dårlige resultater. I tillegg til at den enkelte kan bli uriktig vurdert, kan dette gi opphav til urettferdige sammenlikninger av studentenes resultater.
-
Mangfoldet i bruksmetoder gjør at studenter kan bli mistenkt for fusk også når de har brukt KI-systemer i samsvar med institusjonenes føringer. Dette utfordrer studentenes rettssikkerhet.
-
Ved mistanke om fusk må fuskesaksbehandlere, nemnder og domstoler vurdere om eksamensreglene har blitt brutt, opp mot et beviskrav om sannsynlighetsovervekt eller klar sannsynlighetsovervekt. Studentenes rettsikkerhet står sentralt. Motsatt vei er det problematisk om det er umulig å bekrefte brudd på grunnleggende eksamensregler.
-
Til slutt har utfordringen konsekvenser for alle dem som skal dra nytte av informasjonen et vitnemål gir. I ytterste konsekvens rammer dette tilliten til universiteter og høyskoler og verdien av høyere utdanning.
7.4.2 Utvalgets vurdering
Kandidaters tilgang på generative KI-systemer under gjennomføring av eksamen kan gjøre det svært vanskelig å vurdere oppnådd læringsutbytte i henhold til universitets- og høyskoleloven § 11-6, og å vurdere etterlevelse av eksamensregelverk. Sensor må kunne vite hva kandidatens bidrag til besvarelsen er, for å vurdere hva kandidaten kan og vet.
Utfordringen kan i ytterste konsekvens undergrave tilliten til vitnemål fra høyere utdanningsinstitusjoner. Samtidig påvirker det læringsprosessen negativt: Når man kan oppnå gode resultater uten å ha tilegnet seg de ferdighetene og den kunnskapen man skal prøves i, svekker det læringsinsentivet.
Utvalget vurderer at det ikke er universitets- og høyskolelovens bestemmelse om faglig betryggende vurdering som er kilden til problemet, og heller ikke de lokale eksamensreglene. Universitets- og høyskoleloven stiller et grunnleggende og rimelig krav til gjennomføring av eksamen. Utvalget mener at tydeligere og bedre eksamensregler heller ikke alene kunne løse problemet: Det er ikke mulig å lage eksamensregler som det både er mulig å vurdere etterlevelse av ved ikke-kontrollerte eksamener, og som samtidig tjener funksjonen med å sikre en upartisk og faglig betryggende vurdering (se kap. 7.3).
Utvalget mener at institusjonenes ansvar for å sørge for en faglig betryggende vurdering, fordrer at alle eksamener må gjennomgås for å sikre at oppnådd læringsutbytte kan bli vurdert. For noen eksamener kan det være mest hensiktsmessig, både for læringsprosessen og i lys av læringsutbytte, at KI-systemer ikke er tillatt som hjelpemiddel. For andre kan utstrakt bruk av KI-systemer være egnet, så sant man har en metode for å vurdere læringsutbyttet på en pålitelig måte. Dette må vurderes opp mot studieemnets og -programmets læringsutbytte og fagets arbeidsmetoder.
Utvalget har vurdert hvilke tiltak som kan bidra til å løse utfordringen. Tiltakene blir beskrevet og vurdert i det følgende.
7.4.2.1 Kontrollerte eksamensformer
Utfordringen oppstår når universitetene og høyskolene ikke fører tilsyn med gjennomføring av eksamen. Under kontrollerte omstendigheter – som ved skriftlig skoleeksamen, muntlig eksamen og praktiske prøver – kan man sørge for at det ikke er tilgang på ikke-tillatte hjelpemidler, eller at det er tilsyn med hvordan tillatte hjelpemidler blir brukt. Dette gjør det mulig å sikre en faglig betryggende vurdering av studentenes læringsutbytte. Studentene kan også få sterkere læringsinsentiver når de vet at de ikke kan lene seg på bidragene til et KI-system.
Tiden man kan bruke i et kontrollert eksamensmiljø begrenser hva slags kunnskap og hvilke ferdigheter man kan prøve. En skoleeksamen er f.eks. ikke like egnet til å prøve studentenes ferdigheter til å utvikle gjennomarbeidede, velstrukturerte argumenter eller å planlegge og gjennomføre egne undersøkelser etter akademiske standarder.
Det å sikre en faglig betryggende vurdering av studentenes læringsutbytte er vesentlig for høyere utdanning og tilliten til studentenes kompetanse. Å sette av ressurser til dette bør derfor være en høy prioritet både for institusjonene og sentrale myndigheter. Dersom institusjonenes arealmessige kapasitet til å holde fysiske eksamener på campus blir uttømt, vil det blant annet være behov for å investere i infrastruktur.
Utvalget vil understreke at det er fullt mulig og i flere tilfeller ønskelig å stille KI-systemer til disposisjon som hjelpemidler under kontrollerte eksamener, f.eks. om man ønsker å prøve ferdigheter i bruk av store språkmodeller til å løse fagrelevante problemer. Gjennom brukslogg kan det være mulig for sensor å se hvordan verktøyet har vært brukt, og man kan gi studentene i oppgave å begrunne eller reflektere over egen bruk.
Utvalget mener at praksisen med utstrakt bruk av hjemmeeksamen ikke lenger er forsvarlig (jf. Figur 7.1). Ved å gjennomføre eksamen under tilsyn kan universiteter og høyskoler sørge for en faglig betryggende vurdering av hva kandidater kan og vet. Mange institusjoner jobber med å øke bruken av kontrollerte eksamensformer. Utvalget mener at universiteter og høyskoler bør gjøre større bruk av kontrollerte eksamensformer, og at ikke-kontrollerte eksamensformer suppleres med en kontrollert del (se 7.4.2.2).
Programmeringseksamen uten programmering, ved Høgskolen i ØstfoldInformatikkemnene «Algoritmer og datastrukturer» og «Innføring i operativsystemer» er blant de mest programmeringstunge i IT-studiet ved Høgskolen i Østfold. De gir studentene både praktiske ferdigheter og teoretisk forståelse på et høyt abstraksjonsnivå, noe som krever omfattende programmeringsarbeid.De siste årene er undervisningen lagt om for å fremme mer selvstendig læring. Tradisjonelle forelesninger er erstattet av digitale videomoduler kombinert med frivillige og obligatoriske programmeringsoppgaver. Oppgavene vurderes uten karakter, og det gjennomføres ingen systematisk kontroll for juks eller bruk av KI-systemer – ansvaret for læring ligger hos studentene selv.Avsluttende eksamen består av rene flervalgsoppgaver. Oppgavene krever ikke skriving av hverken programkode eller tekst, men tester studentenes evne til å forstå, analysere og vurdere ferdigskrevet kode. Formatet gjør det mulig å dekke et bredt spekter av pensum og gir rask og effektiv sensur. Foreløpige resultater viser ingen vesentlige endringer i karakterfordelingen etter omleggingen, og studentenes tilbakemeldinger har vært stabile.Kilde: Informasjon til utvalget fra Østfold AI Hub v/førsteamanuensis Harald Holone
7.4.2.2 Supplering av ikke-kontrollerte eksamener med en kontrollert eksamensdel
Ved å supplere ikke-kontrollerte eksamener med en kontrollert eksamensdel kan studenter prøves i alle typer læringsutbytte, også de som utvikles og vises gjennom arbeid som pågår over lang tid, uten at det går på bekostning av vurderingens integritet. Det vil også kunne insentivere til mer læringsfremmende bruk av generative KI-systemer i arbeid med oppgaver dersom kandidatene vet at de i tillegg vil bli testet under kontrollerte omstendigheter. Vurderingene som gis her gjelder også større, selvstendige arbeider, som masteroppgaver. Kapittel 7.5 gir en utfyllende vurdering av større, selvstendige arbeider.
Å kombinere innlevert skriftlig arbeid med muntlig eksamen gjøres allerede i stor grad, f.eks. etter innlevert masteroppgave, men det kan brukes på flere studieemner. Den kontrollerte eksamenen som supplerer en ikke-kontrollert eksamen kan ha et hvilket som helst format: Den behøver ikke å være muntlig, med ressursene det krever av institusjonen. F.eks. kan sensor, eventuelt med hjelp av KI-systemer, lage individuelle eksamensoppgaver ved lesning av innleverte besvarelser – lik spørsmålene man kan stille ved muntlig forsvar – som skal besvares på en skriftlig skoleeksamen (se kapittel 7.10).
For at et slikt grep skal tjene hensikten med å gi en samlet sett faglig betryggende vurdering, er det nødvendig at den kontrollerte eksamensdelen gis betydelig vekt og ikke bare justerer en karakter som er satt på forhånd. Den kontrollerte eksamensdelen må informere sensorenes vurdering av hvor stort læringsutbytte studenten viser gjennom den ikke-kontrollerte eksamensdelen, og slik legge grunnlaget for en samlet vurdering.
Det å innføre en kontrollert vurdering som supplement kan kreve ytterligere ressurser til gjennomføring av eksamen og sensur. Høyere kostnad er en ulempe i seg selv. Samtidig er det svært uheldig om kostnad i for stor grad påvirker beslutninger om eksamensform. Eksamensformer som fremmer og prøver ønskede læringsutbytter på faglig betryggende vis er en helt vesentlig del av studiekvaliteten. Utvalget kan ikke se at det er gode veier utenom å akseptere at generative KI-systemer har gjort vurdering mer ressurskrevende. Hvor stort ressursbehovet blir, vil variere. Ressurser kan for eksempel frigjøres ved å redusere omfanget av det skriftlige arbeidet eller organisere den muntlige prøvingen mer effektivt. For en god del emner vil det likevel kreves ekstra ressurser.
Utvalgets anbefaling om å supplere ikke-kontrollerte eksamener med en kontrollert eksamensdel vil i praksis føre til flere kombinasjonseksamener. Dette blir diskutert i kapittel 7.6.
Boks 7.1 Utprøving av nye eksamensformer ved Handelshøyskolen BI
Må vi velge mellom integritet og autentisitet i vurdering? En retur til tradisjonelle, kontrollerte eksamensformer kan gå ut over muligheten til å prøve studentene i kompetanser som vil være sentrale i deres fremtidige arbeidsliv, slik som å utvikle fagspesifikk KI-kompetanse.
Med dette som utgangspunkt prøver læringssenteret ved Handelshøyskolen BI ut et redesign av eksamen gjennom tre komplementære grep:
-
En «akademisk teoriprøve» i form av en midtveiseksamen i kontrollert miljø uten hjelpemidler, for å teste grunnleggende faglig forståelse.
-
10 minutters muntlig forsvar av hjemmeeksamen på video for et utvalg studenter, der sjansen for å bli plukket ut skal bidra til etterlevelse i hele studentkullet.1
-
Prosessbasert vurdering som flytter fokus fra sluttresultatet til selve læringsprosessen, gjennom studentenes samhandling med et spesialisert KI-system, integrert i læringsplattformen.
Ved å dele opp vurderingen i tre funksjoner – kunnskapstesting, verifisering av forfatterskap og vurdering av ferdigheter – er målet å opprettholde integriteten i vurderingen samtidig som studentene rustes for et arbeidsliv preget av KI.
1 Utvalget vil ikke anbefale hjemmeeksamen på video, som antageligvis ikke er en tilstrekkelig kontrollert eksamen på grunn av tilgang til KI-systemer. I tillegg har vurderingsformen mange likhetstrekk med tilsyn på digitale hjemmeeksamener, og utfordringer knyttet til personvern og manglende juridisk grunnlag, se kap. 7.4.2.4).
Kilde: Landfald (2026)
7.4.2.3 KI-robuste eksamensoppgaver
Alle kjente KI-systemer har begrenset kapabilitet. Det kan være mulig å gi oppgaver som det ikke er mulig å svare på, selv med tilgang på avanserte KI-systemer, uten samtidig å demonstrere oppnådd læringsutbytte. Det kan f.eks. dreie seg om kasusoppgaver som krever en forståelse av kontekst som tilgjengelige KI-systemer mangler.
En slik strategi har vært velbegrunnet i den første fasen med generativ KI, men utvalget ser store nok ulemper med strategien til at det ikke vil anbefale å forfølge den fremover.
Det er svært uforutsigbart hva både dagens og fremtidige KI-systemer ikke vil kunne få til (jf. beskrivelsen av den ujevne utviklingsfronten av KI i kapittel 3). Som en konsekvens av at KI-modellene blir mer kapable over tid, kan man ikke stole på at en KI-robust oppgave gitt høsten 2026 vil holde seg KI-robust. Siden modellene blir mer kapable, blir det også stadig færre KI-robuste oppgaver å gi, med den konsekvens at det blir færre typer læringsutbytte man kan prøve med en slik tilnærming. Det er etter utvalgets mening ikke hensiktsmessig å begrense hva man skal lære i høyere utdanning til den kunnskapen og de ferdighetene som skal til for å løse oppgaver som KI-systemer ikke er i stand til å løse (se kapittel 5 og 6). Eksamen bør heller ikke begrenses til en øvelse i å gi gode instruksjoner til KI-modeller (herunder å gi modellen tilstrekkelig kontekst).
7.4.2.4 Tilsyn på digitale hjemmeeksamener
Med tekniske hjelpemidler kan det være mulig å gjøre hjemmeeksamen til en kontrollert eksamensform, og dermed en løsning på utfordringen. Såkalt e-proctoring har blant annet blitt utbredt i USA, spesielt siden covid-19-pandemien. Dette innebærer skjermovervåkning og videoovervåkning av studenten med kamera og mikrofon. Tilsynet kan gjennomføres av mennesker, i sanntid eller i etterkant basert på videoopptak, eventuelt kun ved mistanke om fusk. I noen programvarer er det i tillegg integrerte KI-systemer for å analysere videomaterialet og flagge avvik. Som forklart nedenfor, vurderer utvalget at tilsyn med digital hjemmeeksamen ikke er tilstrekkelig hjemlet i dagens regelverk. Utvalget har vurdert om det bør hjemles.
Det taler for en hjemmel at ordningen ikke krever fysisk oppmøte og fysisk infrastruktur, slik skoleeksamen gjør. Dette har spesielt stor betydning for nett- og samlingsbaserte studier. Der vil det være mer ressurskrevende å bytte ut hjemmeeksamen med skoleeksamen, både for studenten og institusjonen, noe som gjør det til et relativt sett mer attraktivt alternativ for begge parter.
Det taler mot en hjemmel at det er belastende for mange studenter å bli overvåket i eget hjem, noe som kan påvirke eksamensprestasjoner, og at det innebærer innsamling av mye, potensielt sensitiv data som må håndteres sikkert. Det er også problematisk at løsningen kan være både teknisk og praktisk feilbarlig: Løsningen er sårbar for programvare som overstyrer kamera eller skjermovervåkning, og det vil være områder som ikke fanges opp på kamera.
Studenter som ikke har tilgang til et eget, skjermet rom – eller som bor sammen med venner eller familie – kan oppleve tilsynet som særlig inngripende. For dem kan overvåkning og innsyn i hjemmet ikke bare krenke eget personvern, men også tredjepersoners privatliv. Andre studenter kan enklere akseptere tilsyn i en avveining mellom personvern og fleksibilitet, der muligheten til å gjennomføre eksamen hjemmefra oppveier for ulempene (Nicola-Richmond et al., 2024).
I EØS er tilsyn på digitale hjemmeeksamener sterkt regulert av personvernregelverket, siden det er en inngripende form for kontroll.20 Universiteter og høyskoler kan etter uhl. § 2-8 behandle studenters personopplysninger når det er nødvendig for å utføre deres oppgaver etter loven. Siden institusjonen kan unngå et slikt inngrep gjennom andre vurderingsformer, er ikke tiltaket etter utvalgets vurdering strengt nødvendig for å utføre institusjonens oppgaver.
I tillegg er det et generelt krav om at jo mer inngripende tiltaket er, desto tydeligere må lovhjemmelen være. Siden tilsyn av studenter er et inngripende tiltak i studenters privatliv, er den overordnede hjemmelen i uhl. § 2-8 for lite tydelig og spesifikk til å hjemle et slikt tiltak. Etter utvalgets vurdering kreves det derfor en ny lovhjemmel som oppfyller kravene etter personvernforordningen (GDPR) art. 6.
Datatilsynet fattet 28. oktober 2026 (en uke før trykk av denne NOU-en) vedtak om å avslutte en sak om tilsyn på digitale hjemmeeksamener. Datatilsynet konkluderte med at løsningen var i tråd med personopplysningsloven og -forordningen, uten nærmere begrunnelse. Saken viser at det kan være mulig å hjemle slikt tilsyn i uhl. § 2-8. Utvalget har ikke gjort nye vurderinger i lys av dette vedtaket.
Et slik inngrep i studentenes personvern kan heller ikke hjemles ved å innhente samtykke fra studentene (Giannopoulou et al., 2023). For at samtykket skal være gyldig, må det være gitt frivillig. Dette er vanskelig å oppnå all den tid studenten og institusjonen står i et ujevnt maktforhold, og studenten kan ha begrunnet frykt for negative konsekvenser dersom hen ikke samtykker. Dersom et behandlingsgrunnlag for tilsyn av digitale hjemmeeksamener var på plass, er det fortsatt et veldig begrenset handlingsrom etter andre regler i GDPR (se vedlegg 2).
Utvalget vurderer at tilsyn på digitale hjemmeeksamener er en form for overvåkning som er svært inngripende i studentenes privatliv, og byr på omfattende etiske og juridiske problemer. Tiltaket utfordrer sentrale prinsipper om personvern og forholdsmessighet.
Utvalget fraråder derfor tilsyn på digitale hjemmeeksamener og anbefaler ikke at det utredes en særskilt lovhjemmel for et slikt tiltak. Utvalget anbefaler i tillegg at sentrale myndigheter og institusjonene samarbeider om å møte behovet for eksamenslokaler for fleksible studietilbud.
7.4.2.5 KI-deteksjon
Som et svar på utfordringen med å skille menneskeskapt fra maskingenerert innhold, er det blitt utviklet verktøy med mål om å gjenkjenne tekst skapt av KI-systemer. Slike KI-detektorer bruker maskinlæringsteknikker til å finne mønstre som skiller KI-generert innhold fra menneskeskapt innhold.21 De er dermed ment å fylle en lignende funksjon som ordinære plagiatkontrollverktøy, og kunne vært brukt av sensorer for å identifisere mulige fuskesaker.
Det er store kvalitetsforskjeller mellom KI-deteksjonsverktøy. Det verktøyet som i dag vurderes som mest pålitelig, Pangram, har vist seg å gi gode resultater for kategoriene KI-generert tekst, hybrid KI- og menneskeskapt tekst, «menneskeliggjort» KI-tekst, og rent menneskeskrevet tekst (Van Vlasselaer et al., 2026). Samtidig er et av de sentrale målene til KI-utviklere å lage modeller som kan brukes til å generere tekst og tale som ikke kan skilles fra naturlig språk, og også Pangrams resultater er mindre pålitelige når det lanseres nye språkmodeller. I et teknologikappløp hvor modellene blir stadig bedre, er KI-detektorer dømt til å løpe etter.
Selv med gode deteksjonsverktøy – og få falske positiver – gjenstår grunnutfordringen. Det forblir vanskelig å skille en students og et KI-systems intellektuelle bidrag til et produkt. Det gjenstår også andre problemer: Legitim bruk av KI-systemer, f.eks. til bearbeidelse av språk innenfor gjeldende eksamensregelverk, kan gi utslag uten at det foreligger fusk. Samtidig kan menneskelig omskriving skjule bruken. Det gjør KI-deteksjonsverktøy dårlig egnet til et verktøy for vurdering av fusk.
I tillegg peker utvalget på at KI-deteksjonsverktøy er forbundet med vesentlige tekniske, metodiske og juridiske utfordringer. Dette gjelder manglende transparens i verktøyenes virkemåte, samt rettssikkerhets- og personvernhensyn. Etter utvalgets vurdering innebærer disse forholdene samlet sett at KI-deteksjonsverktøy ikke er egnet til å ivareta behovet for kontroll ved vurdering av studentenes oppnådde læringsutbytte. For en vurdering av de juridiske rammene som gjelder ved KI-deteksjon, se vedlegg 3.
7.5 Større, selvstendige arbeider
Universitets- og høyskoleforskriften § 2-9 definerer «selvstendige arbeider» på mastergradsnivå som «en masteroppgave eller tilsvarende større arbeid, blant annet kunstnerisk eller teknologisk produkt. Det selvstendige arbeidet skal vise forståelse, refleksjon og modning.» Slike oppgaver har vært en viktig del av høyere utdanning over lang tid. Samtidig er de, på lik linje med andre ikke-kontrollerte eksamener, utsatt for utfordringen med å vurdere oppnådd læringsutbytte (jf. kap. 7.4).
Universitets- og høyskoleloven (§ 11-7) fastsetter at det skal være to sensorer, hvorav minst én ekstern, ved sensur av selvstendige arbeider i høyere grad, og at det skal være to sensorer ved sensur av bacheloroppgaver og liknende selvstendig arbeid på lavere grad.22 Universitets- og høyskoleforskriften §§ 2-6 til 2-8 setter minimumsgrenser på 30 studiepoengs omfang for selvstendig arbeid i mastergrader, og 20 studiepoeng for integrerte mastergrader. Ellers fastsetter institusjonen nærmere regler om det selvstendige arbeidet.
Under arbeidet med større, selvstendige arbeider er det vanlig at studenten får veiledning. Veiledningen styrker det formative aspektet i disse vurderingsformene. Veileder kan for eksempel gi studenten tilbakemeldinger på påbegynt arbeid, diskutere krevende problemstillinger og foreslå spor å forfølge i videre arbeid.
Veilederrollen er ikke regulert nasjonalt, heller ikke hvilken rolle veileder skal ha i forbindelse med sensur, utover det som følger av kravet om to sensorer ved selvstendig arbeid og det grunnleggende kravet om upartisk vurdering (uhl. §§ 11-6 og 11-7).
7.5.1 Utvalgets vurdering
Å gjennomføre et større, selvstendig arbeid er i mange fag en sentral læringsaktivitet for å oppnå målene om faglig kvalitet, samfunns- og arbeidslivsrelevans og dannelse (jf. kap. 5.2). Å jobbe med en oppgave over tid gjør blant annet at man kan utvikle evner til å tenke kreativt, metodisk og kritisk, til å utvikle gjennomarbeidede argumenter og dyp faglig innsikt. Masteroppgaven kan tjene som en avsluttende prøve som binder sammen de ulike formene for læringsutbytte studenten har opparbeidet seg gjennom utdanningen, herunder metode- og fagkunnskap, og ferdigheter i kritisk og kreativ tenkning. Slike oppgaver gjorde også, før generativ KI, at man fikk vurdert oppnåelsen av det sammensatte læringsutbyttet. Hensynene til både læring og sertifisering tilsier derfor at slike arbeids- og vurderingsformer spiller en viktig rolle i høyere utdanning.
Samtidig endrer tilgangen på generative KI-systemer på premissene for større selvstendige arbeider, både med hensyn til læring og til sertifisering. Når det gjelder utfordringen med å vurdere oppnådd læringsutbytte, er den like stor for disse som for hjemmeeksamener og ordinære semesteroppgaver. Samtidig står det mer på spill når en oppgave skal gi 20, 30, 45 eller 60 studiepoeng og, i masteroppgavens tilfelle, tjene som en avsluttende prøve av studentenes faglige kyndighet.
I tråd med argumentene i kapittel 6, har generative KI-systemer en flertydig påvirkning på læringsgevinsten av større, selvstendige arbeid: Uten god selvregulering og bevissthet om hvordan man bruker KI-systemer, er det en risiko for å hoppe bukk over vesentlige ledd i læringen. Denne risikoen øker videre med den voksende bruken av agentiske KI-systemer. Samtidig finnes det gode muligheter for å løfte læringsutbyttet ved hjelp av KI-systemer, og det kan være mulig for studentene å løse nye typer problemer, eventuelt mer avanserte, med KI-systemer som hjelpemidler.
Det varierer mellom fagene i høyere utdanning hvor sentral rolle de større, selvstendige arbeidene spiller. Dette gjenspeiles i variasjonen som allerede finnes i masteroppgavens omfang, fra 20 studiepoeng til 60 eller mer. For noen utdanninger kan det være problematisk at universitets- og høyskoleforskriften (§§ 2-6 til 2-8) fastsetter krav til minimum omfang av selvstendig arbeid i mastergrader. Med utgangspunktet i dette har utvalget vurdert hvorvidt kravene bør bestå eller endres.
Det fremste argumentet for å fjerne kravene er at det åpner et større handlingsrom for institusjonene. For noen utdanninger kan det tenkes at det ønskede læringsutbyttet bedre utvikles og prøves gjennom flere emner, enn gjennom et stort, selvstendig arbeid. Dette poenget støttes av at generative KI-systemer har gjort det langt vanskeligere å vurdere oppnådd læringsutbytte ved ikke-kontrollerte vurderingsformer, samtidig som studentenes bruk av generative KI-systemer kan hemme læringsgevinsten av aktiviteten.
Det fremste argumentet for å beholde kravene er at selvstendig arbeid med store oppgaver fungerer som en prøving av hele det sammensatte læringsutbyttet høyere utdanningstilbud er ment å gi. Studentene får mulighet til å vise dyp fagkunnskap, at de kan tenke selvstendig og analytisk, og at de behersker fagets metoder og begrepsrepertoar. Utvalget anser det som mer ønskelig å løse utfordringene KI reiser for læring og vurdering, enn å unngå dem.
Et annet problematisk aspekt ved å fjerne kravene, er at de er med på å sikre mastergradens funksjon som opptaksgrunnlag for doktorgradsutdanning, i Norge og i utlandet (jf. universitets- og høyskoleforskriften § 2-6, sjette ledd). Fjernes kravene, vil ikke mastergraden nødvendigvis være tilstrekkelig som opptaksgrunnlag.
På grunnlag av en samlet vurdering av de nevnte hensynene har utvalget konkludert med at kravene til omfang av selvstendig arbeid bør bestå. Utvalget mener at utfordringene generative KI-systemer skaper for vurdering av studentenes selvstendige arbeid bør løses gjennom en grundig, kontrollert prøving som et supplement til det selvstendige arbeidet. Det bør da gjøres en samlet vurdering av hvilket læringsutbytte kandidaten viser, altså ikke bare en vurdering av om studentens karakter bør justeres et hakk opp eller ned (jf. kap. 7.6). Dessuten kan det finnes andre måter å håndtere KI-utfordringene på. Regelverkets krav om et selvstendig arbeid betyr ikke at det må være én sammenhengende avhandling. Kravet kan oppfylles på flere måter.
Veileders rolle
Veileders rolle er sentral i den formative vurderingen av større, selvstendige arbeider. Med utgangspunkt i utfordringen med å vurdere oppnådd læringsutbytte, har utvalget diskutert om veileder bør ha en rolle også i den summative vurderingen. Utvalget legger til grunn at hensynet bak kravet om ekstern sensor er kvalitetssikring og ivaretakelse av studentenes rettigheter. Veileder vil ofte ha kunnskap om prosessen som har ledet frem til det innleverte arbeidet. Det kan gi et større innblikk i graden av selvstendighet som studenten har utvist, noe som både kan være nedfelt som et krav i eksamensregelverket og fungere som et vurderingskriterium (jf. kap. 7.3).
Universitets- og høyskoleloven § 11-6 fastsetter to grunnleggende hensyn: Vurderingen skal være både upartisk og faglig betryggende. For spørsmålet om veileders rolle i sensur, kan disse hensynene komme i spenning. Gis veileder en avgjørende rolle i sensuren, kan dette ha nytte for å vurdere hvor selvstendig kandidatens arbeid har vært. På den annen side kan det være problematisk med henblikk på vurderingens upartiskhet, og det kan øke en allerede ujevn maktbalanse mellom veileder og student. Videre kan det ha en nedkjølingseffekt på relasjonen mellom veileder og student, i det som skal være et åpent rom for faglig diskusjon, uenighet, nysgjerrighet og utprøving. Utvalget har ikke konkludert om veileder kan gis en sterkere rolle i sensur.
7.6 Kombinasjonseksamener
Utvalgets vurdering om at ikke-kontrollerte eksamener bør suppleres med en kontrollert eksamensdel (jf. kap. 7.4.2.2) vil nødvendigvis føre til flere kombinasjonseksamener: Som oftest handler det om at en (skriftlig) hjemmeeksamen eller semesteroppgave blir supplert med en (muntlig) kontrollert eksamensdel.23
En supplerende muntlig eksamen har som hovedformål å vurdere i hvilken grad studenten har oppnådd læringsutbyttet, og skal ikke tjene som ren kontroll av hvorvidt eksamensreglene har vært fulgt på en skriftlig deleksamen. Utgangspunktet er at utvalget mener at semesteroppgaver, lengre hjemmeeksamener, og da spesielt større selvstendige arbeider, kan tjene viktige utdanningsfaglige mål, men at de ikke alene gir en god prøving av hvilket læringsutbytte studenten har oppnådd (jf. kap. 7.5). I denne sammenhengen ser utvalget behov for å vurdere gjennomføring av og rettigheter ved kombinasjonseksamener.
Dersom en kontrollert eksamensdel avdekker at studenten ikke har oppnådd læringsutbyttet slik det framsto i den ikke-kontrollerte delen, er det to muligheter:
-
Det foreligger mistanke om bruk av KI-systemer i strid med eksamensreglementet, såkalt KI-fusk. Studenten har enten forsettlig forsøkt å fuske, eller har forsettlig/grovt uaktsomt fusket. Dersom dette kan bevises med sannsynlighetsovervekt, kan det føre til annullering av eksamen, jf. uhl. § 12-4.
-
Studenten har ikke i tilstrekkelig grad oppfylt krav til selvstendighet, som for de fleste emnene er et vurderingskriterium. I en samlet vurdering medfører dette at karakteren settes ned.
Utvalget mener at kun fuskesaker må behandles som fuskesaker, fordi studenter da har krav på rettsvern. Samtidig er bruk av KI-systemer utover det som er tillatt i eksamensreglementet og reglene for den konkrete eksamen, ikke nødvendigvis svart-hvitt: Det finnes et spekter av gråsoner, og det foreligger ikke nødvendigvis forsett eller grov uaksomhet. I disse gråsonene kan graden av selvstendighet som studenten (ikke) viser, komme i spill, og dermed også hvilken karakter som er riktig å fastsette. Da er det desto viktigere at studenten har en reell klagemulighet.
7.6.1 Utvalgets vurdering
Klage på den muntlige delen av en kombinasjonseksamen
I denne konteksten kan det være utfordrende at dagens regler inneholder ulike sensorordninger, klageordninger og fremgangsmåter for å be om karakterbegrunnelse (universitets- og høyskoleloven §§ 11-7 til 11-11):
-
Ved en ikke-etterprøvbar eksamen, for eksempel muntlig eksamen, skal det være to sensorer, og da er det ikke klagerett på karakter (bare på formelle feil).
-
Ved en etterprøvbar eksamen, for eksempel skriftlig, skal det være minst én sensor og full klagerett. Det skal være to sensorer ved sensur av større, selvstendige arbeider, og ved eksamener som alene utgjør 15 studiepoeng eller mer.
-
Ved kombinasjonseksamener kan studenten kun påklage den skriftlige delen, selv om karakteren er basert på både den skriftlige og muntlige delen (ved noen institusjoner settes to delkarakterer, men det samme gjelder). Dersom karakteren på den skriftlige eksamensdelen endres ved klagesensur, må institusjonen i tillegg avholde en ny muntlig eksamen for å fastsette endelig karakter.
Tradisjonelt har kombinasjonseksamener, der et skriftlig arbeid suppleres med muntlig utspørring, blitt brukt for å kunne justere karakteren én karakter opp eller ned. Dette er ikke lenger tilstrekkelig når ikke-kontrollerte eksamener trenger å bli supplert med en kontrollert eksamensdel for å gi en faglig betryggende vurdering. Utvalget legger derfor til grunn at en supplerende, kontrollert eksamensdel bør kunne påvirke karakteren i større grad, uten begrensning på antall karakterer, i en samlet vurdering av hvilket læringsutbytte studenten viser gjennom de to eksamensdelene. Det kan slå ut både negativt og positivt for studentene.
Når en supplerende muntlig eksamen får større innvirkning på den samlede karaktersettingen, og den skriftlige delen ikke alene er representativ for hvilket læringsutbytte studenten viser, mener utvalget at det er utilstrekkelig at studenten bare kan påklage den skriftlige delen og ikke den muntlige. Dette har spesielt stor betydning for både studenter og institusjonene ved vurdering i større emner, slik som bachelor- og masteroppgaver.
Utvalget mener at dagens regulering i uhl. § 11-11 fjerde ledd om kombinasjonseksamener ikke løser denne konkrete problemstillingen på en effektiv eller rettferdig måte. Regelen sikrer at studenten får en ny muntlig eksamen dersom karakteren er endret etter klagebehandling av den skriftlige delen. Det fører til at studenten får en ny mulighet til å forberede seg på å bevise oppnådd læringsutbytte. I lys av den skisserte utfordringen, fremstår regelen ikke som en tilfredsstillende løsning: Klagebehandling av kun den skriftlige delen er ikke lenger formålstjenlig. Det er heller ikke rettferdig overfor studenter som har levert skriftlig arbeid og som kan vise at de har oppnådd læringsutbyttet. Det kan i tillegg skape unødig merarbeid for institusjonene med flere muntlige eksamensdeler i flere runder. Regelen i uhl. § 11-11 fjerde ledd er spesielt problematisk for større, selvstendige arbeider (master- og bacheloroppgaver) og eksamener som utgjør 15 studiepoeng eller mer.24
Gjøre muntlige eksamener etterprøvbare med lyd- eller videoopptak
Utvalget mener at institusjonene bør løse kombinasjonseksamener annerledes, nærmere bestemt ved å gjøre den muntlige delen etterprøvbar. Dette kan fortrinnsvis gjøres gjennom lyd- eller videoopptak. Det vil gi en samlet klagerett på begge eksamensdelene, og sikre studentenes rettssikkerhet. Det er nødvendig når den muntlige eksamensdelen blir like viktig for den samlede karakteren. Klagebehandlingen vil da være helhetlig, formålstjenlig og mer effektiv og rettferdig. Den vil heller ikke kunne misbrukes for å få en ny mulighet til muntlig eksamen, slik det er mulig i dag.
Det har i NOU 2020: 3 (pkt. 21.5.2.3.3) Ny lov om universiteter og høyskoler blitt vurdert å legge til rette for videoopptak av muntlige eksamener. Utvalget for ny universitets- og høyskolelov konkluderte på det tidspunktet, basert på en anbefaling fra Deloitte, å ikke innføre en plikt for institusjonene til å tilby filming av muntlig eller utøvende eksamen i tilfeller der studenten ønsker det, men heller gjeninnføre krav om to sensorer på ikke-etterprøvbare eksamener – slik det er krav om i dag.25 Hensynene var hovedsakelig studentenes (og sensorenes) personvern, og at et videoopptak ikke nødvendigvis er tilstrekkelig for at en muntlig eksamen er etterprøvbar og dermed kan påklages.
Den foreliggende NOUs utvalg mener at denne vurderingen ikke lenger står seg, når en muntlig eksamen påvirker den samlede karakteren i større grad. Et lyd- eller videoopptak kan organiseres slik at det gjør en eksamen etterprøvbar. At det skal være to sensorer på en ikke-etterprøvbar eksamen, er etter utvalgets syn for å påse at eksamenen er faglig betryggende. Det er ikke tilstrekkelig for å sikre studentens rettssikkerhet. Utvalget vedgår at opptak, særlig som video, kan ha en nedkjølingseffekt, men mener at klageretten må ivaretas. Dette gjelder spesielt for større, selvstendige arbeider.
Personvernhensynene må vurderes på ny i lys av den større påvirkning en muntlig eksamen kan ha på karakteren, og dermed svekkede klagerettigheter. Utvalget mener at opptak ved muntlig del av kombinasjonseksamen kan regnes som nødvendig for at institusjonene skal kunne utføre sine oppgaver etter universitets- og høyskoleloven, og at behandling av personopplysninger dermed er hjemlet i uhl. § 2-8. Utvalget bemerker likevel at en særegen hjemmel for dette formålet kan være en ryddigere løsning.26
Etter en samlet vurdering fremstår dagens lovbestemmelser om kombinasjonseksamener som utdaterte. Utvalget ser behov for at reglene i uhl. §§ 11-6 til 11-11 gjennomgås for å legge best mulig til rette for kombinasjonseksamener og sikre studentenes rettssikkerhet og en effektiv klagebehandling.
Tilfeldig uttrekk av en andel studenter til supplerende eksamen
Flere institusjoner har gjennomført uttrekk, hvor en andel tilfeldig utvalgte studenter blir trukket ut til en supplerende, kontrollert eksamen. Ved Universitetet i Sørøst-Norge er dette blitt testet allerede før generative KI-systemer ble allment tilgjengelige: Alle studenter måtte forberede seg til både skriftlig og muntlig eksamen, men kun 25 prosent av studentene ble tilfeldig trukket ut til en muntlig eksamen, som var innholdsmessig avgrenset til den skriftlige besvarelsen og tilhørende pensum. Studentens prestasjon på den muntlige eksamenen kunne påvirke karakteren med én karakter opp eller ned. Til tross for at flere studenter klagde på å bli behandlet ulikt, besto piloten en klagevurdering: Studenter påklagde fremgangsmåten for formelle feil, men saken ble avslått.
Til sammenlikning kan det også tenkes å trekke ut studenter til en supplerende eksamen basert på en mistanke om fusk. Et slikt uttrekk reiser større etiske og juridiske utfordringer, da mistanke om fusk blandes inn i selve vurderingen. Studenten går i så fall ikke opp til en muntlig utspørring, men til en domstol-liknende kontrollsituasjon. Utvalget legger til grunn at det ikke er juridisk handlingsrom for å bruke en muntlig vurdering som del av en fuskesak. Dette er to prosesser som bør behandles adskilt.
Utvalget viser til uttrekk til muntlig som en mulighet, men vil fraråde det, ettersom alle studenter har rett til en faglig betryggende vurdering.
7.7 Formativ vurdering
Samtidig som studentenes tilgang på generative KI-systemer gjør det mer utfordrende å vurdere oppnådd læringsutbytte og etterlevelse av eksamensregler (jf. kap. 7.4), gir teknologien også muligheter for mer formativ vurdering. Språkmodellbaserte KI-systemer gjør det mulig for studenter å få læringsfremmende tilbakemeldinger på skriftlig arbeid i et praktisk talt ubegrenset omfang, med lav ressursbruk og minimal responstid (jf. kap. 6.4.3). Dette kan komme studentene direkte til gode i egenstudier, men det har også betydning for organiserte vurderingsaktiviteter.
Det er tidkrevende arbeid å gi nyttige, læringsfremmende tilbakemeldinger på oppgavebesvarelser. Undervisernes tid til oppgavevurdering har derfor vært en begrensende ressurs for hvor mange vurderingsaktiviteter det har vært mulig å gjennomføre i høyere utdanningstilbud. For flere grunnleggende former for læringsutbytte er dette en uheldig begrensning: Skal man utvikle faglige tenkemåter og generelle evner til kritisk og kreativ tenkning, er det en stor fordel med mengdetrening i det å skrive fagtekster. Skriveøvelse gir i seg selv verdifull læring, og det å få tilbakemeldinger på arbeidene kan gi en ytterligere læringsgevinst.
Med støtte fra KI-systemer kan universiteter og høyskoler gjennomføre flere vurderingsaktiviteter innenfor de samme ressursrammene. KI bidrar dermed til at man enklere kan gi den mengden oppgaver som er utdanningsfaglig ønskelig. Er modellene godt nok trent for formålet, og systemene godt instruert, kan KI-genererte tilbakemeldinger også medvirke til et større læringsutbytte. Under de rette forutsetningene kan KI-systemer slik gi et vesentlig bidrag til bedre studiekvalitet.
Gitt at vi har tilgang på systemer som selvstendig kan gjøre vurderinger av oppgavebesvarelser og gi tilbakemeldinger på dem, kunne det medført et lavere behov for at undervisere gjør den samme jobben. Det er flere grunner til at dette ikke følger. For det første er det etiske og juridiske hensyn som begrenser hvor avgjørende rolle man kan gi KI-systemer for ulike vurderingsoppgaver (jf. kap. 7.11). For det andre har det å få tilbakemeldinger fra en underviser, og ikke bare fra en programvare, trolig betydning for det faglige fellesskapet, tilhørighet til læringsmiljøet og for innsatsen studentene legger i arbeidet sitt. For det tredje kan undervisere i mange tilfeller gi nyttigere tilbakemeldinger enn tilgjengelige KI-systemer, enten på grunnlag av faglig kompetanse, kjennskap til studentene eller kjennskap til studietilbudet.
Det er altså gode grunner til å ønske at menneskelige tilbakemeldinger ikke erstattes av KI-genererte tilbakemeldinger. Et føre-var-prinsipp tilsier derfor at det er klokt å se på KI-genererte tilbakemeldinger som et rom for utforskning, som et supplement til undervisernes egne tilbakemeldinger, som et hjelpemiddel undervisere kan bruke i utvikling av egne tilbakemeldinger og som en mulighet for studentene til å få langt flere tilbakemeldinger og veiledet mengdetrening.
7.7.1 Arbeidskrav som virkemiddel
I tråd med vurderingen gitt i kapittel 7.4 har generative KI-systemer skapt et behov for å gjennomføre flere eksamener under tilsyn, og å kombinere ikke-kontrollerte vurderingsformer med kontrollerte vurderingsformer. Disse anbefalingene gjelder eksamen spesifikt, som har et klart summativt formål i tråd med universitets- og høyskoleloven (§ 11-6).
Ettersom de formative formålene med arbeidskrav generelt er sterkere, og de summative formålene svakere, er det ikke det samme behovet for kontroll i vurdering av arbeidskrav. Det å gjennomføre alle arbeidskrav under tilsyn kan gjøre dem mer kostbare, uten at det nødvendigvis gir et større læringsutbytte. Samtidig er det mange regler man ikke enkelt kan vurdere etterlevelse av når man ikke fører tilsyn. Gitt at man ikke enkelt kan vurdere oppnådd læringsutbytte og regelverksetterlevelse uten tilsyn, gir dette grunn til å rendyrke de formative formålene med arbeidskrav.
Selv om arbeidskrav ikke er like avgjørende vurderinger for studentene som eksamener, har godkjenninger av arbeidskrav implikasjoner for studentenes rettsstatus. Med dagens regulering er det derfor et svært begrenset handlingsrom for å automatisere godkjenninger av arbeidskrav, jf. 7.11.1 om sensur. Hvilke krav som stilles for å få et arbeidskrav godkjent varierer riktignok betydelig, fra formale krav til substansielle, skjønnsmessige krav, og det er sistnevnte som er særlig problematisk for automatisering.
Det er likevel et betydelig etisk og juridisk handlingsrom for å bruke KI-systemer til å gi læringsfremmende tilbakemeldinger til studenter. Det gjør det enklere å legge opp til den mengden og typen arbeidskrav som gir best læringsutbytte for studietilbudet, og med veltrente systemer kan tilbakemeldingene være særlig verdifulle for studentene. KI-systemer kan dermed tjene som effektive verktøy for å fremme de formative formålene med arbeidskrav, i tillegg til at de samme systemene kan brukes for å få tilbakemeldinger på annet arbeid.
7.8 Vurdering av KI-kompetanse og hybrid intelligens
I kapittel 5 diskuteres hvordan kunstig intelligens påvirker hva det er hensiktsmessig å lære. En av konklusjonene er at KI-utviklingen sannsynligvis vil medføre mange store endringer i hvordan vi løser faglige oppgaver på universiteter og høyskoler og ellers i arbeidslivet. Endringer i hva man skal lære innebærer imidlertid også endringer i hvilke former for læringsutbytte man skal vurdere. Følgende kategorier har blant annet betydning:
-
Generell KI-kompetanse: kunnskap om og ferdigheter i bruk av KI-systemer som alle studenter i høyere utdanning har nytte av
-
Fagspesifikk KI-kompetanse: kunnskap og ferdigheter som varierer mellom fagområder
-
Spesialisert KI-kompetanse: den kompetansen som setter en i stand til å utvikle, drifte og forvalte KI-systemer
-
Muliggjørende kompetanse: den kunnskapen og de ferdighetene som spiller en rolle for hvor godt vi lykkes i overgangen til et samfunn som er mer preget av teknologien – som evne til kritisk og kreativ tenkning, og etisk refleksjon
Det er særlig den fagspesifikke KI-kompetansen som er interessant i denne sammenheng. I den grad KI endrer fagkunnskap eller arbeidsmåter i fag, eller det opprettes nye fag eller emner ved institusjonene, må studenter prøves i relevant KI-kompetanse. Dette inkluderer for eksempel at det vil bli aktuelt å vurdere hva en student og et KI-system kan oppnå i samspill.
Boks 7.2 Hybrid intelligens
Det nasjonale senteret for KI og læring, AI LEARN, forsker på samspillet mellom mennesker og KI i ulike sammenhenger, inkludert utdanning. Forskerne ved senteret beskriver hybrid intelligens som et symbiotisk forhold hvor mennesker og KI-systemer interagerer og samarbeider, og hvor man trekker på både menneskelige kognitive styrker og på kapabilitetene til KI-systemene (se også Järvelä et al., 2023). Disse menneske-maskin-systemene består av ulike sammensetninger av mennesker og KI-systemer: Ett menneske og ett eller flere KI-systemer, eller flere mennesker og ett eller flere KI-systemer, der samhandlingen kan forbedre både menneskelig forståelse og KI-funksjonaliteten (Molenaar, 2022). Menneske-maskin-systemene krever nye kompetanser. I høyere utdanning kan man si at studenter og undervisere lærer sammen med, eller samskaper, eller vurderer sammen med KI-systemer. En hybrid tilnærming til læring ville hatt som målsetning å beskrive hvordan styrkene til de enkelte delene utfyller og forbedrer hverandre.
Dette har betydning for student-KI-samspillet i vurderingssituasjoner. Det blir avgjørende å vurdere både sluttproduktet av student-KI-samspillet og hvordan studenten har brukt KI-systemet. For å identifisere det siste kan sluttproduktet (besvarelsen) suppleres med en beskrivelse av hvordan KI-systemet er brukt, studentens refleksjoner over bruken og en logg av system-instruksjonene.
7.9 KI-assistert vurdering
Luckin (2025) argumenterer for å utforske alternativer til tradisjonelle vurderingsformer: KI-assistert formativ vurdering som sporer læringsprogresjon; mappevurdering som viser autentisk problemløsing; mekanismer for egenvurdering og fagfellevurdering støttet av KI-analyse.
Noen eksempler på metoder er AI-Guided Self-Assessment & Reflection, hvor studenter bruker en samtalerobot for å prøve ut, forklare eller evaluere sin forståelse av et konsept, AI First, Human Revision, hvor studenter bruker en samtalerobot til å lage et første utkast eller løsning som de forbedrer eller bygger på, Human First, AI Revision, som gjør det motsatte, og AI as Simulated Collaborator or Role-Player, hvor studenter fører en dialog med en samtalerobot som simulerer en karakter, en ekspert, eller en eksisterende person (Digital Education Council, 2025b).
Boks 7.3 Forsøk med teknologistøttet vurdering ved Universitetet i Tromsø – Norges arktiske universitet (UiT)
Seks odontologistudenter ved UiT deltok høsten 2025 i et pilotforsøk med KI-assistert formativ vurdering knyttet til et skriftlig arbeidskrav i immunologi. Studentenes fritekstbesvarelser ble først vurdert manuelt av faglærer, før de ble benyttet til utprøving av et KI-system under utvikling i eksamensplattformen WISEflow. Sammen med besvarelsen ble KI-systemet matet med sensorveiledning, vurderingskriterier og presise instrukser. Den KI-genererte tilbakemeldingen ble deretter vurdert av faglærer og student.
Forsøket viste at verktøyet kunne generere strukturert og i hovedsak faglig relevant formativ tilbakemelding når vurderingskriterier og tydelige instrukser lå til grunn. Studentene vurderte tilbakemeldingene som tydelige på hva som var riktig og galt i besvarelsen, og hva som kunne gjort besvarelsen bedre. Samtidig avdekket forsøket at deler av tilbakemeldingene var for generelle eller inneholdt faglige unøyaktigheter, og at faglig kvalitetssikring var nødvendig før resultatet kunne deles med studentene.
Kilde: Rapport etter første år med prosjektet «Nye vurderingsformer» (Sommerlund, 2026).
7.10 Adaptiv og individuell vurdering
Adaptiv vurdering
Adaptiv vurdering handler om at de oppgavene en student får i en vurderingssituasjon blir bestemt underveis i vurderingen, basert på tidligere svar. Hver enkelt student kan slik få et skreddersydd utvalg av oppgaver, basert på hva studenten viser at hen forstår, kan og vet underveis i vurderingen. Hensikten med slik adaptiv vurdering er å bedre kartlegge studentens oppnådde læringsutbytte, både i bredden og dybden av læringsutbytter som skal prøves. For studenten kan det bety bedre muligheter til å vise hva hen kan, forstår og vet. En muntlig eksamen er en form for adaptiv vurdering, hvor eksaminator tilpasser spørsmålsstillingen til hva studenten svarer.
I datamaskinbasert adaptiv vurdering vil kandidaten få spørsmål hentet fra en spørsmålsbank, altså en større samling spørsmål knyttet til emnet kandidaten vurderes i. Mange adaptive vurderingssystemer er basert på teorier og funn fra Item Response Theory – IRT (Papanastasiou, 2014). Tradisjonelle systemer er typisk utviklet basert på psykometri og statistikk, og forutsetter ikke bruk av datadrevne KI-systemer. I en gjennomgang av komponentene som inngår i datamaskinbasert adaptiv testing, som inkluderer modeller for måling, algoritmer for utvelgelse av oppgaver, oppbygning av spørsmålsbanker og testkontroll, viser Zhuang et al. (2026) hvordan maskinlæring kan optimalisere disse komponentene.
Boks 7.4 Automatisk bildekritikk ved Universitetet i Agder
Prosjektet ImageCritique 2.0 ved Universitetet i Agder utforsker hvordan KI kan brukes til å gi individuelle tilbakemeldinger på grafisk design og fotografi. En multimodal samtalerobot brukes til å gi umiddelbare tilbakemeldinger på bildebaserte studentarbeider. Målet er å øke studentenes læringsutbytte i et dynamisk læringsmiljø som fremmer kreativitet og teknisk forståelse. Samtidig vil verktøyet kunne effektivisere vurderingsprosessen for undervisere og frigjøre ressurser til veiledning av store studentkull.
Kilde: Informasjon til utvalget fra senioringeniør Haakon Lied Sundbø ved Universitetet i Agder
Individuelle eksamensoppgaver
Det er mulig for en sensor, med eller uten hjelp av et KI-system, å lage individuelle eksamensoppgaver – på samme måte som det gjøres i dag ved muntlig forsvar av en skriftlig hjemmeeksamen, fortrinnsvis ved f.eks. en masteroppgave. I emner med mange studenter kunne man tenke seg at studenter utarbeider en skriftlig (ikke-kontrollert) hjemmeeksamen. Så bruker sensor et KI-system som utarbeider oppfølgingsspørsmål til en kort (kontrollert) skoleeksamen. Oppfølgingsspørsmålene er tilpasset hver students innlevering fra hjemmeeksamenen, og går dypere inn på det de leverte for å kunne vurdere oppnådd læringsutbytte.
Her er det to hensyn. Det første er likebehandling av studentene. Likebehandling krever ikke identiske eksamensoppgaver, men lik vurderingsstandard – dvs. lik sensorveiledning og fastsatt læringsutbytte for emnet – samt like reelle muligheter. Det enkleste er å påvise likebehandling gjennom å stille materielt like eksamensspørsmål. Men det er ikke et krav: Forskjellsbehandling er bare ulovlig når den er usaklig. Det som gjør forskjellsbehandlingen saklig, er at oppfølgingsspørsmålene må være ulike – nettopp fordi de må være tilpasset studentens besvarelse for å kunne vurdere hvilket læringsutbytte studenten samlet sett viser.27 Formålet med en slik kontrollert eksamensdel bør være en nærmere vurdering av hvorvidt studenten har oppnådd læringsmålene. Det vil likevel kunne være studenter som mener seg ulikt behandlet ved en slik framgangsmåte. Det er derfor viktig å påse at oppfølgingsspørsmålene er rettferdige og balanserte. Utvalget mener at hensynet til likebehandling kan ivaretas gjennom å påse at det ikke er urimelige forskjeller på de oppgavene studentene gis, samtidig som man oppnår en ressurseffektiv og faglig betryggende prøving.
Dersom de individuelle eksamensoppgavene lages ved hjelp av et KI-system, må det også tas hensyn til hva slags KI-system som brukes og hvordan. Som et minimum må det være et lukket system med kontroll på dataene, og det må foreligge et behandlingsgrunnlag etter GDPR. I tillegg utgjør det et høyrisikosystem etter KI-forordningen: I likhet med å bruke KI-systemer til sensur vil det å utforme eksamensoppgaver ved hjelp av KI-systemer regnes som høyrisiko (jf. kap. 7.11.1.2 og EU-kommisjonen (2026d, pkt. 220–225 og eksempler)). Det utløser blant annet et krav til menneskelig kontroll (se Boks 4.3).
7.11 Sensur og karakterbegrunnelser
Institusjonene bruker mye ressurser på sensur og karakterbegrunnelser. Dagens system med menneskelig sensur er ikke ufeilbarlig. Ulike sensorer kan gjøre ulike vurderinger (NOKUT, 2017; Sætre, 2025). Man kan øke kvaliteten på sensuren, for eksempel ved å ha to sensorer, men en slik ordning er svært ressurskrevende.
Sensur og karakterbegrunnelse er også sterkt rettighetsstyrte oppgaver. Dagens regelverk setter derfor mange begrensninger for bruk av KI-systemer til sensur og karakterbegrunnelse, samtidig som det gir noen muligheter.
Før gjennombruddene vi har sett med store språkmodeller, var det utenkelig med programvare som kunne gjøre begrunnede vurderinger av oppgavebesvarelser i fritekst. De nye tekniske mulighetene fordrer at vi vurderer om og hvordan KI-systemer kan fungere som verktøy for sensur og karakterbegrunnelse. Sentrale momenter i en slik vurdering er hva KI-bruk gjør med kvaliteten på sensur og karakterbegrunnelser, i hvor stor grad KI-systemer kan effektivisere oppgavene og hva som skal til for å ivareta tilliten til vurderingssystemet. Når resultatene må være pålitelige, og hensynet til studentenes rettigheter veier tungt, er det viktig å diskutere om og hvordan vi kan bruke dagens KI-systemer som verktøy for sensur og karakterbegrunnelse i hele eller deler av prosessen.
Det er tre skiller som er særlig viktige i denne diskusjonen:
-
Sensur vs. karakterbegrunnelse: Sensur er et enkeltvedtak om karakter (som godkjent/ikke godkjent eller som bokstavkarakter), noe vi skal skille fra begrunnelsen for et slikt vedtak, jf. uhl. §§ 11-7 og 11-8. Sensur og karakterbegrunnelse drøftes hver for seg i det følgende.
-
Automatisering vs. hjelpemiddel: KI-systemer kan automatisere sensuren eller karakterbegrunnelsene, eller de kan på ulike måter brukes som et hjelpemiddel, for eksempel til å kvalitetssikre menneskelige vurderinger. Risikoene ved automatisert KI-bruk er større enn ved bruk som hjelpemiddel. Samtidig er effektiviseringspotensialet ved automatisering betydelig større. Automatisering er gjennomgående strengere regulert i norsk og internasjonal lovgivning.
-
Forsøk vs. vanlig praksis under loven: Dersom en institusjon får innvilget søknad om å gjennomføre tidsavgrensede pedagogiske eller organisatoriske forsøk, kan man fravike bestemmelser i universitets- og høyskoleloven (jf. § 17-1).
Hvorvidt det er hensiktsmessig og lovlig å bruke KI-systemer til sensur og karakterbegrunnelse kan variere på tvers av disse skillelinjene.
7.11.1 Bruk av KI-systemer til sensur
7.11.1.1 Pålitelighet og ønskelighet av å bruke KI-systemer til sensur
Studenter har rett på en upartisk og faglig betryggende vurdering av hvilket læringsutbytte de har oppnådd. Fordi mye står på spill både for studentene og samfunnet, er dette et viktig fundament. For studentene danner eksamensresultatene grunnlag for grader og vitnemål, muligheter for arbeid, verv og videre studier. Det går ut over arbeidsgivere og samfunnet dersom uteksaminerte kandidater får jobber og verv de ikke er kvalifisert for.
Selv om sensorer vurderer besvarelser objektivt, vil sensur i de fleste tilfeller ha et element av faglig skjønn. Sensuren påvirkes også av hvordan sensoren(e) stiller seg til eksamensoppgaven og krav til besvarelsen, hvordan de tolker og anvender vurderingskriteriene, og vurderingen kan påvirkes av kvaliteten på andre besvarelser. Kompleksiteten og de intuitive elementene ved slike vurderinger gjør derfor variasjon mellom sensorer uunngåelig. Når to sensorer samarbeider om å fastsette en karakter med et felles mål om å oppnå et rettferdig resultat, blir resultatet en samstemt, men ikke nødvendigvis mer presis vurdering (Sætre, 2025).
Universitets- og høyskoleloven gir flere rettssikkerhetsgarantier til studenter utover retten til å påklage et sensurvedtak. Garantiene omfatter, avhengig av eksamenen, krav om to sensorer, ekstern sensor, nye sensorer ved klage og ny vurdering ved karaktersprik mellom opprinnelig sensur og klagesensur, jf. uhl. §§ 11-7 og 11-11. Garantiene uttrykker både viktigheten av korrekt sensur – dvs. at den skal være upartisk og faglig betryggende – og behovet for mekanismer for å ivareta studentens rettssikkerhet.
Påliteligheten til KI-sensur
Dersom man skal bruke KI-systemer til sensur, med eller uten et menneske, er det avgjørende å kartlegge om KI-systemet, og bruken man gjør av det, kan holde samme kvalitetsstandard som sensorer. Uten dette får man ikke ivaretatt studentenes rett til en upartisk og faglig betryggende sensur. I tillegg til at sensuren må være upartisk og faglig betryggende, bør den være på et tilsvarende nivå som en gjennomsnittlig sensor, eller høyere.
Utvalget forventer at det allerede er fullt mulig å utvikle KI-systemer som i mange tilfeller gjennomfører sensur like godt som fagpersoner. I en omfattende studie ved Universitetet i Gøteborg ble sensur med en generisk samtalerobot (drevet på modellen GPT-3.5) sammenlignet med menneskelig sensur (Flodén, 2025). Samtalerobotene klarte i et stort flertall av oppgavevurderingene å treffe nær sensorenes vurdering (10 prosent avvik), og nesten en tredjedel av vurderingene var svært nær (5 prosent avvik). Samtaleroboten ga litt høyere karakterer, men unngikk også veldig høye eller veldig lave karakterer. Studien konkluderte med at liknende avvik også finnes ved sensur av ulike menneskelige sensorer.
I en studie hvor man benyttet ChatGPT til å gi karakterer på studenters essay i et førsteårskurs i biovitenskap, fant Kay et al. (2026) også at KI-systemet «presset sammen» karakterene: Svake besvarelser ble vurdert høyere av KI-systemet enn av sensor, og sterke besvarelser fikk dårligere karakter av KI-systemet. Hensikten med forsøket var å vurdere om studentene kunne få en god indikasjon på hvilken karakter de kunne forvente på arbeidet. Forfatterne konkluderte med at KI-systemene de testet ikke var egnet til dette formålet.
I en studie fra 2023 fant Kortemeyer at karakterene gitt av samtalerobot hadde sterk korrelasjon med sensorers karakterer28 for håndskrevne eksamensbesvarelser i friform i fysikk, men konkluderte allikevel med at KI-sensuren ikke var pålitelig nok til å fungere som reell sensur (Kortemeyer, 2023). Modellene var på det tidspunktet fortsatt hemmet av begrenset kapabilitet for oppgavene som ble undersøkt. Dersom allerede utdaterte modeller med generiske systemer kan oppnå disse resultatene, er det sannsynlig at en modell som er spesifikt trent for oppgaven og satt i et velegnet system, kan ha større potensial. Presise sensorveiledninger blir en viktig forutsetning, da KI-modeller generelt fungerer bedre med klare instrukser. I hvor stor grad man oppnår fordelene og unngår ulempene med bruk av KI-systemer til sensur, vil avhenge av hvor gode modeller og systemer man har tilgjengelig.
Fordeler og risikoer ved bruk av KI-systemer til sensur
KI-systemer kan gi både kvalitets- og effektivitetsgevinster for sensur:
-
Kvalitet: KI-systemer kan potensielt gi en mer konsistent og rettferdig karaktersetting i samsvar med sensorveiledningen, både ved automatisk sensur og som beslutningsstøtte. KI-systemer kan også brukes til å analysere menneskesatte karakterer i lys av sensorveiledningen og identifisere mønstre og eventuelle avvik som sensor bør revurdere. En slik kalibrering kan føre til mer konsistent sensurering.29
-
Effektivitet: Dersom sensur kan automatiseres vil det isolert sett kunne gi store effektiviseringsgevinster. Også som hjelpemiddel kan KI-systemer effektivisere sensuren, f.eks. ved å redusere behovet for medsensor.
Å bruke KI-systemer til sensur bærer også med seg risiko. Hvor store de følgende risikoene er, avhenger av om det er snakk om automatisert sensur eller bruk av KI-systemer som hjelpemidler:
-
Videreføring av skjevheter: Alle datasett har skjevheter (jf. kap. 4.2.1 og 4.3.5). Det kan f.eks. være egenskaper ved studentbesvarelser som historisk er blitt overpremiert og andre som er blitt underpremiert. Slike skjevheter blir videreført av KI-modeller og vil da kunne bli forsterket.
-
Atypiske besvarelser: KI-systemer kan ha vansker med å fange opp unike eller kreative svar som avviker fra en tradisjonell norm, men som likevel er faglig sterke.
-
Innsatskostnad: Selv om de teknologiske forutsetningene er på plass, kreves det innsats å utvikle gode KI-modeller for sensur. Bredden av fag, utdanninger og emner viser de økonomiske og miljømessige kostnadene det har.
-
Etterprøvbarhet: Med mindre KI-systemene har svært høy grad av forklarbarhet vil det være vanskelig å etterprøve vurderingene til et KI-system. Risikoene knyttet til manglende etterprøvbarhet er langt større ved automatisering enn ved bruk som hjelpemiddel, og påvirker derfor studentenes rettssikkerhet (jf. kap. 4.2.1. og 4.3.4).
7.11.1.2 Juridisk handlingsrom
Etter dagens regler er det under visse, strenge vilkår mulig for sensorer å bruke KI-systemer som hjelpemiddel. Regelverket åpner ikke for å automatisere sensur.
Sensorkravet
Uhl. § 11-7 krever at sensor(er) gjennomfører sensur, og tillater ikke automatisert sensur med KI-systemer. Sensuren er del av institusjonenes ansvar for å prøve studentenes kunnskaper og ferdigheter på en upartisk og faglig betryggende måte, jf. uhl. § 11-6. Utvalget legger til grunn at sensorkravet muligens ikke kan fravikes ved bruk av forsøk etter uhl. § 17-1, men dette er det opp til Kunnskapsdepartementet å avklare.30 Merk likevel at selv under en slik tolkning kan det være mulig å gjøre forsøk med automatisert sensur hvor det parallelt blir gjort en menneskelig sensur som gjeldende vedtak.
Automatisert sensur
Ser man bort fra sensorkravet i uhl. § 11-7, åpner den nye forvaltningsloven for automatisert saksbehandling under vilkår (forvaltningsloven 2025 §§ 11 til 13, se også kapittel 4.3.4). Loven åpner for automatisering av skjønnsmessige vurderinger, som de fleste sensurvurderinger er, der dette er forsvarlig. Hvorvidt det er forsvarlig, og dermed mulig, vil bero på en konkret vurdering av KI-systemet som anvendes. I tillegg må kravene i gjeldende regelverk være oppfylt.31 Mange av den nye forvaltningslovens regler om automatisert saksbehandling styrker studentenes rettssikkerhet: Ved KI-sensur skal studenten få en (nærmest umiddelbar) forklaring av vedtaket, en rett til å uttrykke sine synspunkter og til å kreve manuell kontroll av en sensor, i tillegg til alminnelig klagerett. KI-forordningen inneholder ytterligere sikkerhetsmekanismer, se nedenfor og kapittel 4.3.2.
Høyrisikosystem etter KI-forordningen
Bruk av KI-systemer til sensur er særskilt regulert i KI-forordningen.32 KI-systemer som er beregnet på å vurdere læringsutbytte klassifiseres som høyrisiko-systemer (KI-forordningen art. 6 nr. 2, jf. vedlegg III, 3 bokstav b). Delvurderinger, slik som av arbeidskrav, dersom de er summative, er også omfattet.33 Klassifiseringen medfører at slike systemer er underlagt omfattende forpliktelser, slik som krav til menneskelig kontroll, åpenhet, informasjon og risikohåndtering (KI-forordningen art. 8–27). Se nærmere beskrivelse i kapittel 4.3.2.
Også KI-systemer som er ment som beslutningsstøtte til sensorer er i de aller fleste tilfeller et høyrisikosystem, selv når sensoren reelt tar en egen beslutning om karakteren. Menneskelig involvering og kontroll er et basiskrav for høyrisikosystemer, og gir ikke unntak fra høyrisikoklassifisering (EU-kommisjonen, 2026d, avsnitt 70–71). KI-forordningen art. 6 nr. 3 gir unntak når KI-systemet «ikke i vesentlig grad påvirker utfallet av beslutningsprosesser». Men dette unntaket må tolkes veldig snevert: Det åpner for eksempel ikke for å bruke KI-systemer til å forberede et forslag til sensur. Unntaket gjelder når:
-
KI-systemet er beregnet på å utføre en forberedende ikke-substansiell oppgave, som å indeksere studentbesvarelser eller å generere generell informasjon (KI-forordningen art. 6 nr. 3 første ledd og andre ledd, bokstav d, jf. EU-kommisjonen, 2026d, avsnitt 103–108).
-
KI-systemet er beregnet på å verifisere eller finjustere resultatet av en menneskelig aktivitet, uten substansielle endringer i resultatet – altså er ikke KI-bestemte endringer av karakterer omfattet av dette unntaket (KI-forordningen art. 6 nr. 3 første ledd og andre ledd, bokstav b, jf. EU-kommisjonen, 2026d, avsnitt 94–96).
-
KI-systemet er beregnet på å identifisere beslutningsmønstre eller avvik. KI-systemet kan fungere som et kvalitetssikringsverktøy under dette unntaket, dersom det er sensor som, etter grundig vurdering, eventuelt endrer karakterer.34
Dermed utgjør det liten forskjell for høyrisikoklassifisering, om KI-systemet brukes som beslutningsstøtte for sensur eller om det brukes for automatisert sensur. Unntaket er ved kvalitetssikring, da dette kan unntas høyrisikoklassifisering under vilkår (jf. siste strekpunkt ovenfor). Bruk av KI-systemer som et hjelpemiddel til sensur, som ikke påvirker sensors vurdering (for eksempel til språkvask eller strukturering av notater), er ikke omfattet av høyrisikoklassifiseringen.
Personvern
Studentenes eksamensbesvarelser er å anse som personopplysninger, og derfor skal bruk, lagring og deling av eksamensbesvarelser skje innenfor personvernregelverket som gjelder i Norge og EU (jf. kapittel 4.3.3). Uhl. § 2-8 gir institusjonene hjemmel til å behandle personopplysninger om en søker, student eller doktorgradskandidat når det er nødvendig for å utføre oppgaver etter loven. Den sentrale oppgaven i denne sammenheng er å sørge for at studentenes kunnskaper og ferdigheter blir prøvd og vurdert på en upartisk og faglig betryggende måte, jf. uhl. § 11-6. Dette gir hjemmel for å laste eksamensbesvarelser inn i et KI-system, så lenge institusjonen har kontroll på dataene. Den menneskelige vurderingen må være reell – prosessen kan ikke i praksis utgjøre en helautomatisering uten særskilt lovhjemmel – noe som fordrer gode rutiner for menneskelig involvering.35 Videre krever det en personvernkonsekvensvurdering.36 Som personopplysninger kan ikke eksamensbesvarelser uten videre brukes til å trene KI-systemer.37
Opphavsrett
Som hovedregel oppfyller studentenes oppgavebesvarelser kravene til verkshøyde etter åndsverkloven § 2, fordi de er litterære eller kunstneriske verk som er uttrykk for original og individuell skapende åndsinnsats. Svar på flervalgsoppgaver og tilsvarende faller utenfor. Slik utvalget har vurdert rettstilstanden, tillater opphavsretten at institusjonene laster studentenes oppgavebesvarelser opp i KI-systemer, så lenge det ikke innebærer å (risikere å) gi fra seg dataene til tredjeparter, eller at institusjonene selv skal bruke dem som treningsdata. Dersom institusjonene skal bruke dataene til trening, bør det kun skje etter et samtykke (rettighetsklarering) fra studenten.
I fremtiden vil det, opphavsrettslig sett, bli enklere å bruke eksamensbesvarelser til tekst- og datautvinning, dvs. for å trene en KI-modell til sensur og karakterbegrunnelser, uten behov for annen hjemmel eller samtykke fra studentene (se kap. 4.3.6.). Dette er regulert i digitalmarkedsdirektivet art. 4, som Kulturdepartementet jobber med å gjennomføre i norsk rett.38 Selv om disse nye reglene trer i kraft, vil det fortsatt være mulig for studenter å aktivt reservere seg mot bruk av eksamensbesvarelser til trening av KI-modeller.
Veiledning av sensorer og informasjon til studenter ved forsøk med KI-sensur
Institusjonenes ansvar i forvaltning av KI-systemer inkluderer å treffe tiltak som veiledning og opplæring av faglig ansatte og (eksterne) sensorer, samt en informasjonsplikt til studenter.
Opplæringsplikten overfor sensorer innebærer å sørge for tiltak som skal sikre et tilstrekkelig nivå av KI-kompetanse, tilpasset den konteksten KI-systemet skal brukes i (KI-forordningen art. 4). Den er skjerpet for høyrisikosystemer, slik som ved bruk av KI-systemer til sensur, med krav om at de som ivaretar menneskelig kontroll skal ha nødvendig kompetanse, opplæring og myndighet slik at kontrollen er reell (KI-forordningen art. 26 nr. 2 og 7; jf. personvernforordningen art. 24). Institusjonenes veiledningsplikt inkluderer også å veilede om hva som ikke er lov, for eksempel å bruke åpne samtaleroboter til sensur uten kontroll på dataene.39 Institusjonene skal ha retningslinjer som forbyr slik ulovlig aktivitet, aktivt bevisstgjør sensorer og følger opp praksis gjennom internkontroll (personvernforordningen, art. 39 nr. 1 b og art. 5 nr. 2, jf. art. 24 og 32.).
Samtidig er det fullt mulig å utforske hvilket potensial KI-systemer har for sensur, uten å la KI-systemer faktisk bestemme karakteren. Det kan gjøres parallelt med menneskelig sensur som gjeldende vedtak. KI-forordningen inneholder egne regler for testing av høyrisikosystemer slik som KI-sensur, under virkelige forhold.40
Videre har institusjonene en informasjonsplikt til studentene sine, både med hensyn til behandling av personopplysninger, automatisert saksbehandling, og om bruk av KI-systemer (KI-forordningen art. 50, jf. art. 86; personvernforordningen art. 13, 14 og 22).
7.11.1.3 Utvalgets vurdering
KI-systemer kan effektivisere og muligens styrke kvaliteten på sensur, men det er også betydelige risikoer. Sensur er en sentral og rettssikkerhetskritisk del av høyere utdanning, der karaktervedtak får store konsekvenser for den enkelte student. Risikoene KI-sensur bærer med seg – for feilaktig karaktergivning, skjevpremiering og manglende forklarbarhet – gjør det klokt å legge til grunn et føre-var-prinsipp. Innføring av ny teknologi må basere seg på et godt kunnskapsgrunnlag og gjøres innenfor juridiske og etiske rammer.
Utvalget legger til grunn at sensur aldri vil være ufeilbarlig, og at variasjon mellom menneskelige sensorer er en kjent og akseptert del av dagens ordning. Kunnskapsgrunnlaget viser at dagens KI-systemer har et potensial for å gi reliabel sensur, som i denne sammenhengen betyr å sette tilsvarende karakterer som menneskelige sensorer. Forskningsresultatene er lovende, men ikke så gode eller så robuste at de begrunner å åpne for KI-støttet eller -automatisert sensur. En gjenganger i litteraturen er at KI-systemer «presser sammen» karakterene til midten av karakterskalaen, med færre karakterer i det nederste og øverste sjiktet. Vi vet heller ikke nok om KI-systemenes evne til å forklare hvorfor en besvarelse blir vurdert til en gitt karakter. Underskudd på forklarbarhet gir grunn til å stille enda høyere krav til KI-systemenes evne til å vise faglig skjønn i karaktersetting.
Vi behøver også mer kunnskap om ytre effekter av KI-sensur, for eksempel om hvordan det påvirker forholdet mellom student og underviser, studiemotivasjon og vurderingens samsvar med undervisningen. Forsvarligheten av KI-sensur beror også på disse faktorene. Mens KI-sensur i utgangspunktet kan sees på som en fortrengning av en menneske-til-menneske-interaksjon, kan det samtidig gi mer tid til (menneskelig) undervisning og veiledning.
I lys av disse grunnene vurderer utvalget at det i dag ikke er faglig, etisk eller juridisk forsvarlig å åpne for KI-sensur, verken som automatisert sensur eller som beslutningsstøtte for sensor. Dette utelukker ikke at KI-systemer kan spille en rolle i sensur i fremtiden. Som beskrevet nedenfor, mener utvalget at KI-systemer i første omgang kan ha verdi som et verktøy for kvalitetssikring av sensur.
KI-systemers rolle i sensur i fremtiden
Utvalget mener at KI-systemenes potensial for sensur vil bli bedre over tid. Kapabilitetsutviklingen vil etter alt å dømme fortsette. Kunnskapsgrunnlaget vi har i dag henger etter teknologiutviklingen: Publiserte studier tar utgangspunkt i modeller som allerede har blitt erstattet av mer kapable modeller. Det er også mulig å videretrene modeller på sensur spesifikt. Gjøres slik videretrening innenfor bestemte fag, vil det kunne gi modeller som er spesielt godt trent for å utøve det faglige skjønnet som sensur typisk krever. Kvaliteten på resultatene man får med KI-sensur vil også avhenge av hvordan systemene blir instruert. For eksempel kan en god sensorveiledning ha mye å si.
På kort til mellomlang sikt vurderer utvalget at KI-systemer kan ha en verdifull rolle som kvalitetssikringsverktøy. Dette innebærer at sensor fastsetter karakterene, og at KI-systemet flagger eventuelle avvik. Så er det sensor selv som vurderer om visse karakterer skal justeres. Dette er det eneste substansielle bruksområdet der bruk av et KI-system til sensur er unntatt fra klassifisering som høyrisikosystem etter KI-forordningen. Krav knyttet til beskyttelse av personopplysninger gjelder fullt ut.
På lengre sikt kan KI-systemer spille en større rolle i sensur, som beslutningsstøtte, ved å avhjelpe behovet for medsensorer eller, eventuelt, ved automatisering. I utviklingen på dette området er det vesentlig å bevare rettssikkerheten til studentene.
Dersom KI-systemene viser seg å bli like gode som menneskelige sensorer, og de kan oppfylle krav til transparens og etterprøvbarhet, er det i teorien mulig å automatisere sensur. Det vil i så fall kreve en særskilt hjemmel i universitets- og høyskoleloven. For at et slikt tiltak skal være forsvarlig, må det ikke gå på bekostning av tilliten til høyere utdanning.
I et større bilde må automatisering av sensur også vurderes opp mot den samlede KI-bruken i høyere utdanning. Et viktig moment er hvilken makt man gir til eksterne teknologileverandører, drevet av andre formål enn universitetene og høyskolene (jf. kapittel 8). Videre, dersom for mange kjerneoppgaver overlates til teknologi, kan det samlet sett uthule verdien av høyere utdanning. Selv om det kan være gode grunner for å automatisere enkeltoppgaver, kan den samlede effekten være problematisk.
Forsøk
Utvalget anbefaler at det gjennomføres forsøk med KI-sensur. Anbefalingen er begrunnet i at vi har et manglende kunnskapsgrunnlag om påliteligheten av KI-sensur og at KI-systemer i prinsippet kan gi betydelige kvalitets- og effektiviseringsgevinster. Med forsøksbasert kunnskap om påliteligheten av KI-sensur kan man bedre avgjøre hva slags rolle KI-systemer kan ha i gjennomføring av sensur, herunder hvorvidt og hvordan KI-systemer kan brukes til kvalitetssikring.
Slike forsøk må gjennomføres innenfor det juridiske handlingsrommet som er beskrevet ovenfor (jf. kapittel 7.11.1.2). I praksis betyr det å gjennomføre menneskelig sensur som gjeldende vedtak, uten bruk av KI, og så sammenlikne disse med resultatene et (personverntrygt) KI-system kommer frem til. Med en slik innretning ivaretar man både studentenes rettssikkerhet og tilliten til institusjonene, samtidig som man utvikler mer kunnskap.
Det fremste formålet med slike forsøk er å finne ut hvor pålitelige (reliable) KI-systemer kan være, målt opp mot vurderingene til en eller flere sensorer. Videre er det verdifullt å finne typiske feilkilder ved KI-sensur. Følgende variabler er av særlig interesse:
-
Modellvalg, herunder om modellen er videretrent for formålet
-
Instruksjonene som har vært gitt
-
Hvilke fag og hva slags oppgaver det blir prøvd på
På lengre sikt kan det utvikles forsøk med automatisert KI-sensur, dersom det foreligger et kunnskapsgrunnlag som tilsier at det er forsvarlig, og det er tillatt etter reglene som da gjelder. Forsøk med automatisert KI-sensur er gjenstand for krav om menneskelig kontroll av sensuren, og en rett for studenten til å kreve manuell kontroll av sensurvedtaket sitt. For å legge til rette for slike eksperimenter, bør rettsgrunnlaget for forsøk utredes nærmere, i tråd med ny forvaltningslov § 11, kommende forskrift om automatisert saksbehandling og KI-loven.
Unngå uregulert sensur med åpne samtaleroboter
Institusjonene har en plikt til å sikre at det ikke foregår skjult eller uregulert KI-sensur. Utvalget viser til at tydelige retningslinjer og opplæring av sensorer er påkrevd for å sikre lovlig sensur. I tillegg anbefaler utvalget at institusjonene inkluderer et forbud mot skjult eller uregulert KI-bruk til sensur i sensoravtalene.
7.11.2 Bruk av KI-systemer til karakterbegrunnelse
7.11.2.1 Pålitelighet og ønskelighet av å bruke KI-systemer til karakterbegrunnelser
En student har rett til å få en begrunnelse for sensurvedtaket sitt, jf. uhl. § 11-8. Begrunnelsen skal inneholde de generelle prinsippene som er lagt til grunn for sensuren, og vurderingen av studentens prestasjon. Ifølge Prop. 126 L (2022–2023), pkt. 23.11.8, skal «begrunnelsen gjøre studenten i stand til å se sine prestasjoner i lys av målene institusjonen har satt for besvarelsen og gi grunnlag for studenten til å vurdere om det er grunn til å klage på karakteren». Retten til karakterbegrunnelse følger av den generelle retten til begrunnelse av enkeltvedtak, etter forvaltningsloven § 24.41
Hvis en student ber om karakterbegrunnelse, skal den foreligge innen to uker, jf. uhl. § 11-8. Spesielt ved eksamener med mange kandidater kan dette legge et stort press på sensor. Som for sensur, gir språkmodellbaserte KI-systemer hittil ukjente muligheter for utarbeidelse av karakterbegrunnelser.
Fordeler og ulemper ved bruk av KI-systemer til karakterbegrunnelser
Det å bruke KI-systemer til karakterbegrunnelser kan gi flere fordeler:
-
Effektivitet: Et språkmodellbasert KI-system kan raskt og rimelig generere mange karakterbegrunnelser, og slik sterkt redusere arbeidsmengden for sensorer. Brukes KI-systemer som vurderingsstøtte vil sensorer fortsatt måtte bruke tid på å gjøre egne vurderinger, men trolig mindre. Tidsbesparelsen kan komme studiekvaliteten til gode, f.eks. gjennom mer tid til undervisning eller veiledning. KI-genererte karakterbegrunnelser kan også gjøre at studentene får raskere tilbakemelding.
-
Konsistens: KI-systemer kan gi mer konsistente begrunnelser gjennom å kalibrere innholdet i et sett med karakterbegrunnelser. Det kan også bidra til at omfanget og detaljgraden i begrunnelsene blir likere.
-
Forklaringsverdi: På grunn av effektiviteten kan KI-systemer gi grundigere og mer detaljerte forklaringer enn hva menneskelige sensorer i praksis har tid til.
-
Læringsgevinst: KI-systemer kan peke på konkrete styrker og svakheter i studentens besvarelse, eller gi forslag til forbedring, oppfølgingsspørsmål og nyttige referanser for videre arbeid. KI-systemer kan slik øke læringsgevinstene av karakterbegrunnelser.
Det er også flere ulemper og risikoer ved bruk av KI-systemer til karakterbegrunnelse:
-
Faglig dybde: Dagens språkmodeller har en varierende evne til å vurdere nyanser i faglig innhold og dybde, kontekst og kreativitet. Dette kan føre til upresise eller lite relevante karakterbegrunnelser, spesielt i åpne oppgaver.
-
Redusert ansvarsfølelse: Bruk av KI-systemer til karakterbegrunnelser kan føre til redusert ansvarsfølelse hos sensor, eller fjerne ansvaret helt ved automatiserte begrunnelser. Dette kan svekke kvaliteten på karakterbegrunnelsene og ha ringvirkninger for kvaliteten på sensuren.
-
Annen avsender: Hvis sensor fatter et karaktervedtak og studenten får en KI-generert begrunnelse, så kan grunnene KI-systemet oppgir, avvike fra de grunnene sensor hadde for å sette karakteren. Avviket betyr ikke at grunnene KI-systemet gir er dårlige eller unyttige, men at de ikke nødvendigvis gjenspeiler de faktiske resonnementene til sensor.
Boks 7.5 Prosjekt KI til karakterbegrunnelser ved Universitetet i Agder
Universitetet i Agder har utviklet et verktøy for å bruke KI-systemer som hjelpemiddel til karakterbegrunnelser, basert på et pilotprosjekt. Formålet var å undersøke potensialet for økt kvalitet og tidsbesparelse. I piloteringen av prosjektet ble eksamensbesvarelsene lastet inn i et lukket system basert på GPT-4, sammen med eksamensoppgaven og sensorveiledning, for å generere et utkast til en begrunnelse. I neste fase ble også karakteren matet inn. Når KI-systemet har generert et utkast til karakterbegrunnelse, gjennomgår og tilpasser sensor den. Ingen av sensorene som deltok i de første testene rapporterte at de hadde brukt mer tid, og flere hadde brukt mindre tid. KI-systemets utkast ble vurdert av sensorene som relevante og brukbare, men måtte redigeres. En mangel var gode tilbakemeldinger på studentenes kritiske refleksjoner. Universitetet fant også at kvaliteten på KI-systemets utkast gjenspeilet kvaliteten på sensorveiledningen: Verktøyet ga bedre utkast til karakterbegrunnelser under klare instrukser. Alle sensorer som deltok i prosjektet, var positive til å fortsette og videreutvikle systemet. Verktøyet ble satt i drift våren 2026, åpent for alle sensorer ved universitetet.
Kvaliteten på verktøyet har mye å si for alle fordelene og ulempene KI-genererte karakterbegrunnelser kan gi. I likhet med sensur, gir teknologiutviklingen et større kvalitetspotensial for KI-baserte karakterbegrunnelser. I tillegg kan modeller videretrenes for formålet, herunder fagspesifikt, noe som høyner potensialet.
7.11.2.2 Juridisk handlingsrom
Etter dagens regler kan sensorer bruke KI-systemer som hjelpemiddel ved egen utarbeidelse av karakterbegrunnelser. For å automatisere karakterbegrunnelse med KI-systemer gir regelverket et avgrenset, men likevel større handlingsrom enn ved automatisering av sensur. Begrensningene og vilkårene er beskrevet nærmere i det følgende.
Sensorkrav
Studenter har rett på karakterbegrunnelse, jf. uhl. § 11-8. Forarbeidene til regelen legger til grunn at karakterbegrunnelsen utarbeides av de(n) sensoren(e) som gjennomførte sensuren. Automatiserte karakterbegrunnelser med KI-systemer er derfor ikke mulig etter dagens regler.42 Forvaltningsloven § 25 stiller derimot ikke krav til menneskelig utarbeidelse av begrunnelser.
Krav til karakterbegrunnelser
Begrunnelsen «skal inneholde de generelle prinsippene som er lagt til grunn for sensurvedtaket, og vurderingen av studentens prestasjon» etter uhl. § 11-8 siste ledd. Dermed skal begrunnelsen redegjøre for den konkrete sensurvurderingen, både om innhold og form. Den skal sette studenten i stand til å se sine prestasjoner i lys av læringsmålene til emnet. Hovedformålet med begrunnelsen er at den skal gi studenten grunnlag for å vurdere om den skal klage på karakteren, og dermed bidra til å gjøre vurderingen etterprøvbar (Prop. 126 L (2022–2023), særmerknad til § 11-8). Etter dagens regulering må altså KI-støttede karakterbegrunnelser, på lik linje med sensors egenproduserte begrunnelser, gjengi de reelle vurderingene som lå til grunn for sensuren.
KI-systemers evne til å generere karakterbegrunnelser
Hvorvidt det er juridisk forsvarlig å bruke KI-systemer til å generere automatiserte karakterbegrunnelser avhenger både av hvorvidt gjeldende rett er oppfylt og hva det aktuelle KI-systemet er i stand til. Det rettslige handlingsrommet for automatisering er tett knyttet opp til hva som er teknisk mulig, og dermed avhengig av teknologiutviklingen (jf. kapittel 4.3.2.).
En KI-generert begrunnelse kan gi en indikasjon på hvorfor karakterfastsettingen ble som den ble, men begrunnelsen vil ikke, ontologisk sett, være sensorens. Siden forarbeidene til uhl. § 11-8 legger til grunn at begrunnelsen utarbeides av sensor, kan KI-systemer i dag kun brukes som et hjelpemiddel. Det kreves altså en lovendring dersom det skal være mulig å automatisere karakterbegrunnelser med KI-systemer.
Sett bort fra at den ikke nødvendigvis samsvarer med sensors egne vurderinger, er det et videre spørsmål om en KI-generert karakterbegrunnelse kan innfri de andre kravene til karakterbegrunnelser. Etter uhl. § 11-8 og forarbeidene til regelen må KI-begrunnelsen kunne ivareta juridisk riktige hensyn. Nærmere bestemt må den kunne gi en realistisk og logisk vurdering av studentens prestasjon i samsvar med vurderingskriteriene i sensorveiledningen og den fastsatte karakteren. Selv om det er sensor og ikke KI-systemet som har satt karakteren, kan et tilstrekkelig godt KI-system gi en like god forklaring på hvordan karakteren følger av besvarelsen og vurderingskriteriene. Kravene til individuell vurdering tilsier at det trengs svært gode systemer dersom en helautomatisert løsning skal kunne oppfylle disse kravene.
Merk at KI-systemers evne til å generere karakterbegrunnelser må holdes adskilt fra spørsmål om KI-systemers forklarbarhet og etterprøvbarhet. De juridiske rammene for bruk av KI-systemer og automatisert saksbehandling inneholder egne krav til datadrevne systemers forklarbarhet (jf. kapittel 4.3.4).43 Forklarbarheten til et KI-system handler om hvorvidt vi eller KI-systemet selv kan forklare hvordan gitte utdata blir skapt på grunnlag av gitte inndata. Anvendt på karakterbegrunnelser handler dette om hvordan innholdet i karakterbegrunnelsen ble skapt av KI-systemet på grunnlag av dataene som ble gitt til systemet. I praksis kan det være at disse to – en forklaring på en begrunnelse og begrunnelsen i seg selv – glir over i hverandre, men de må likevel her skilles fordi de dreier seg om ulike juridiske krav.
Automatiserte karakterbegrunnelser
En automatisert karakterbegrunnelse utgjør potensielt en automatisert individuell avgjørelse etter GDPR art. 22. Begrepet «avgjørelse» er i denne konteksten bredere enn «enkeltvedtak»: Det omfatter både avgjørelser med rettsvirkning og avgjørelser som «på tilsvarende måte i betydelig grad påvirker vedkommende», for eksempel at avgjørelsen «betydelig påvirker den berørtes situasjon, atferd eller valg» (European Data Protection Board, 2018, s. 22, utvalgets oversettelse). Denne definisjonen medfører at prosessledende handlinger som ikke er enkeltvedtak, kan være «avgjørelser» (se kapittel 4.3.4.).
Hovedargumentet mot at karakterbegrunnelser utgjør en avgjørelse etter GDPR art. 22, er at dagens karakterbegrunnelse gis etter at karakteren er fastsatt. Gis karakterbegrunnelsen av et KI-system, er den frikoblet fra sensors oppfatning og påvirker dermed ikke karakterfastsettelsen. Hovedargumentet for er at den skal sette studenten i stand til å vurdere om det er grunnlag til å påklage karaktervedtaket, som kan føre til at karakteren settes opp eller ned. I tillegg skal en begrunnelse gjøre det mulig å ettergå vurderingene i sensuren. Dersom det er utfordrende å begrunne karakteren, kan det være tegn på at sensuren bør justeres. I så måte påvirker begrunnelsen studentens rettigheter, og kan falle under GDPR art. 22.44
Utvalget legger til grunn at karakterbegrunnelser oppnår terskelen om å «i betydelig grad» kunne påvirke sensurvedtaket gjennom studentens klageadgang. Derfor bør det tas høyde for at automatiserte karakterbegrunnelser er omfattet av GDPR art. 22s definisjon av «avgjørelser».45 Dette innebærer at automatiserte karakterbegrunnelser vil kreve en særlig lovhjemmel etter ny forvaltningslov § 11 tredje ledd. Gjøres det, gir ny forvaltningslov § 12 studenten rett til en nærmest umiddelbar forklaring, til å fremme sine synspunkter om begrunnelsen, samt rett til å be om en manuell kontroll. Dette kan for eksempel være relevant dersom KI-begrunnelsen fremstår feil eller misvisende.46
Merk at bruk av KI-systemer som hjelpemiddel til utarbeidelse av karakterbegrunnelser ikke er omfattet av kravene om automatiserte avgjørelser etter GDPR art. 22 og ny forvaltningslov §§ 11 til 13, da disse kun gjelder ved automatisering.
Forsøk med automatiserte karakterbegrunnelser
Universitets- og høyskoleloven § 17-1 gjør det mulig å søke departementet om tidsavgrensede unntak fra andre bestemmelser i universitets- og høyskoleloven, for å kunne gjennomføre tidsavgrensede pedagogiske og organisatoriske forsøk. Denne hjemmelen kan gjøre det mulig å få unntak fra sensorkravet som ligger til grunn for uhl. § 11-8 (se ovenfor).
Det er imidlertid uklart om et slikt unntak kan gis, gitt hvordan automatisert saksbehandling er regulert av ny forvaltningslov § 11 jf. GDPR art. 22. Ny forvaltningslov § 11 andre ledd fastsetter at en avgjørelse ikke kan treffes automatisert dersom det rettslige grunnlaget som avgjørelsen bygger på, er til hinder for det. Bestemmelsens tredje ledd krever at det foreligger en særlig hjemmel for å fatte automatiserte avgjørelser omfattet av GDPR art. 22. Denne hjemmelen kan gis i forskrift. Handlingsrommet avhenger blant annet av hvorvidt karakterbegrunnelser er å regne som avgjørelser etter GDPR art. 22 (se ovenfor).
Karakterbegrunnelser og høyrisiko KI-systemer
Et annet spørsmål er hvorvidt KI-genererte karakterbegrunnelser, samt KI-systemer som utarbeider forslag til sensor, utgjør et høyrisikosystem etter KI-forordningen. Der de ovennevnte reglene i GDPR art. 22 om automatiserte avgjørelser skal vurderes i forhold til effekten bruk av KI-systemer har (rettsvirkning), er KI-forordningens høyrisikoklassifisering formålsbasert. Det betyr at den omfatter alle KI-systemer som har som formål å brukes til å evaluere læringsutbytte, inkludert systemer for tilbakemeldinger og evaluering i en summativ vurderingskontekst (EU-kommisjonen, 2026d, avsnitt 220–225 med eksempler). Dermed faller KI-systemer ment for karakterbegrunnelser inn under høyrisikokategorien.47 Ved bruk av KI-systemer som hjelpemiddel til karakterbegrunnelser, er det er imidlertid noe usikkert hvorvidt KI-forordningens krav til høyrisikosystemer gjelder. Dette medfører at KI-forordningens krav til høyrisikosystemer må oppfylles også for KI-begrunnelser, herunder systemkravene til transparens, forklarbarhet og etterprøvbarhet, og kravet om menneskelig kontroll (se Boks 4.3). KI-systemet må være utformet slik at det skal generere logger, med et egnet sporbarhetsnivå (KI-forordningen art. 12 nr. 2, jf. art. 26 nr. 6).48 Institusjonen (idriftsetter) må også føre menneskelig tilsyn (KI-forordningen art. 26 nr. 2).
Videre gjelder hensynene til personvern og opphavsrett (jf. kapittel 7.11.1.2).49
7.11.2.3 Utvalgets vurdering
Utvalget har vurdert hvorvidt KI-systemer egner seg til å generere automatiserte karakterbegrunnelser eller til å bistå sensorer med å utarbeide utkast til karakterbegrunnelser. I vurderingen legger utvalget vekt på at et av karakterbegrunnelsenes hovedformål er å sette studenten i stand til å vurdere om hen burde påklage karakteren eller ikke.
Utarbeidelsen av karakterbegrunnelser er en tidkrevende oppgave for sensorer om den skal bli gjort godt; og den skal utføres innenfor en to-ukers frist. Dette er spesielt utfordrende i emner med mange studenter. Som en konsekvens er kvaliteten på karakterbegrunnelser variabel. Når den er god, kan det være fordi sensor har brukt mer tid enn hva som er bærekraftig.
Andelen studenter som ber om karakterbegrunnelser økte etter at det ble teknisk enkelt å sende forespørsel. Studenter ønsker både å forstå karakteren de har fått og om de bør klage eller ikke. Flere studenter ønsker også tilbakemelding for å øke eget læringsutbytte.
Utvalget mener dagens system for karakterbegrunnelser ikke fungerer godt, der sensorer blir tvunget til å velge mellom bærekraftig tidsbruk og det å gi gode, meningsfulle begrunnelser av komplekse, skjønnsmessige vurderinger. Det at karakterbegrunnelser gis etterskuddsvis, på forespørsel, betyr at momentene som gis i karakterbegrunnelsen ikke nødvendigvis er identiske med de sensoren vektla da karakteren ble fastsatt. Samtidig ville det betydd at uforholdsmessig mye ressurser gikk til karakterbegrunnelser, dersom de ble gitt samtidig med vedtaket, for alle studenter.
Utprøvinger har vist at KI-systemer i mange fag kan utarbeide karakterbegrunnelser som gir studenter en grundig forklaring av karakteren ved å vurdere eksamensbesvarelsen opp mot oppgaven og sensorveiledningen, eventuelt supplert av sensors notater. Dette er noe studenter i utgangspunktet selv kan be et KI-system om, men en slik praksis gir dem ingen kvalitetssikring.
Utvalget vurderer at det er mulig å utvikle KI-systemer som i de fleste fag vil kunne gi tilfredsstillende automatiserte begrunnelser av studentenes karakterer. Forutsetningene for dette er at modellene er tilstrekkelig gode, at systemet som brukes har en egnet innretning og at det gis tilstrekkelig klare og presise sensorveiledninger. KI-systemer kan da gi detaljerte begrunnelser som anvender vurderingskriteriene i sensorveiledningen på studentens besvarelse. Det kan gi studenten et tilstrekkelig godt grunnlag for å vurdere om hen skal påklage sensuren. Med hensyn til målet om at karakterbegrunnelsen skal gi studenten en bedre forståelse av egen prestasjon, kan et KI-system gi mer detaljerte tilbakemeldinger enn hva en menneskelig sensor i de fleste tilfeller kan ta seg tid til. Videre kan det bidra til mer konsistent kvalitet mellom karakterbegrunnelser.
Dersom man får utviklet gode systemer for KI-genererte karakterbegrunnelser, forblir det problematisk at begrunnelsen har en annen avsender enn den som satte karakteren. Et KI-system vil ikke med noen form for sikkerhet kunne gjengi de momentene som sensor la vekt på da karakteren ble fastsatt. Dette er problematisk fordi det unntar sensor fra å forsvare vedtaket hen har truffet overfor dem vedtaket gjelder.
Til tross for dette kan en KI-generert karakterbegrunnelse likevel «gjøre studenten i stand til å se sine prestasjoner i lys av målene institusjonen har satt for besvarelsen, og gi grunnlag for studenten til å vurdere om det er grunn til å klage på karakteren.» (Prop. 126 L (2022–2023), pkt. 23.11.8).
Selv om KI-systemet er en annen avsender enn den som har fastsatt karakteren, kan studentene få karakterbegrunnelser av høy nok kvalitet og med større detaljgrad. Utvalget mener at KI-genererte karakterbegrunnelser vil kunne oppfylle de viktigste funksjonene til karakterbegrunnelser, i tillegg til å gi en betydelig effektiviseringsgevinst.
På grunnlag av dette gir utvalget en betinget anbefaling om å åpne for automatiserte karakterbegrunnelser. Anbefalingen er betinget i den betydning at utvalget mener kunnskapsgrunnlaget først må bli bedre enn det er i dag. For å åpne opp for automatiserte karakterbegrunnelser med KI-systemer, bør studenter bli satt i tilnærmet like gode stand til å vurdere om de har grunn til å klage på karakteren, som de hadde vært med sensors egen karakterbegrunnelse.
Å gjøre automatisering mulig krever en endring av sensorkravet som ligger til grunn for uhl. § 11-8. Reglene bør åpne institusjonenes handlingsrom, altså bør reglene legge til rette for at karakterbegrunnelser kan gis både manuelt og automatisert. Så sant karakterbegrunnelser er å regne som «avgjørelser» etter GDPR art. 22, vil det å åpne for automatiserte karakterbegrunnelser også kreve en særlig hjemmel (ny forvaltningslov § 11 tredje ledd).
Større, selvstendige arbeider som masteroppgaver, og andre emner med stort omfang, krever omfattende studentarbeid og ofte veiledning. For disse mener utvalget at det er rimelig å beholde et sensorkrav. Reglene bør også ta høyde for at ikke alle typer arbeider kan vurderes av tilgjengelige KI-systemer. I dag vil for eksempel flere muntlige, praktiske og utøvende eksamener falle i denne kategorien. I tråd med dette kan muligheten for automatiserte karakterbegrunnelser også avgrenses fra bestemte oppgaveformater.
Det vil være nødvendig å først gjennomføre utbredt testing av KI-systemer for begrunnelser, utover det som er gjort per i dag. Det kan gjøres gjennom ulike typer forsøk. Det er mulig å gjøre forsøk med KI-genererte karakterbegrunnelser som kan hentes ut, uten at man dermed fratar studentene retten til å få sensors egen karakterbegrunnelse. Slike forsøk kan gi informasjon om hva som skjer med mengden begrunnelseskrav og klagesaker når studentene får tilgang på KI-genererte karakterbegrunnelser. Forsøkene kan også suppleres med undersøkelser av hvor godt studentene opplever at KI-genererte karakterbegrunnelser fungerer sammenliknet med sensors. Slike forsøk vil imidlertid ikke kunne gi full informasjon om hvordan automatiserte karakterbegrunnelser vil fungere i praksis. Det er derfor ønskelig å åpne for tidsavgrensede forsøk med automatiserte karakterbegrunnelser.
Utvalget anbefaler sentrale myndigheter å legge til rette for at det kan gjennomføres forsøk med automatiserte karakterbegrunnelser. Det betyr blant annet å avklare hvorvidt karakterbegrunnelser er å regne som avgjørelser etter GDPR art. 22 og ved behov få på plass nødvendige hjemler i lov eller forskrift. Hvis det er forenlig med kravene i ny forvaltningslov, bør Kunnskapsdepartementet kunne innvilge søknader om forsøk med automatiserte karakterbegrunnelser. Den kommende KI-loven vil også kunne gi muligheter for forsøk (KI-forordningen art. 57–61).
Gjennom slike forsøk kan man også vinne erfaring med de juridiske kravene til KI-genererte karakterbegrunnelser. Dette regnes som høyrisiko etter KI-forordningen, noe som blant annet innebærer et krav om menneskelig kontroll. KI-systemet som anvendes må også være et lukket system med kontroll på dataene. Utvalget legger til grunn at automatisering medfører rettighetsskranker for studentene etter ny forvaltningslov §§ 11 til 13, som kan være med å styrke tillitten. Med KI-begrunnelsen skal det følge med en automatisert forklaring om hvordan KI-systemet kom fram til begrunnelsen, studentene har rett til å be om en manuell kontroll av sensor, og rett til å fremme sine synspunkter.
Som et alternativ har utvalget vurdert om tilsvarende fordeler kan oppnås ved å bruke KI-systemer som et hjelpemiddel og en beslutningsstøtte for sensor. En slik løsning vil ikke gi den samme effektiviseringsgevinsten som automatiserte karakterbegrunnelser. En annen ulempe med KI-systemer som brukes til å lage forslag til sensor, er at sensor kan godkjenne et plausibelt utkast til karakterbegrunnelse som ikke nødvendigvis er sensors gjengivelse, noe som vil være vanskelig å oppdage. Det kan argumenteres for at KI-forslag til sensorbegrunnelser er etisk mer utfordrende enn automatiserte KI-begrunnelser: Det taler for automatisering at det ikke maskerer hva som er bidraget til sensor og hva som er bidraget til et KI-system.
Regelverket for automatisert saksbehandling i ny forvaltningslov er under utvikling, og Justis- og beredskapsdepartementet skal foreslå nærmere regler i forskrift. Å automatisere begrunnelser uten å automatisere enkeltvedtak kan være en nærliggende løsning som kan effektivisere flere saksbehandlingsprosesser. Utvalget vil derfor anbefale sentrale myndigheter å ta høyde for denne muligheten.
7.12 Anbefalinger
Utvalget anbefaler universiteter og høyskoler å
-
sørge for at fagmiljøene gjør regelmessige, KI-bevisste vurderinger av studietilbudenes vurderingsaktiviteter
-
gjøre større bruk av kontrollerte eksamensformer
-
supplere selvstendige arbeider og andre ikke-kontrollerte eksamener med en kontrollert eksamensdel. Institusjonene bør da gjøre en samlet vurdering av hvilket læringsutbytte kandidaten har oppnådd.
-
rendyrke det formative formålet med arbeidskrav
-
utnytte mulighetene KI-systemer gir for læringsfremmende tilbakemeldinger på studentenes arbeid, som et supplement til underviseres tilbakemeldinger
-
gjøre den muntlige delen av kombinasjonseksamener etterprøvbar for å sikre klagerett
-
gjøre forsøk med KI-systemer til ikke-gjeldende karaktersetting, parallelt med menneskelig sensur som gjeldende vedtak, for å utvikle kunnskap om hvilken rolle KI-systemer kan ha i sensur
-
inkludere et forbud mot skjult eller uregulert bruk av KI-systemer til sensur i sensoravtaler
-
gjøre forsøk med KI-genererte karakterbegrunnelser som et supplement til karakterbegrunnelser utarbeidet av sensor, for å undersøke hvor godt KI-genererte karakterbegrunnelser kan ivareta hensikten med karakterbegrunnelser
Utvalget anbefaler sentrale myndigheter å
-
følge med på utbredelsen av korte hjemmeeksamener og vurdere strengere regulering eller sterkere styring dersom ikke andelen avtar vesentlig
-
sørge for bedre tilgang til statistikk om vurderingsformer, i samråd med institusjonene
-
gjennomgå lovens bestemmelser om klage og sensur ved kombinasjonseksamener, herunder endre universitets- og høyskoleloven § 11-11 fjerde ledd
-
legge til rette for at det kan gjennomføres tidsavgrensede forsøk med automatiserte karakterbegrunnelser ved hjelp av KI-systemer
-
sørge for at forskriftsreglene som blir utviklet om automatisert saksbehandling, med hjemmel i ny forvaltningslov, tar høyde for muligheten for å automatisere begrunnelser uavhengig av vedtak
-
lage en hjemmel for automatiserte karakterbegrunnelser i tråd med gjeldende regler for automatisert saksbehandling, på den betingelse at det kan fremstilles et kunnskapsgrunnlag som viser at KI-genererte karakterbegrunnelser kan sette studentene i tilnærmet like god stand til å vurdere om de skal klage på et sensurvedtak som karakterbegrunnelser utviklet av sensor selv
8 Forvaltning av KI-systemer
8.1 Innledning
De foregående kapitlene gir en vurdering av mulighetene og utfordringene som kunstig intelligens (KI) stiller for hva studentene skal lære, hvordan de skal lære og hvordan læringsutbyttet skal prøves. Dersom universiteter og høyskoler skal dra nytte av mulighetene KI gir høyere utdanning, må studenter og ansatte ha tilgang på KI-systemer. Det kan de få gjennom anskaffelser eller gjennom at institusjonen selv utvikler systemene. Dette reiser spørsmål om hvilke KI-systemer som har konkret nytte, og som tjener de overordnede formålene med høyere utdanning (jf. kap. 2).
Forvaltning av KI-systemer reiser også en rekke problemstillinger av strategisk, etisk og juridisk art. En god forvaltning ivaretar bl.a. personvernet, datasikkerheten, opphavsretten, norsk fagspråk og idealet om lik tilgang på verktøy, og den begrenser leverandøravhengighet og sårbarhet.
Et videre spørsmål er hva slags ansvar og handlingsrom den enkelte institusjon skal ha og hva som skal organiseres som fellesløsninger for sektoren, eventuelt hva som er egnet for sektorovergripende eller internasjonale løsninger. Den teknologiske så vel som den politiske og regulatoriske utviklingen på feltet går raskt, med pågående politikkutviklingsinitiativ og spørsmål som ennå ikke er rettslig avklart. Dette gjelder blant annet opphavsrettslige spørsmål, gjennomføringen av EUs KI-forordning, initiativer for sterkere digital suverenitet og organiseringen av en nasjonal KI-infrastruktur i Norge.
Kapittelet er avgrenset til forvaltning av KI-systemer i høyere utdanning, forstått som styring, anskaffelse, utvikling og drift av KI-systemer. Samtidig kan ikke forvaltningen skilles helt fra læring, undervisning og vurdering. Tvert imot er det et viktig poeng at forvaltningen av KI-systemer må utformes i lys av hvordan teknologien påvirker kjerneoppgavene i høyere utdanning.
Utvalget legger i dette kapittelet til grunn at generative KI-systemer vil forbli relevant for høyere utdanning i overskuelig fremtid. Antakelsen er ikke at dagens konkrete verktøy vil bestå, men at språkmodellbaserte og andre generative KI-tjenester vil være tilgjengelige, økonomisk interessante og i stand til å løse oppgaver som er relevante for høyere utdanning.
Kapittelet innledes med en oversikt over status for bruk av utdanningsrelevante KI-systemer i universitets- og høyskolesektoren samt innspill til utvalget i 8.2. I kapittel 8.3 beskrives dagens forvaltning av digitale fellestjenester og datainfrastrukturer i universitets- og høyskolesektoren. Utvalget gir sin vurdering av høyere utdannings behov for KI-systemer i 8.4. Deretter drøftes hvilke hensyn forvaltningen av KI-systemer bør ivareta i 8.5. Avslutningsvis gir utvalget konkluderende vurderinger av hvordan forvaltningen av KI-systemer bør innrettes i 8.6, med anbefalinger opplistet i 8.7.
8.2 Status i universitets- og høyskolesektoren
Lanseringen av ChatGPT i november 2022 innledet en prosess hvor KI-systemer raskt gikk fra å være nisjeverktøy til å bli en integrert del av studiehverdagen for de fleste studenter og undervisere. Tall fra Studiebarometeret viser at 90 prosent av studentene i Norge brukte KI-systemer i studiearbeidet i 2025 (HK-dir, 2026b). Mens en del av studentenes bruk trolig skjer uten at institusjonen er innblandet, har også institusjonene og Sikt – kunnskapssektorens tjenesteleverandør (heretter omtalt som Sikt) utviklet og anskaffet KI-systemer som de stiller til disposisjon for studenter og ansatte.
8.2.1 Kartlegging av bruk knyttet til utdanningsrelevante KI-systemer i universitets- og høyskolesektoren
Høsten 2025 gjennomførte utvalget en kartlegging av bruk (og behov) knyttet til utdanningsrelevante KI-systemer i universitets- og høyskolesektoren.50 Ni institusjoner svarte på undersøkelsen. Svarene viser at institusjonene tilbyr flere utdanningsrelevante KI-systemer til studentene, hovedsakelig i form av generative samtale- og skriveassistenter, transkriberingsverktøy og fagspesifikke analyseverktøy. De mest utbredte tjenestene som tilbys kostnadsfritt til studenter og ansatte, er Microsoft Copilot, Sikt KI-chat og GPT UiO, supplert med blant annet Whisper-baserte transkriberingstjenester og ulike støtteverktøy for akademisk arbeid. Flere institusjoner tilbyr også programmerings- og designverktøy med KI-funksjonalitet eller egne beregningsressurser for lokale språkmodeller.
Alle institusjonene oppgir at de legger til grunn at brukerdata og samtalehistorikk ikke skal brukes av eksterne leverandører til videre trening av språkmodeller, noe som i stor grad er tillitsbasert. Lagring av data skjer på ulike måter, hos leverandør, på egne servere eller i amerikanske skytjenester. Personvern og datasikkerhet ivaretas gjennom innloggingstjenesten FEIDE, databehandleravtaler og lokale retningslinjer. Samtidig varierer bruken av KI betydelig mellom institusjonene. Noen har tatt i bruk KI-funksjoner i læringsplattformene og prøver ut KI-systemer i vurdering og sensurarbeid, mens større universiteter som Universitetet i Oslo (UiO) og Norges teknisk-naturvitenskapelige universitet (NTNU) har bygget opp egne utviklingsmiljøer og infrastruktur som muliggjør mer avansert og lokalt tilpasset bruk.
8.2.2 Innspill fra universiteter, høyskoler og Sikt
Utvalget har mottatt flere innspill om forvaltningsrelaterte tema fra universiteter, høyskoler og Sikt, blant annet gjennom nevnte kartlegging. Innspillene til utvalget viser bred enighet om at det er behov for å kombinere nasjonale rammer med lokal fleksibilitet. Behovet for fellesløsninger og tilgang til språkmodeller trekkes særlig frem av mindre og mellomstore institusjoner. Videre peker disse institusjonene på utfordringene med manglende kompetanse innenfor jus og sikkerhet. NTNU fremhever at institusjonene i dag gjør mange av de samme vurderingene hver for seg, og etterlyser derfor felles samarbeidsarenaer, rådgivningstjenester og vurderingsrammeverk for KI-systemer. NTNU mener derfor at det bør legges til rette for en modell som kombinerer nasjonale rammer med institusjonell frihet til lokale valg og prioriteringer, og peker på at store, felles sektorløsninger kan være krevende å realisere når behov og modenhet varierer. UiO understreker behovet for nasjonale KI-systemer og større investeringer, i egen infrastruktur for å kunne håndtere sensitive data på en sikker måte. Sikt viser til at anskaffelse og drift av KI-løsninger stiller høyere krav til personvern- og risikovurderinger enn tidligere, og mener fellesanskaffelser og delte vurderinger kan gi både bedre kvalitet og lavere kostnader for sektoren. Flere UH-institusjoner oppfordrer til strategisk og målrettet arbeid for bærekraftige løsninger.
8.3 Dagens forvaltning av digitale fellestjenester og datainfrastrukturer i universitets- og høyskolesektoren
8.3.1 Styringsprinsipper
Norsk høyere utdanning er kjennetegnet av en kombinasjon av statlig styring, institusjonelt selvstyre og akademisk frihet. Universitets- og høyskoleloven bygger på at institusjonene skal ha stor grad av selvstyre og akademisk frihet, samtidig som loven fastsetter overordnede rammer og nasjonale hensyn, blant annet knyttet til studentenes rettssikkerhet, like muligheter og utvikling av norsk fagspråk. Styret ved institusjonene har ansvar for intern organisering. Statlige universiteter og høyskoler er forvaltningsmessig underlagt Kunnskapsdepartementet.
Digitalisering omtales i styringsmeldingen (Meld. St. 19 (2020–2021), kap 4.5) som et viktig organisatorisk og styringsmessig område i sektoren. Digitale infrastrukturer og IT-tjenester er avgjørende for forskning, utdanning og administrasjon, og sektoren har utviklet et omfattende samarbeid om digitale løsninger. Styringen av digitalisering i universitets- og høyskolesektoren kan forstås som en kombinasjon av statlig styring og sektorsamarbeid. En sentral utfordring er å opprettholde balansen mellom nasjonal samordning og institusjonell autonomi. Fellesløsninger kan bidra til effektiv ressursbruk og bedre kvalitet. Samtidig kan for sterk sentralisering redusere institusjonenes fleksibilitet og innovasjonsevne, noe som over tid kan gå ut over tjenestekvaliteten.
8.3.2 Styring av digitalisering og forvaltning av fellestjenester og infrastruktur
I årene 2017–2025 har Kunnskapsdepartementet i hovedsak styrt digitaliseringsområdet gjennom overordnede sektorstrategier med tilhørende handlingsplaner, og to direktorater: HK-dir og Sikt. Førstnevnte hadde ansvar for å følge opp strategien i samarbeid med sektoren, og Sikt er leverandør av digital infrastruktur og fellestjenester. Den siste sektorstrategien er ikke videreført i 2026.
Det er etablert en relativt omfattende samstyringsmodell for samarbeid mellom institusjonene og HK-dir/Sikt (HK-dir, u.å.). Samstyringsmodellen, som for tiden er under revisjon, skal sikre innflytelse og brukerinvolvering fra institusjonene i Sikts arbeid med anskaffelser, utvikling og drift av digitale fellestjenester. HK-dirs kartlegging av arbeid med digital omstilling av UH-sektoren viser at digitalisering i økende grad er integrert i den ordinære virksomheten (HK-dir, 2026d, s. 9). Digitaliseringen er altså ikke lenger et anliggende kun for IT-avdelingene; flere deler av organisasjonen tar nå eierskap til temaet, og det er mer innarbeidet i virksomhetsstyringen.
Ifølge HK-dirs kartlegging er KI en sentral drivkraft i institusjonenes digitale omstilling. Aktivitetsnivået på KI-området må beskrives som høyt, og er særlig rettet mot å styrke grunnleggende KI-kompetanse og sikre etisk og juridisk forsvarlig bruk.
8.4 Utvalgets vurdering av høyere utdannings behov for KI-systemer og KI-relevante ressurser
For at høyere utdanning skal lykkes i møte med KI har det mye å si hvordan KI-systemer tas i bruk, men det har også mye å si hvilke systemer som utvikles og tas i bruk. Systemene bør være egnet til å støtte læring, vurdering eller ha annen utdanningsfaglig nytte.
Språkmodeller er relevante for alle fag i høyere utdanning. Språkmodellbaserte KI-systemer kan tjene som læringsassistenter som kan forklare faglig innhold og gi tilbakemeldinger og veiledning til studentene. For å fylle denne funksjonen godt, bør systemene fremme læring. En generisk samtalerobot gjør ikke nødvendigvis det, ettersom den kan servere ferdige produkter, endringsforslag og svar på spørsmål, heller enn å stimulere studentene til å tenke selv (jf. kap. 6). Tilsvarende kan agentiske systemer som Claude Code og Codex generere velfungerende programkode heller enn å stimulere til bedre forståelse av programmeringsspråk og ferdigheter til å løse oppgaver med dem.
Vanlige samtaleroboter kan instrueres til å gi mer læringsfremmende responser. Det er likevel mye å forvente av studentene at hver og en skal ta ansvar for å tilpasse studieverktøyene de får tilgang til, slik at de gir nytten de er ment å gi. Dette tilsier et behov for språkmodellbaserte systemer som har en pedagogisk innretning. Slike systemer har også nytte for undervisere som støtte i utførelsen av egne oppgaver, som å gi tilbakemeldinger på studentenes arbeid.
Hensynet til samfunns- og arbeidslivsrelevans og hensynet til faglig kvalitet tilsier at studenter bør få øvelse i å bruke de verktøyene som har størst nytte i utøvelse av relevante yrker og fag, og som ellers preger samfunnet. Her er det betydelig faglig variasjon. I helsefagene vil for eksempel studentene ha nytte av å utvikle ferdigheter i bruk av profesjonsspesifikke, kliniske verktøy. Videre har språkmodellbaserte systemer nytte i mange fag og yrker, i tillegg til å prege samfunnet i bredt. Det å utvikle fagspesifikke ferdigheter med slike systemer er et viktig læringsutbytte i sin egen rett (jf. kap. 5). Det gir behov for tilgang på kapable KI-systemer, uten at systemene nødvendigvis behøver å ha en pedagogisk innretning. Dette er altså et annet behov enn behovet for systemer som støtter læring.
For å ivareta hensynet til utdanningsfaglig nytte ved anskaffelse eller utvikling av KI-systemer, er det naturlig å involvere de vitenskapelig ansatte. Slik medbestemmelse er også fremhevet i innspill til utvalget, herunder fra Forskerforbundet og Unio sentralt.
KI skaper også behov for maskinell infrastruktur, især for utvikling av KI-modeller, men også i økende grad for drift av dem. Dette innebærer behov for regnekraft og datalagringskapasitet, lokalt eller via eksterne skytjenester. Behovet for regnekraft har tidligere særlig vært forbundet med forskning, men det er også økt behov for regnekraft for utdanningsvirksomheten ved universitetene og høyskolene.
Med KI-utviklingen blir høyere utdanning i økende grad avhengig av komplekse, digitale økosystemer. Disse omfatter både generelle og spesialiserte KI-systemer, integrasjoner mot eksisterende studieadministrative systemer og læringsplattformer, samt underliggende infrastruktur for databehandling. Dette skaper behov for helhetlige systemarkitekturer, der interoperabilitet, sikkerhet og skalerbarhet er sentrale prinsipper. OECD har understreket at tillit i digitale utdanningssystemer forutsetter robuste rammer for datastyring samt løsninger som muliggjør interoperabilitet mellom systemer (OECD, 2023b, s. 292; 130–135).
Boks 8.1 Tjenesteplattformer for generativ KI i norsk universitets- og høyskolesektor
Sikt KI er en KI-tjeneste utviklet og levert av Sikt, til bruk i universitets- og høyskolesektoren samt i videregående opplæring. Sikt KI inneholder tjenestene KI-chat og KI-assistent, og gir tilgang til ulike språkmodeller som de i GPT-serien fra amerikanske OpenAI, franske Mistral og den norske modellen Borealis, utviklet av Nasjonalbiblioteket. KI-tjenesten er tilgjengelig for brukere i kunnskapssektoren via innlogging gjennom Feide eller Entra ID. Behandlingen av personopplysninger gjøres i samsvar med personopplysningsloven og personvernforordningen (GDPR). Samtaler og data blir ikke brukt til videre trening av KI-modeller.
UiO og NTNU samarbeider om å levere tjenestene GPT UiO og GPT NTNU. Samarbeidet omfatter både tjenesteutvikling og datainfrastrukturen som trengs for å drifte tjenestene. GPT NTNU er utviklet av NTNU i samarbeid med UiO og bygger på GPT UiO. Både GPT UiO og GPT NTNU gir brukerne tilgang til et utvalg KI-modeller som kjøres på lokal infrastruktur ved henholdsvis NTNU og UiO. Per i dag gjelder dette modeller med åpne vekter fra blant annet OpenAI, Z.ai, NorwAI, Mistral, Nasjonalbiblioteket og UiOs fagmiljø i språkteknologi. Per i dag gir også begge tjenestene tilgang til proprietære modeller fra OpenAI. Disse driftes gjennom Microsofts skytjeneste, Azure. Alle samtaler og all brukerinfo blir lagret på UiOs servere. Et av formålene med tjenestene er å gi studenter og ansatte tilgang til KI-tjenester med god datasikkerhet og ivaretakelse av personvernet. Begge tjenestene er av institusjonene godkjent for behandling av opp til røde (fortrolige) data.
Universitetet i Bergen og Universitetet i Tromsø – Norges arktiske universitet har også utviklet egne applikasjoner for tilgang til språkmodeller, hhv. UiBchat og ChatUiT.
Kilde: Sikt, UiO og NTNUs nettsider
Blant internasjonale løsninger på dette området fremstår nederlandske eduGenAI og språkmodellen GPT-NL som interessant, se Boks 8.2.
Boks 8.2 Plattformen eduGenAI og språkmodellen GPT-NL
Nederland utvikler den nasjonale digitale plattformen eduGenAI hvor universiteter, høyskoler og fagskoler kan bruke generative KI-modeller på en trygg og kontrollert måte. Som de nevnte norske KI-tjenestene, gir eduGenAI studenter og undervisere tilgang til ulike språkmodeller gjennom ett felles grensesnitt. eduGenAI samler tilgang, kontroll og styring i én felles løsning for hele sektoren. Utviklingen av plattformen finansieres gjennom et nederlandsk digitaliseringsprogram, Npuls, med om lag 10 millioner euro, mens institusjonene betaler for bruken. Personvern, datasikkerhet og etisk bruk er integrert i teknologien. En av modellene som kan bli tilgjengeliggjort gjennom eduGenAI er den egenutviklede språkmodellen GPT NL, som blir trent fra bunnen av på lovlige nederlandske data og med åpen kildekode. Modellen, som er under uttesting i 2026, rettes mot både næringsliv og offentlig sektor, og er ment å bidra til sikkerhet og digital suverenitet. GPT-NL er finansiert av nederlandske myndigheter med 13,5 millioner euro.
Kilder: GPT-NL, u.å.; nPuls, u.å.
Mens Sikt KI er utviklet som en fellestjeneste, er GPT UiO og GPT NTNU i utgangspunktet tjenester laget for egen institusjon. De sistnevnte brukes likevel også av andre institusjoner og er slik sett konkurrerende tjenester. En sammenlikning mellom de norske KI-tjenestene og den nederlandske plattformen eduGenAI viser noe ulike tilnærminger, men ikke vesentlige forskjeller i virkemåte, herunder at det gis tilgang til flere store språkmodeller både med og uten åpne modellvekter. Den nederlandske plattformen i kombinasjon med satsingen på den store nasjonale språkmodellen GPT-NL indikerer at Nederland ønsker å etablere et nasjonalt KI-økosystem for høyere utdanning.
Boks 8.3 Regnekraft og datalagringskapasitet
Å trene en stor språkmodell fra bunnen av krever omfattende regnekraft i form av tungregning (høykapasitetsberegninger). Tungregning er bruk av kraftige datamaskiner og systemer for å utføre komplekse beregninger og analyse av store datamengder som ikke er mulig på vanlige datamaskiner. Bruk av store språkmodeller (inferens) krever også betydelig regnekraft. Det vil i hovedsak være inferens som utgjør behovet for regnekraft for KI-modeller i høyere utdanning. I praksis leveres mye av regnekraften gjennom kommersielle skytjenester, fra datasentre med ulik lokalisering og ulikt eierskap.
Sikt forvalter eierskapet til det statlige aksjeselskapet Sigma2 AS, som er ansvarlig for den nasjonale infrastrukturen for regnekraft i Norge. Sigma2 tilbyr tjenester som tungregning og storskala datalagring for forsknings- og utdanningsformål. Lite av det samlede norske regnekraftbehovet dekkes av datasentre under norsk eierskap og jurisdiksjon.
Mange europeiske land, inkludert Danmark, Sverige og Finland, har investert store beløp i datasentre spesialbygd for KI. Den norske staten har besluttet å bruke 380 mill. kr. over to år (2026–2027) til å starte arbeidet med etablering av en nasjonal infrastruktur for tungregning med utgangspunkt i Sigma2. Gjennom Sigma2 er Norge også med i et konsortium som bidrar til å finansiere, og gir oss tilgang på, superdatamaskinen LUMI i Finland. Som del av dette konsortiet har Norge bidratt med 220 mill. kr. for å bygge en ny superdatamaskin, LUMI-AI.
Kilder: Haeck, 2026; Prop. 1 S (2025–2026), 07.60 Kap. 273; Sigma2, 2026
8.5 Hensyn å ivareta i forvaltning av KI-systemer
Når KI-systemer skal anskaffes og tas i bruk på en forsvarlig måte, er det en rekke hensyn å ivareta som går utover det å møte utdanningsfaglige behov. Dette dreier seg om etiske hensyn, digital suverenitet, rettslige rammer, bærekraft, ivaretakelse av akademisk frihet, akademiske verdier og norsk fagspråk, lik tilgang, kostnadseffektivitet og langsiktig forutsigbarhet.
Boks 8.4 Etiske prinsipper for ansvarlig og pålitelig kunstig intelligens
I regjeringen Støres nasjonale digitaliseringsstrategi vises det til regjeringen Solbergs «Nasjonal strategi for kunstig intelligens» fra 2020, som slo fast syv etiske prinsipper for ansvarlig og pålitelig bruk av kunstig intelligens.
-
KI-løsninger skal respektere menneskets selvbestemmelse og kontroll
-
KI-systemer skal være sikre og teknisk robuste
-
KI skal ta hensyn til personvernet (følge personvernforordningen)
-
KI-systemer må være gjennomsiktige (sporbare, forklarbare og gjennomsiktige)
-
KI-systemer skal legge til rette for inkludering, mangfold og likebehandling (forebygge diskriminerende skjevheter, utvalgsskjevhet (bias) under utviklingen)
-
KI skal være nyttig for samfunn og miljø
-
Ansvarlighet
Disse prinsippene gjelder fortsatt, og supplerer i noen grad eksisterende lover som personopplysningsloven. Prinsippet om ansvarlighet skal ses i sammenheng med de andre prinsippene, og innebærer at det skal innføres mekanismer som sikrer ansvarlighet for løsninger basert på KI og deres resultater. Alle KI-systemer skal ivareta muligheten for revisjon, dvs. gjennomgang og kontroll av at KI-systemene bl.a. oppfyller sikkerhetsmessige krav.
Prinsippene er basert på EUs Ethics guidelines for trustworthy AI. Formålet med EUs retningslinjer var å fremme ansvarlig og bærekraftig utvikling og bruk av kunstig intelligens i Europa.
The Higher Education Authority (HEA) i Irland har utviklet et verdibasert nasjonalt rammeverk for generativ KI i undervisning og læring i høyere utdanning og et eget dokument med fem grunnprinsipper for etisk KI-adopsjon. De fem grunnprinsippene omfatter bl.a. akademisk integritet, transparens, likeverd, inkludering, kritisk engasjement, menneskelig tilsyn, KI-kompetanse, personvern, datastyring samt bærekraftig pedagogikk.
UNESCO og Europarådet presenterer globale rammeverk for KI. UNESCOs anbefaling om etikk innenfor KI legger vekt på menneskerettigheter, verdighet, åpenhet, rettferdighet og menneskelig tilsyn. Europarådets rammekonvensjon for KI, undertegnet av Norge og en rekke land, har som mål å sikre at KI er i samsvar med menneskerettigheter, demokrati og rettsstatsprinsipper.
Kilder: EU Commission High-Level Expert Group on Artificial Intelligence, 2019; Europarådet, 2024; Higher Education Authority, 2025a, 2025b; Kommunal- og moderniseringsdepartementet, 2020, kap. 5.1; UNESCO, 2022
8.5.1 Digital suverenitet
Digital suverenitet handler om staters og institusjoners evne til å ha kontroll over egne data, digitale infrastrukturer og teknologiske valg. KI inngår i en bredere internasjonal konkurranse om økonomisk og strategisk dominans, der USA og Kina leder an. Dette utgjør en geopolitisk kontekst der tilgang til, kontroll over og regulering av KI blir et strategisk spørsmål på linje med energi, forsvar og annen kritisk infrastruktur.
Digital suverenitet er ikke ensbetydende med alenegang og full uavhengighet fra andre aktører. Snarere kan det ses som et digitalt handlingsrom, som evnen til å handle selvstendig og strategisk selv om det ikke er mulig å være selvforsynt med alt av digitale systemer og ressurser for å utvikle dem. I KI-sammenheng betyr det å kunne forme hvordan systemer brukes lokalt, ha reelle alternativer til infrastruktur, modeller og internasjonale partnere, og beholde fleksibiliteten til å tilpasse seg etter hvert som teknologien utvikler seg (Barasa et al., 2026).
8.5.1.1 Leverandøravhengighet og sårbarhet
Virksomheter kan bli avhengige av enkeltleverandører for produkter og tjenester dersom det blir svært kostbart eller teknisk krevende å bytte til andre leverandører, eller dersom det ikke finnes andre leverandører. Blir universiteter og høyskoler leverandøravhengige, vil det redusere deres handlingsrom. Dette gjør dem sårbare for leverandørens prissetting og veivalg. Videre gjør det dem sårbare for beslutningene til myndighetene som har jurisdiksjon over leverandøren. Den amerikanske presidentordren 12. juni 2026 om å suspendere utlendingers tilgang til Anthropics avanserte språkmodell Claude Fable 5, illustrerer hvordan slik sårbarhet kan komme til uttrykk.
For avanserte IT-systemer er leverandøravhengighet en systemisk utfordring. Det skyldes blant annet at produktene og tjenestene ofte er integrert med hverandre, slik at man ikke kan bytte ut et produkt uten å miste funksjonalitet i et annet. En annen viktig grunn er at det i flere tilfeller kun er et fåtall aktører som kan levere tjenestene og produktene. Ifølge forskere fra Epoch står fem skyleverandører – Amazon, Google, Meta, Microsoft og Oracle – til sammen for anslagsvis 71 prosent av verdens samlede regnekraft for kunstig intelligens per fjerde kvartal 2025, målt i H100-ekvivalenter51 (se Figur 8.1). Dette er en økning fra 63 prosent i første kvartal 2024 (Epoch AI, 2026a).
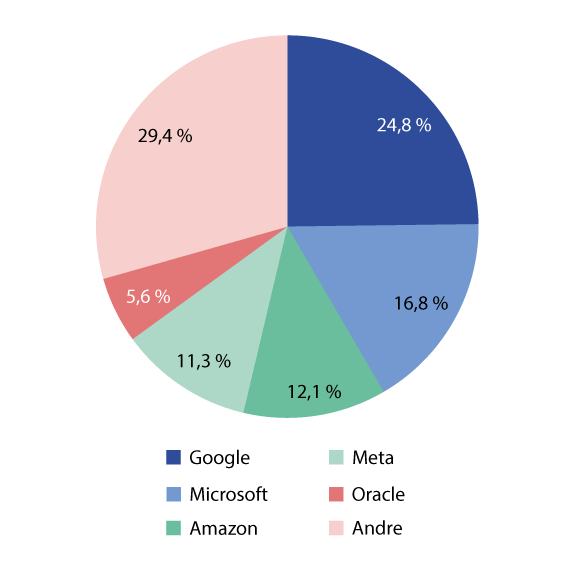
Figur 8.1 Eierskapsandel av verdens samlede regnekraft fra databrikker laget for KI-utvikling, etter Epoch AIs estimat
Kilde: Epoch AI (2026a)
Det er svært ressurskrevende å utvikle store grunnmodeller, med maskinvare, energi og kompetent bemanning som de viktigste innsatsfaktorene. Forskere fra Epoch AI og Stanford University har laget en modell for å regne ut hva det koster å lage grunnmodeller, og funnet at kostnaden for de mest beregningstunge modellene økte 2,4 ganger årlig fra 2016 til 2025 (Cottier et al., 2024). For modeller som i februar 2025 var i utviklingsfronten, anslår de den samlede utviklingskostnaden til over 100 millioner amerikanske dollar. Det er begrenset hvor mange selskaper som kan investere så store summer i utvikling av en enkelt modell, og som i tillegg har tilgang på nødvendig kompetanse. Utviklingsfronten for KI-modeller er også svært konsentrert geografisk sett. Amerikanske og kinesiske selskaper dominerer her.
EU har svart på denne utviklingen med blant annet en pakke for teknologisk suverenitet, som EU-kommisjonen la frem i juni 2026. Den inneholder blant annet et forslag til forordning om sky og KI, med et felles europeisk rammeverk for å vurdere hvor suverene slike tjenester er, og en strategi som prioriterer åpen kildekode i offentlige anskaffelser (EU-kommisjonen, 2026h). Forslagene er ikke vedtatt, og det er uavklart hvilken betydning de får for Norge gjennom EØS-avtalen.
En god forvaltning av KI-systemer begrenser leverandøravhengigheten og sårbarhetene en slik avhengighet innebærer. Hensynet blir desto viktigere å ivareta, jo mer ustabil og spent den geopolitiske situasjonen er. Generelt sett gir en mer spent geopolitikk et mindre trygt grunnlag for å sette sin lit til utenlandske leverandører og myndighetene de er underlagt.
8.5.1.2 Datasikkerhet og personvern
Bruk av generative KI-systemer og store språkmodeller i universitets- og høyskolesektoren innebærer et endret risikobilde for datasikkerhet og personvern. Institusjonenes oversikt og kontroll over egne data, behandlingsprosesser og jurisdiksjon kan bli redusert gjennom bruken av utenlandske skytjenester og sammensatte leverandørkjeder.
Bruk av generative KI-systemer innebærer at data også kan brukes til logging, sikkerhetsanalyse, modellforbedring eller videre trening av språkmodeller. Bruken vanskeliggjør institusjonenes mulighet til kontroll, dokumentasjon og ivaretakelse av personvern- og datasikkerhet. ENISA, EUs byrå for cybersikkerhet, advarer om at KI kan åpne nye veier innen manipulasjon og angrepsmetoder, samt nye utfordringer knyttet til personvern og datasikkerhet (European Union Agency for Cybersecurity, 2020).
En annen side er at cyberangrep og digitale trusler har blitt mer alvorlige som følge av at bl.a. generative KI-systemer gjør det mulig å automatisere og skalere angrep, samt utvikle og tilpasse skadevare raskere enn tidligere (The National Cyber Security Centre, 2025). Dette senker terskelen for cyberkriminalitet, øker omfang og kompleksitet i trusselbildet og stiller større krav til institusjonenes arbeid med informasjonssikkerhet og hendelseshåndtering. KI-agenter, nærmere omtalt i kapittel 3.4.4, reiser sikkerhetsmessige utfordringer dersom agentene gis tilganger til brukerens e-postkonto, dokumenter eller andre interne systemer for å løse en oppgave. Som følge av KI er datasikkerhet ikke lenger begrenset til teknisk sikring av lagring og nettverk, men omfatter styring av komplekse adaptive systemer som løpende behandler og genererer data. Anskaffelse og forvaltning av KI-systemer utløser derfor høye krav til personvern- og risikovurderinger. Vurderingene opplyses å være krevende for mange institusjoner, samtidig som Sikt har gitt uttrykk for at felles anskaffelser eller felles vurderinger på dette området vil være til stor nytte for universitets- og høyskolesektoren.
Det er fortsatt en del personvernrettslig usikkerhet om bruk av KI-systemer til læringsanalyse. Ekspertgruppen bak NOU 2023: 19 konkluderte med at regelverket for høyere utdanning heller ikke gir et tydelig rettslig grunnlag for å behandle personopplysninger i læringsanalyse, slik personvernforordningen krever. Gruppen la frem to forslag. Det første var et nytt ledd i universitets- og høyskolelovens bestemmelse om behandling av personopplysninger (daværende § 4-15). Leddet skulle slå fast at institusjonene kan behandle personopplysninger om studenter ved hjelp av maskinell analyse og sammenstilling når det er etisk og pedagogisk forsvarlig og nødvendig for å oppfylle oppgaver og plikter etter loven. Det andre var en presisering i daværende studietilsynsforskrift § 4-1 om at slike opplysninger kan behandles når det er nødvendig for det systematiske kvalitetsarbeidet, og at graden av personidentifikasjon ikke skal være større enn nødvendig for formålet (NOU 2023: 19, kap. 12.3).
8.5.1.3 Jurisdiksjon
Bruk av internasjonale skytjenester reiser særskilte spørsmål om tredjelandsoverføring og jurisdiksjon. Både fjernaksess fra tredjeland og bruk av internasjonal skyinfrastruktur kan innebære overføring av personopplysninger som må kartlegges og vurderes særskilt (European Data Protection Board, 2020b). Lagring av data innenfor EØS er derfor ikke nødvendigvis tilstrekkelig dersom leverandøren eller underleverandører kan få tilgang til data fra tredjeland. Det europeiske personvernrådet har videre fremhevet at risiko knyttet til myndighetstilgang gjennom ikke-europeiske skyleverandører ofte er identifisert, men ikke tilstrekkelig håndtert teknisk og rettslig.
Problemstillingen aktualiseres blant annet av den amerikanske lovgivningen CLOUD Act, som gir amerikanske myndigheter adgang til å kreve utlevering av data fra amerikanske teknologiselskaper, uavhengig av hvor dataene fysisk er lagret. Lovgivningen er i spenning med GDPR art. 48, som fastsetter at personopplysninger ikke kan overføres til parter utenfor EU uten at det foreligger en formell avtale. Dette illustrerer hvordan jurisdiksjon og leverandørstruktur kan påvirke kontrollen over data.
8.5.1.4 Verdiskaping
Et ytterligere aspekt ved hensynet til digital suverenitet dreier seg om kompetansebygging og næringsutvikling. Dersom man ikke kjøper KI-systemer som er utviklet i Norge, Norden eller Europa – når det er mulig – innebærer det tapte muligheter for å styrke kompetansen som skal til for å utvikle KI-systemer i disse områdene. Tilsvarende gjelder også for andre deler av teknologistabelen, som for eksempel skytjenester. Å handle lokalt eller regionalt bidrar til grunnlaget for lokal og regional kompetanse- og næringsutvikling.
Universitets- og høyskolesektoren er en sentral samfunnsaktør for kunnskapsutvikling, kompetansebygging og innovasjon. Utvikling og drift av egne eller sektorforankrede KI-løsninger kan gi grunnlag for forskning og innovasjon innenfor områder som språkmodeller, utdanningsteknologi, personvern, cybersikkerhet og datainfrastruktur. Dette kan bidra til sterkere fagmiljøer og flere norske arbeidsplasser i høykompetansenæringer.
8.5.1.5 Åpen kildekode og åpne modellvekter
Åpen kildekode er programvare som distribueres under forutsetning av at kildekoden er allment tilgjengelig for brukerne. Brukerne får innsyn i hvordan programvaren fungerer og kan gjøre forbedringer. Åpen kildekode er utstyrt med en lisens som spesifiserer frihetene og bruksrettighetene som følger med programvaren (Gramstad, 2024). I KI-sammenheng kan åpen kildekode innebære at bl.a. programvare, treningsdata, arkitektur og modellvekter er åpne. Full åpenhet kan defineres som muligheten til å studere, bruke og modifisere systemet til ethvert formål (Open Source Initiative, u.å.).
Når det gjelder grunnmodeller for KI, er det mange som er gjort tilgjengelig med åpne vekter, uten at hele kildekoden dermed er gjort åpen. Det betyr at man kan få innsikt i hva slags verdi alle modellens parametere er innstilt på etter trening (vektene), uten at man for eksempel får innsikt i algoritmen som ble brukt for å trene opp modellen. Åpne modellvekter innebærer at modellen kan lastes ned og kjøres lokalt, og at man kan videretrene eller fininnstille modellen for egne formål. Mens de største kinesiske språkmodellene gjennomgående har åpne modellvekter, er situasjonen motsatt i USA, riktignok med flere unntak. Også de store amerikanske teknologiselskapene tilbyr språkmodeller med åpne vekter. Et eksempel på en modellserie med helt åpen kildekode, ikke bare åpne vekter, er Borealis-modellene fra Nasjonalbiblioteket, en modellserie som er spesifikt trent på norske tekster.
KI-systemer med åpen kildekode, herunder åpne modellvekter, kan gjennom lokal drift være fordelaktige for høyere utdanning i en rekke sammenhenger. I tillegg til å kunne styrke digital suverenitet og datasikkerhet, som nevnt over, kan åpen kildekode og lokal drift gi bedre muligheter for forskning og eksperimentering med teknologien, bidra til transparens og åpne for ulike tilpasninger og anvendelser (Lynch, 2026).
8.5.2 KI-forordningen
Forvaltningen av KI-systemer må skje innenfor et sammensatt og foranderlig rettslig landskap, herunder med nye lovgivninger, som EUs KI-forordning (jf. kap. 4.3.2). KI-forordningen etablerer et risikobasert regime for KI-systemer. Når en institusjon anskaffer et KI-system som de tar i bruk og stiller til disposisjon for sine studenter og ansatte, blir institusjonen en idriftsetter etter forordningens betydning. Rollen som idriftsetter kan endres til leverandør dersom man bygger en egenutviklet løsning på andres modeller, som for eksempel Sikt KI-chat og GPT-UiO. Rollen har betydning for hvilke plikter institusjonen pådrar seg og kan medføre betydelige tekniske og administrative kostnader, særlig dersom systemene blir klassifisert som høyrisikosystemer.
8.5.3 Opphavsrett
Generativ KI står i et problematisk og omstridt forhold til opphavsretten (se kap. 4.2.4.2). De store grunnmodellene er trent på store mengder tekst, bilder, kode og andre verk som kan være beskyttet av opphavsrett. De store teknologiselskapene, som OpenAI, Google og Anthropic, er lite åpne om hva som inngår i treningsgrunnlaget for grunnmodellene deres.
Det kan skilles mellom to typer hensyn universiteter og høyskoler kan ta til opphavsretten. For det første må institusjonene ta stilling til hvordan de selv kan overholde opphavsrettslige regler. Dette er en problemstilling som oppstår både ved utvikling og bruk av KI-systemer. Universiteter og høyskoler må for eksempel vurdere om institusjonens, studentenes og de ansattes åndsverk vil brukes til videre modelltrening dersom dette lastes opp i en samtalerobot. For det andre kan institusjonene ta hensyn til hvilken bruk de gjør av produkter og tjenester som er utviklet gjennom brudd på, eller i tvilsom aktelse for, opphavsretten. Det kan være etisk problematisk å anskaffe systemer som har vært utviklet gjennom brudd på opphavsretten, selv om anskaffelsen og bruken av et slikt system ikke selv utgjør et lovbrudd (jf. kap. 4.3.6). Et tilgrensende hensyn er til åpenhet om treningsgrunnlag. Uten informasjon om datasettene som KI-modeller er trent på, blir det svært vanskelig å vurdere hvor godt opphavsretten er respektert, og å kunne fatte beslutninger på det grunnlaget.
8.5.4 Akademisk frihet og akademiske verdier
Akademisk frihet er en grunnleggende og lovfestet forutsetning for universiteters og høyskolers virksomhet. Omfattende bruk av kommersielle KI-systemer kan gripe inn i det faglige innholdet. UNESCO fremhever at bruk av generativ KI i forskning og utdanning må skje på en måte som styrker – og ikke undergraver – akademiske verdier som kritisk tenkning, vitenskapelig integritet og uavhengighet (UNESCO, 2023). Higher Education Authority i Irland legger til grunn at styring av KI må knyttes til formålet med høyere utdanning, læring, faglig arbeid og dømmekraft (Higher Education Authority, 2025b, s. 9–10)
8.5.5 Bærekraft
Universiteter og høyskoler har et lovpålagt ansvar for å bidra til en miljømessig bærekraftig utvikling (universitets- og høyskoleloven § 1-1 bokstav d), og generativ KI medfører et betydelig ressursforbruk knyttet til både utvikling og bruk av modellene. Se nærmere omtale i kapittel 4.
8.5.6 Norsk fagspråk
De store, amerikanske språkmodellene er i hovedsak trent på engelskspråklige datasett. Selv om disse over tid har produsert færre språklige feil og anglisismer når de brukes på norsk, er de fortsatt et godt stykke unna å være feilfrie. Dersom sentrale lærings- og arbeidsprosesser i økende grad formidles gjennom verktøy som primært er utviklet på engelskspråklige data, kan dette bidra til å svekke norsk fagspråk.
I sitt innspill til utvalget understreker Språkrådet at det ikke er noen selvfølge at generativ KI vil gi studenter bedre tilgang til norsk fagspråk. For at KI-systemer skal generere velfungerende norsk fagspråk, må de være trent på norske fagtekster med norsk terminologi. Innenfor mange fagfelt skrives det for få norske tekster til at det finnes et tilstrekkelig treningsgrunnlag for utvikling og videreutvikling av KI-modeller. Konsekvensen kan bli at KI-systemer genererer termer som ikke er forankret i fagmiljøene, som konkurrerer med etablerte termer og som bryter med vanlige mønstre for norsk ordforming. Språkrådet viser også til at Rambølls undersøkelse blant instituttledere avdekket erfaringer med at KI-systemer fungerer dårlig på avansert nivå, når norsk terminologi mangler, og at språket da lett blir «krøkkete» og til dels ubegripelig.
Dersom verktøyene institusjonene gjør tilgjengelig, systematisk produserer svakt norsk fagspråk, kan teknologien over tid svekke studentenes beherskelse av norsk fagterminologi og norske uttrykksmåter.
Høgskulen i Volda peker i sitt innspill til utvalget på at de har et særlig ansvar for å bevare og utvikle nynorsk språk og skriftkultur. De viser til at de store, kommersielle språkmodellene ofte er svakere på nynorsk enn på bokmål og engelsk. Høgskulen i Volda ønsker derfor en felles, nasjonal tjeneste eller infrastruktur der institusjoner kan få tilgang til regnekraft og plattformer for å kunne eksperimentere med egne eller åpne språkmodeller i trygge og lovlige rammer. Dette vil gjøre det mulig å drive nødvendig innovasjon, bl.a. innen nynorskteknologi og mediefag, uten at hver institusjon må bygge opp sin egen infrastruktur.
8.5.7 Likeverdig tilgang
Studenters læringsmuligheter og ansattes arbeidsvilkår bør ikke avhenge av ubegrunnet forskjellig tilgang til faglige ressurser. Dette gjelder også KI-systemer. Samtidig må en slik likhetstanke forstås på en måte som er forenlig med institusjonell autonomi, faglig variasjon og behovet for eksperimentering. Spørsmålet er derfor ikke om alle skal ha identisk tilgang til de samme verktøyene, men hvordan sektoren kan sikre et rimelig og faglig begrunnet nivå av stabil, trygg og rettferdig tilgang.
Ulik tilgang kan i prinsippet oppstå på flere måter. Enkelte institusjoner kan ha råd til å finansiere betalte verktøy med mer avanserte funksjoner, mens andre i større grad er henvist til systemer med svakere funksjonalitet eller høyere risiko. Også innad i institusjonene kan ulikhet oppstå dersom enkelte fagmiljøer eller prosjekter har tilgang til særlige ressurser. For studenter kan dette slå ulikt ut både i læring og i muligheten til å tilegne seg relevant verktøykompetanse.
Kvalitetsforskjeller mellom KI-systemer kan ha betydning både for læringsutbytte og sikkerheten. Kommersielle KI-systemer leveres ofte i ulike versjoner, og det kan være betydelige kvalitetsforskjeller på leveransene fra en gratisversjon av et KI-system sammenlignet med mer avanserte betalingsversjoner.
Manglende tilgang på gode KI-systemer til formålene studenter og ansatte skal bruke dem til, kan også føre til økt bruk av såkalt «skygge-KI»52 med påfølgende risikoer for datasikkerheten, personvernet og opphavsretten.
Opplæring i riktig bruk av KI-verktøy kan være viktigere enn mindre ulikheter i tilgang (Hodøl et al., 2025). Slik opplæring er derfor sentral for å forebygge økte forskjeller og digitale skillelinjer som følge av bruk av KI-systemer (jf. kap. 6).
8.5.8 Kostnadseffektiv ressursbruk
Kostnadseffektivitet er et legitimt og nødvendig hensyn i forvaltningen av KI-systemer i høyere utdanning, men må forstås bredere enn innsparing. Kostnadseffektiv ressursbruk må vurderes opp mot formål som lærings- og vurderingskvalitet og datasikkerhet. Det er også viktig å vurdere det langsiktig og opp mot utfordringen med leverandøravhengighet: Blir institusjonene avhengige av en bestemt leverandør, blir de mer utsatt for dennes prissetting.
8.5.9 Langsiktighet og forutsigbarhet
Langsiktig forutsigbarhet er et grunnleggende hensyn i forvaltningen av KI-systemer i høyere utdanning. Forskning, utdanning, investeringer i infrastruktur og kompetanseutvikling har et langt tidsperspektiv og forutsetter stabile rammebetingelser. Rimelige og lett tilgjengelige KI-systemer kan på sikt øke i pris og integreres i andre tjenester som vanskeliggjør utfasing. En del KI-tjenester har bruksbaserte prismodeller (f.eks. per API-kall eller token) slik at budsjettering kan bli vanskelig (Alavi et al., 2025, s. 1). Mens inngangskostnaden kan være lav, kan de langsiktige kostnadene bli betydelige, bl.a. knyttet til API-er, lisenser og integrasjoner.
8.5.10 Utvalgets vurdering
Utvalget mener at forvaltningen av KI-systemer i universitets- og høyskolesektoren bør bygge på noen grunnleggende hensyn som samlet bidrar til å ivareta sektorens samfunnsoppdrag, akademiske verdier og behov for sikkerhet og langsiktig styring. Mangfoldet av utfordringer og hensyn tilsier at sektoren bør etablere felles prinsipper for forvaltning av KI-systemer.
Digital suverenitet
Etter utvalgets vurdering er det en rekke hensyn knyttet til digital suverenitet som samlet bør tillegges betydelig vekt i sektorens videre forvaltning av KI. Full digital suverenitet er verken realistisk eller verdt å etterstrebe, men det er ønskelig å oppnå en større grad av det. Dette gjelder enten subjektet for slik suverenitet skal forstås som institusjonen selv, sektoren, nasjonen, Norden eller Europa. Det gjelder også dersom objektet for slik suverenitet skal forstås som hele verdikjeden og teknologistabelen for KI, eller bare utvalgte deler av den (jf. kap. 3). Likevel vil det å utvikle mer selv og anskaffe mer lokalt, nasjonalt og regionalt, kunne gi mindre leverandøravhengighet og sårbarhet, bedre datasikkerhet og ivaretakelse av personvernet, legge bedre grunnlag for verdiskaping og kompetanseutvikling, og gi et bedre rettslig utgangspunkt for å bestemme over teknologien vi gjør bruk av.
Hensynet til datasikkerhet og personvern gjelder spesifikt hvordan data behandles og lagres. Det har dermed betydning hvilken datainfrastruktur KI-systemene blir drevet på. Dersom infrastrukturen er eid av staten eller av institusjonen selv, gir det et svært godt utgangspunkt for å kunne ivareta datasikkerheten og personvernet. Hensynet kan også ivaretas gjennom avtalevilkår med utenlandske skytjenester, betinget av at vilkårene kan overholdes. EU-kommisjonens rammeverk for skytjenestesuverenitet er et godt verktøy for å måle graden av europeisk suverenitet ved vurdering av skytjenester (EU-kommisjonen, 2025b).
Muligheten for å drifte KI-modeller på egen infrastruktur henger sammen med forskjellen på åpne modeller – det vil si modeller med åpne vekter eller åpen kildekode – og lukkede modeller. Lukkede, proprietære modeller leveres bare gjennom skytjenester, altså kan man ikke bruke egen datainfrastruktur til å drifte dem. For å utløse sikkerhetsgevinstene av å eie egen infrastruktur, er det derfor nødvendig å kombinere dette med modeller med åpen kildekode eller åpne vekter. Plattformer som Sikt KI, GPT UiO, GPT NTNU og den nederlandske eduGenAI, kan bidra til å redusere leverandøravhengighet ved å samle både åpne og kommersielle språkmodeller i ett felles kontrollert grensesnitt, som et alternativ til å bruke enkeltstående tjenester direkte. Det kan også tenkes andre modeller som gjennom sektorsamarbeid, nordisk eller europeisk samarbeid legger til rette for et mer mangfoldig leverandørmarked og reduserer sårbarheten som følger av konsentrasjon hos et fåtall store globale teknologiselskaper.
Tekniske løsninger som anonymisering, kryptering og bruk av syntetiske data kan redusere faren for brudd på datasikkerhet og personvern, men har sine ulemper bl.a. i form av ressursbruk og merkostnader spesielt ved store datasett og komplekse modeller. Eksperimentering og bruk av KI-agenter og andre KI-systemer må gjennomføres innenfor rammen av gjeldende regelverk og retningslinjer om personvern, dataforvaltning og sikkerhet.
Personvern- og risikovurderinger av KI-systemer som behandler personopplysninger, forskningsdata og andre beskyttelsesverdige opplysninger, er tidkrevende arbeid som forutsetter høy teknologisk og juridisk kompetanse. For å oppnå mer effektive prosesser og økt kvalitet er det hensiktsmessig med en felles støttefunksjon for personvern- og risikovurderinger ved anskaffelse og forvaltning av KI-systemer. En slik funksjon bør i så fall utformes som et kompetanse- og støttemiljø snarere enn en obligatorisk kontrollinstans, ettersom flere institusjoner har kompetanse i egen organisasjon til å gjøre slike vurderinger.
KI-forordningen
For å ta i bruk et KI-system må institusjonen kunne etterleve relevante regelverk, herunder KI-forordningen. KI-forordningens kompleksitet tilsier at institusjonene må bygge opp både juridisk og teknisk kompetanse til å forstå og anvende forordningen. En mulig felles støttefunksjon for anskaffelse og forvaltning av KI-systemer kan også omfatte vurderinger av kravene KI-forordningen stiller.
Opphavsrett
Utvalget legger til grunn at opphavsrett ikke bare er et rettslig spørsmål, men også et etisk spørsmål. Hensynet til opphavsrett bør inngå som en del av universitets- og høyskolesektorens forvaltning av KI-systemer. Institusjonene bør kunne etterspørre informasjon om treningsgrunnlag og hvilke rettighetsklareringer leverandørene har gjort. Videre er det hensiktsmessig å prioritere løsninger som bygger på lisensiert eller rettighetsavklart materiale, der dette er mulig, eller som har tekniske mekanismer som reduserer risikoen for opphavsrettslige konflikter, selv om det kan innebære mindre kapable løsninger. Et annet grep som støtter opp om opphavsretten er å prioritere modeller hvor leverandørene praktiserer større åpenhet om treningsgrunnlaget. Utvalget mener det bør utvikles retningslinjer om bibliotekfaglig opphavsrett og bruk av hentingsforsterket generering (RAG), der språkmodellen kobles til eksterne kunnskapsbaser og terminologikilder fremfor å være avhengig av hva som ligger implisitt i grunnmodellen.53 En løsning tilsvarende Kopinor-avtalen bør vurderes.54
Akademisk frihet og akademiske verdier
Forvaltningen av KI-systemer bør støtte og ikke uthule den akademiske friheten og akademiske verdier. I praksis betyr dette å unngå ulike former for underregulering og overregulering. Underregulering innebærer mangel på felles normer eller kontroll slik at valg av arbeidsmåter, databehandling og teknologiske premisser overlates til markedet og enkeltbrukerne. Overregulering, med strenge forbud og kontrollordninger, vil på den annen side svekke innovasjon og faglig begrunnet utprøving av teknologi. God KI-forvaltning beskytter akademisk frihet og akademiske verdier, i tillegg til å ivareta lokalt handlingsrom.
Undervisere har et selvstendig ansvar for innholdet og opplegget av undervisningen, herunder bruk av KI-systemer, innenfor de rammene som institusjonen setter. Dette innebærer at institusjonene må fastsette overordnede rammer for forvaltningen av KI-system i undervisningssammenheng i form av tydelige retningslinjer, sikkerhetskrav, hvilke KI-system som er godkjent, mv. Fagmiljøene bør sikres reell medvirkning i disse prosessene, ikke bare som et virkemiddel for å sikre at KI-systemene har utdanningsfaglig nytte, men også fordi KI-systemene griper inn i den faglige virksomheten.
Bærekraft
Høyere utdanning skal bidra til en bærekraftig samfunnsutvikling, utvikle og formidle kunnskap om klima- og miljøutfordringer og problematisere ressursbruk og sosial skjevfordeling. Bærekrafthensyn bør inngå i vurderingen av KI-systemer på linje med andre anskaffelses- og styringshensyn. Institusjonene bør skaffe seg bærekraftrelevant informasjon om KI-systemene. I den sammenheng bør det vurderes om mindre ressurskrevende KI-systemer kan være et alternativ. Videre kan institusjonene utvikle og prøve ut mekanismer som kan bidra til bærekraftig bruk. Her kan det tenkes ulike løsninger, f.eks. bruksbudsjetter. Dette er også et spørsmål om holdninger hos den enkelte bruker av et KI-system. Kombinasjonen av effektive KI-systemer og billig bruk kan svekke brukerbevisstheten.
Norsk fagspråk
Språkrådet peker på flere konkrete virkemidler for å styrke norsk fagspråk. Det ene er systematisk utvikling og tilgjengeliggjøring av terminologi gjennom Termportalen ved Universitetet i Bergen. Når Termportalen inneholder terminologi som er omforent og kvalitetssikret i fagmiljøene, kan den fungere som standard og referanse for KI-generert terminologi. Det andre er utvikling av norske språkmodeller som er utviklet og forvaltet i Norge, slik at oppdatert fagspråk raskere kan bli tilgjengelig i relevante verktøy. Det tredje er bruk av RAG (se ovenfor om opphavsrett).
Hensynet til norsk fagspråk bør reflekteres i hvordan KI-systemer prioriteres, anskaffes og utvikles. Dersom sektoren skal oppfylle sitt ansvar for å bruke, utvikle og styrke norsk fagspråk, bør dette også få betydning for vurderingen av KI-systemer. Det kan derfor stilles krav til språklig kvalitet på både bokmål og nynorsk, samt til systemenes evne til å håndtere norsk fagterminologi. Videre kan sektoren bidra til utvikling av norske språkmodeller og kunnskapsbaser, samtidig som brukerne gis kompetanse til å vurdere og forbedre språklig kvalitet i KI-generert innhold.
Forvaltningen bør derfor støtte opp under produksjon av norske fagtekster, utvikling av terminologiske ressurser og nasjonale språkmodeller. Deltakelse i internasjonale organisasjoner som ALT-EDIC (Alliance for Language Technologies, 2026) med formål om å utvikle språkmodeller som ivaretar språklig diversitet, kan vurderes.
Stabil og lik tilgang
Studenter bør ha likeverdig tilgang til KI-systemer, i tråd med gratisprinsippet. Forskjeller i tilgang bør som hovedregel være faglig eller pedagogisk begrunnet. Da opplæring i riktig bruk av KI-systemer er sentralt for å forebygge økte forskjeller og digitale skillelinjer, bør det kunne forventes at alle institusjoner sikrer tilstrekkelig opplæring i bruk av KI-systemer for studenter og har oppdaterte retningslinjer for bruk av KI-systemer i undervisning og læring, slik at studentene er godt rustet og møter tydelige og forutsigbare rammer.
Kostnadseffektiv ressursbruk
En fragmentert utvikling og anskaffelse av KI-løsninger kan føre til unødvendig ressursbruk. På den annen side kan samordning hemme lokale initiativ og tilpasning. Det må sikres en balanse mellom på den ene siden fellestiltak på områder som KI-infrastrukturer og sikkerhet og på den andre siden lokal innovasjon og utvikling.
Videre er det klokt å innta et langsiktig perspektiv på KI-relatert ressursbruk. Lisensavgiftene for de fremste språkmodellbaserte KI-tjenestene har vært overkommelige i det store bildet, frem til nå. Slik fortsetter det ikke nødvendigvis. Kommersielle skytjenester er generelt preget av sårbarhet for leverandørens prissetting, i og med at det ofte er få konkurrerende tilbydere og at det kan være teknisk krevende å bytte løsninger. Kombinasjon av å eie egen datainfrastruktur og å utnytte modeller med åpen kildekode eller åpne vekter, kan gi besparelser på lang sikt, selv om datainfrastrukturen koster forholdsvis mye ved anskaffelse.
Langsiktighet og forutsigbarhet
Forvaltningen av KI-systemer må ha et langsiktig perspektiv og bygge på noen stabile rammer og prinsipper som felles kravspesifikasjoner, standard avtalevilkår m.m. som tar høyde for løpende teknologiutvikling.
Plattformer, datalagring og regnekraft
Utvalget mener at eksperimentering, utvikling og anvendelse av språkmodellbaserte KI-systemer i en utdanningsfaglig sammenheng forutsetter at universiteter og høyskoler har tilgang på en sikker plattform som gir tilgang til egne, åpne og kommersielle språkmodeller, tilstrekkelig regnekraft og datalagringskapasitet bl.a. for sensitive data innenfor sikre og trygge rammer under norsk jurisdiksjon. Det må være balanse mellom prisnivå og sektorens økonomiske handlingsrom.
Utvalget forventer at universitets- og høyskolesektorens behov for regnekraft og datalagring vil øke i tiden fremover, i takt med den økte betydningen av KI-systemer og teknikker for trening og utvikling av KI. Mens forskningens behov for regnekraft og datainfrastruktur er nokså godt kjent, har vi mindre kunnskap nasjonalt om behovene som knytter seg til utdanningsvirksomheten. Å utvikle denne kunnskapen legger grunnlaget for bedre beslutninger om investeringer i datainfrastruktur.
8.6 Utvalgets vurdering av hvordan høyere utdannings behov kan møtes på en forsvarlig måte
8.6.1 Styring og samarbeid
Utvalget legger til grunn at norsk universitets- og høyskolesektor har en lang tradisjon med forvaltning av digitale fellestjenester. Sektoren har sterke kompetansemiljøer innenfor IT-utvikling i Sikt og i flere av de store universitetene. Etablering og drift av samstyringsmodellen (kap. 8.3.2) vitner om vilje til å forplikte egen institusjon og ressurser i et samarbeid til beste for sektoren som helhet, samtidig som det eksisterer en grense for når omfang og ressursbruk på samarbeidsprosesser blir ineffektivt eller til hinder for lokal innovasjon.
Forvaltningen av KI-systemer må ta høyde for en rask teknologiutvikling. Dette innebærer at styrings- og forvaltningsmekanismer ikke kan være for statiske eller knyttet til bestemte KI-teknologier, men baseres på prinsipper som tar høyde for å håndtere både dagens og fremtidens KI-løsninger. En av de store utfordringene i nær fremtid er å finne ut hvordan bruken av agentiske KI-systemer kan rammes inn på en trygg måte, blant annet med henblikk på hvilke tilganger de kan gis.
Det er mange forvaltningsnivåer og myndighetsorganer involvert i forvaltningen av KI-systemer i universitets- og høyskolesektoren. I tillegg til institusjonene selv og sentrale myndighetsorganer for høyere utdanning, har også Datatilsynet, Nasjonal kommunikasjonsmyndighet (Nkom) og Digitaliseringsdirektoratet, herunder KI Norge, relevante roller. Klar ansvarsdeling og konstruktivt samspill mellom alle aktørene har betydning for forvaltningens kvalitet og effektivitet.
8.6.2 Utvikling og anskaffelse av KI-systemer og KI-relevante ressurser
En enkel tilnærming til hvordan man kan møte høyere utdannings behov for tilgang på KI-systemer, baserer seg på å kjøpe lisenser for kommersielle KI-systemer levert som skytjenester. Da får man i praksis alle lagene i den forenklede teknologistabelen – applikasjon, modell og infrastruktur – i én samlet pakke (jf. Figur 8.2). En slik tilnærming vil imidlertid gi sektoren lite kontroll over teknologien og lite handlingsrom for videreutvikling av KI-modeller og applikasjoner. Det vil i praksis innebære å gi tjenesteleverandørene betydelig makt over norsk høyere utdanning, og i tillegg sette oss i dårligere stand til å ivareta de andre hensynene som er beskrevet i kapittel 8.5. For eksempel vil det være vanskelig å ivareta hensynet til bærekraft om man ikke får målt energiforbruk, fordi modellene driftes fra datasentre vi ikke har innsyn i.
Figur 8.2 Forenklet teknologistabel for KI
For å ivareta hensynene som er beskrevet i kapittel 8.5 er det særlig viktig å kunne drifte modeller på egen infrastruktur. Det er med andre ord behov for en mer nyansert og differensiert tilnærming enn den som er beskrevet ovenfor. Tilnærmingen utvalget foreslår i det følgende, tar utgangspunkt i de ulike lagene i teknologistabelen.
Infrastruktur
Trening og finjustering av KI-modeller krever betydelig regnekraft, men det gjør i økende grad også det å drifte modellene, særlig med resonnerende modeller og agentiske systemer. Alle hensynene knyttet til digital suverenitet – leverandøravhengighet og sårbarhet, datasikkerhet og personvern, jurisdiksjon og muligheter for verdiskaping – tilsier at man bør ha eierskap og kontroll over datainfrastrukturen, heller enn å få regnekraft og datalagring levert som skytjenester fra ikke-europeiske leverandører. Har man infrastrukturen på plass, kan den brukes til å drifte modeller. Den kan også brukes til å videretrene og finjustere modeller for å tilpasse dem de oppgavene man ønsker å løse i høyere utdanning. Å investere i datainfrastruktur åpner dermed et innovasjonsrom som kan gi verdiskaping og kompetanseutvikling.
Det er dyrt å anskaffe infrastruktur for regnekraft og datalagring, men prisen må vurderes i et langsiktig perspektiv, opp mot hva sektoren ellers hadde betalt for å få regnekraften levert gjennom skytjenester. Regnekraften må man betale for på den ene eller andre måten, om det skjer gjennom å investere i og drifte egen datainfrastruktur eller gjennom å betale for utenlandske skytjenester. De ledende KI-selskapene har investert enorme summer i å utvikle sine fremste grunnmodeller, og har så langt ikke prissatt tjenestene sine deretter. Dette kan endre seg når selskapene over tid må sørge for større inntjening. Gjennom å eie egen infrastruktur, blir man mindre sårbar for denne prisveksten.
Det er verken hensiktsmessig eller regningssvarende å bygge opp separate datainfrastrukturer ved den enkelte institusjon. Sentrale myndigheter har i dag ansvaret for nasjonale datainfrastrukturer innenfor høyere utdanning. I forlengelsen av dagens ansvarsdeling mener utvalget at sentrale myndigheter bør ta ansvar for å møte høyere utdannings behov for regnekraft og datalagring. Dette kan skje gjennom nasjonale datainfrastrukturer, sektorspesifikke eller sektorovergripende, og eventuelt gjennom infrastruktursamarbeid med nordiske eller europeiske land. Sentrale myndigheters investering i datainfrastruktur kan kombineres med overkommelig brukerbetaling, slik at man kan sørge for en rimelig fordeling av økonomisk byrde mellom institusjonene ut fra størrelse og bruksomfang. Slik kan sentrale myndigheter samtidig bidra til likeverdig tilgang på tvers av sektoren.
Omfanget av høyere utdannings behov for regnekraft og tilknyttet datalagringskapasitet er uvisst, og utvalget har ikke hatt mulighet til å beregne kostnaden av å møte dette behovet. Utvalget anbefaler derfor at sentrale myndigheter setter i gang en utredning av det fremtidige regnekraftbehovet innenfor høyere utdanning. En slik utredning kan bygge på den eksisterende utredningen av forskningens behov for regnekraft (Forskningsrådet, 2025).
Utvalget mener at sentrale myndigheter også bør vurdere finansieringsordninger for eksperimenterende bruk av regnekraft, for eksempel i form av en pott som man kan søke om finansiell støtte fra, til forsøk og testing hvor det kreves mye regnekraft.
Modeller
Et viktig premiss for at man kan utløse gevinstene av å eie datainfrastruktur, er at man har tilgang på KI-modeller som kan driftes og videretrenes på infrastrukturen.55 Det finnes i dag mange modeller med åpne vekter som fritt kan lastes ned. Som en hovedregel er modellene med åpne vekter ikke blant de ledende KI-modellene, men de beste er i nærheten av utviklingsfronten (Epoch AI, 2026c). Også Nasjonalbibliotekets modellserie, Borealis, som har åpen kildekode og åpne vekter, kan brukes i denne sammenhengen. Utvalget vurderer at det er sannsynlig at modeller med åpne vekter vil kunne møte mesteparten av høyere utdannings behov for KI-modeller. I kombinasjon med å eie egen infrastruktur, gir modeller med åpne vekter et svært godt utgangspunkt for å ivareta hensynene som er beskrevet i kapittel 8.5.
Utvalget anerkjenner samtidig at flere fagutøvere kan ha behov for tilgang på modeller som er fremst i utviklingsfronten, og som ikke er fritt tilgjengelig med åpne vekter (jf. kap. 8.4). Selv om mesteparten av høyere utdannings behov for KI møtes gjennom modeller med åpne vekter drevet på egen infrastruktur, kan dette kombineres med å betale for brukerlisenser og API-tilgang til modeller i utviklingsfronten, for dem som har behov for det.
Applikasjoner
Sluttbrukere får tilgang til KI-modeller gjennom applikasjoner, som de sektorutviklete KI-tjenestene Sikt KI, GPT UiO og GPT NTNU (jf. Boks 8.1). Utvalget mener at det er fornuftig å opprettholde en kombinasjon av samarbeid og sunn konkurranse mellom tjenesteleverandørene i sektoren, for å sikre et innovativt tjenestetilbud, samtidig som man unngår unødvendige investeringer i parallelle tjenestetilbud med lik funksjonalitet. Det betyr i praksis at aktørene bør søke mot arbeidsdeling der hvor det er snakk om tjenester som er særlig ressurskrevende å utvikle, samtidig som de på andre områder konkurrerer om å levere de beste tjenestene.
Norsk universitets- og høyskolesektor har allerede mye av kompetansen som kreves for å utvikle applikasjoner basert på KI-modeller, slik eksemplene ovenfor viser. Dette er en viktig del av sektorens digitale uavhengighet. Det betyr også at sektoren lettere kan møte utdanningsfaglige og fagspesifikke behov, i samarbeid med vitenskapelig ansatte (jf. kap. 8.4). I tråd med dette bør applikasjonsutviklere få API-tilgang til eventuelle modeller driftet på nasjonal datainfrastruktur.
8.6.3 Rammeverk for forvaltning av KI-systemer
For å sikre en forsvarlig og formålstjenlig forvaltning av KI-systemer, anbefaler utvalget at det etableres et sektorfelles rammeverk. Et slikt rammeverk bør fastsette overordnede prinsipper for forvaltningen, knyttet til ivaretakelse av akademisk frihet, personvernet, digital suverenitet, rettssikkerhet, likebehandling, bærekraft, norsk fagspråk, dokumentasjon og menneskelig kontroll. Rammeverket bør utvikles gjennom et samarbeid mellom sentrale myndigheter, institusjonene og studentorganisasjonene, eventuelt også partene i arbeidslivet. Rammeverket kan trekke vekseler på den irske modellen og prinsipper utarbeidet av UNESCO og Europarådet (Europarådet, 2024; Higher Education Authority, 2025a; UNESCO, 2022, 2023).
Et rammeverk for forvaltning av KI-systemer bør inneholde
-
overordnede prinsipper om akademisk frihet, digital suverenitet, prioritering av modeller med åpen kildekode eller åpne vekter, etisk forsvarlig teknologibruk og rettferdig tilgang på kvalitetssikrede KI-modeller
-
minimumskrav etter lov, til datastyring, informasjonssikkerhet og personvern, herunder retningslinjer for hva som kan mates inn i KI-systemer, med henblikk på opphavsrett, personvern og datasikkerhet
-
organisatoriske tiltak for å etterleve KI-forordningen
-
krav til interoperabilitet, standarder og dataportabilitet
-
krav om muligheter for universell utforming og individuell tilpasning
-
standardiserte kontraktsvilkår for anskaffelser, herunder retningslinjer for involvering av vitenskapelig ansatte
-
krav om at utvikling og anskaffelser bygger på dokumenterte behovs- og risikovurderinger, herunder bærekraftkriterier og språklige og fagspråklige kvalitetskriterier
-
krav til at det foreligger planer for leverandøruavhengighet og utfasing (exit-strategi)
Rammeverket bør legge til rette for sektorfelles forhandlinger med sentrale leverandører der dette er hensiktsmessig og legge grunnlaget for at fagmiljøene kan utøve faglig autonomi innenfor trygge og forutsigbare rammer (jf. kap. 8.5.10).
Utvalget anbefaler at universiteter og høyskoler, i samarbeid med relevante myndighetsorganer, etablerer et felles rammeverk for forvaltning av KI-systemer i UH-sektoren i samsvar med ovennevnte beskrivelse. Utvalget anbefaler at sentrale myndigheter følger opp dette arbeidet.
8.6.4 Teknisk, juridisk og sikkerhetsfaglig støttefunksjon
Ikke alle universiteter og høyskoler sitter på tilstrekkelig teknisk, juridisk og sikkerhetsfaglig kompetanse til å gjøre nødvendige vurderinger i forvaltning av KI-systemer. Dette er store og krevende fagfelt å holde seg orientert i, og de er under stadig utvikling. Utvalget anbefaler derfor at sentrale myndigheter etablerer en felles støttefunksjon for vurdering av risiko, personvern, kontraktsvilkår, anskaffelser og dokumentasjon, herunder etterlevelse av KI-forordningen (se Boks 4.3). En slik støttefunksjon kan utvikle klassifiseringsmodeller, DPIA- og FRIA-maler, minimumskrav til kontrakter, krav til logging og sletteprosedyrer, og veiledning om etterlevelse av KI-forordningen, opphavsretten mv.
En slik støttefunksjon kan også koordinere henvendelser til og samarbeid med Datatilsynet, Nkom og Digitaliseringsdirektoratet, inkludert KI Norge. En slik støttefunksjon vil kunne gi stordriftsfordeler uten å oppheve lokalt ansvar.
8.6.5 Sentralt og lokalt ansvar
Utvalgets forslag i kap. 8.6.1–8.6.4 kan samlet karakteriseres som en modell for forvaltning av KI-systemer i høyere utdanning. Elementene i modellen kan riktignok endres og kombineres på ulike måter, men de utgjør allikevel en helhetlig modell som langt på vei følger sektorens styringstradisjon og organisering. Nærmere bestemt kombinerer modellen sentral styring og sentralt ansvar med lokalt handlingsrom, ansvar og sektorsamarbeid.
KI overskrider i flere henseender hva den enkelte institusjon kan forventes å ha ressurser til. Ikke alle universiteter og høyskoler kan investere i egen datainfrastruktur for å utvikle og drifte KI-systemer, og ikke alle universiteter og høyskoler har tilstrekkelig teknisk, juridisk og sikkerhetsfaglig kompetanse i egen organisasjon til å sørge for en forsvarlig forvaltning av KI-systemer. Her har sentrale myndigheter et ansvar for at sektorens behov blir møtt.
Utvalget vurderer samtidig at den enkelte institusjon er nødt til å ha et handlingsrom innenfor rammer satt av myndighetene og av sektorfelles prinsipper for forsvarlig forvaltning. Dette bidrar til innovasjon og til at lokale og fagspesifikke behov lettere kan bli møtt. Institusjonene er også nødt til å stå ansvarlig for egen forvaltning, for eksempel som behandlingsansvarlige under personvernforordningen eller som idriftsettere under KI-forordningen.
8.7 Anbefalinger
Utvalget anbefaler universiteter og høyskoler å
-
sørge for utdanningsfaglig nytte og ivaretakelse av den akademiske friheten ved utvikling og anskaffelse av KI-systemer, herunder gjennom å involvere undervisere i slike prosesser
-
utvikle et sektorfelles, prinsipielt rammeverk for forvaltning av KI-systemer, som ivaretar hensyn til digital suverenitet, akademisk frihet, bærekraft, likeverdig tilgang og ivaretakelse av opphavsretten og norsk fagspråk. Rammeverket utvikles i samarbeid mellom institusjonene og sentrale myndigheter.
Utvalget anbefaler sentrale myndigheter å
-
møte høyere utdannings behov for regnekraft og datalagring gjennom
-
nasjonal datainfrastruktur, sektorspesifikk eller sektorovergripende
-
samarbeid om datainfrastruktur med andre nordiske eller europeiske land
-
-
utrede høyere utdannings behov for regnekraft og datalagring
-
etablere en felles støttefunksjon for å bistå institusjonene som trenger det med tekniske, juridiske og sikkerhetsfaglige vurderinger av KI-systemer
-
sørge for at sektorens utviklere av KI-tjenester samarbeider for å oppnå et kostnadseffektivt og innovativt tjenestetilbud som gir alle institusjoner likeverdige muligheter til å nyttiggjøre seg av KI-modeller
-
vurdere finansieringsordninger for eksperimenterende bruk av regnekraft
9 Kvalitetsarbeid
9.1 Begreper, rammer og spenninger
Kvalitet i høyere utdanning handler blant annet om faglig nivå, læringsmiljøet, tilbudet av undervisning, veiledning og andre læringsaktiviteter, vurderinger, studietilbudets utforming og sammenheng og dets relevans for samfunnet og arbeidslivet. Det er ulike syn på hva som ligger i disse kvalitetsaspektene og hvilke som har størst betydning, noe som kan gi opphav til spenninger i arbeidet med å fremme utdanningenes kvalitet.
Institusjonene har ansvar for å sikre og videreutvikle utdanningskvaliteten. Lovverket stiller krav om et internt kvalitetssystem som er skriftlig og tilgjengelig, og gjelder for alle institusjonens studietilbud (jf. universitets- og høyskoleloven § 3-5 og universitets- og høyskoleforskriften §§ 1-6 til 1-9). Systemet skal beskrive ansvarsforhold, rapporteringslinjer og hvordan kvalitetsarbeidet skal gjennomføres i praksis. Arbeidet skal være strategisk forankret og involvere både studenter og ansatte. Det skal bidra til både kontroll, korrigering av svikt og fornyelse, blant annet gjennom periodiske evalueringer. Institusjonenes arbeid med læringsmiljøet skal også dokumenteres og inngå i kvalitetssystemet. NOKUT fører jevnlig tilsyn med kvalitetsarbeidet (jf. kap. 9.4).
I NIFU-rapporten Sammen om kvalitet? tegner Slette et al. (2025) et analytisk skille mellom formelt og systematisk kvalitetsarbeid på den ene siden og faglig-pedagogisk utviklingsarbeid på den andre. Det systematiske kvalitetsarbeidet er knyttet til formelle systemer, dokumentasjon, evaluering, tilsyn og oppfølging. Det faglig-pedagogiske utviklingsarbeidet er i større grad forankret i undervisningsnære prosesser i institusjonene og fagmiljøene.
Norske universiteter og høyskoler har over tid utviklet omfattende kvalitetssystemer, som også skal kunne håndtere nye utviklingstrekk. Universitets- og høyskoleforskriften slår fast at systemet og kvalitetsarbeidet skal være tilpasset institusjonens størrelse, faglige profil og egenart (jf. § 1-6).
Skillet mellom kvalitetssystemer og faglig-pedagogisk utviklingsarbeid er relevant også når vi tar for oss kvalitetsarbeid i møte med kunstig intelligens (KI). De foregående kapitlene har vist hvordan teknologien påvirker læringsinnhold, læringsprosesser og vurderinger. Dette kapittelet tar for seg hvordan slike endringer kan følges opp gjennom kvalitetsarbeid, forstått både som faglig-pedagogisk utviklingsarbeid og det systematiske kvalitetsarbeidet. Vi ser også på hvordan KI påvirker arbeidet med ekstern kvalitetssikring og tilsyn, og hvordan KI-støttet læringsanalyse og andre datakilder kan gi et bedre kunnskapsgrunnlag for kontinuerlig utvikling av utdanningskvaliteten.
9.2 Faglig-pedagogisk utviklingsarbeid i møte med KI
Tilgangen til KI-systemer endrer forutsetningene for studentenes arbeid med fagstoffet, utfordrer etablerte vurderingsformer og kan påvirke hva som bør inngå i studieprogrammenes læringsinnhold. Teknologien lar studentene søke, vurdere, strukturere og bearbeide informasjon på nye måter. Vurderinger som ikke gir tilstrekkelig innsyn i studentenes prosess, refleksjoner og faglige selvstendighet, får mindre verdi som dokumentasjon på læringsutbytte. Innholdet i studieprogrammer og emner må også vurderes i lys av at studentene skal forberedes på et arbeidsliv der bruk av KI-systemer inngår i nye faglige praksiser.
Dette stiller fagmiljøene overfor flere utfordringer i arbeidet med å utvikle utdanningskvaliteten, og utfordringene vil variere mellom ulike studieprogrammer og emner. I noen fag vil KI-systemer først og fremst være verktøy studentene må lære seg å bruke kritisk og ansvarlig. I andre fag kan teknologien føre med seg gjennomgripende endringer i kunnskapsgrunnlaget, metodene eller profesjonsutøvelsen studentene skal utdannes i og til. Utformingen av emner og læringsaktiviteter kan måtte endres som følge av dette, noe som stiller krav til ansattes kompetanse, samarbeid og et kontinuerlig faglig utviklingsarbeid. I fag- og studiekontekster der større endringer er nødvendig, er det viktig med en helhetlig og integrert tilnærming for å ivareta hensyn til sammenheng og progresjon.
Faglig-pedagogisk utviklingsarbeid krever tid, kapasitet og gode arenaer for kunnskapsdeling og kollektiv innsats. Det forutsetter også at fagmiljøene har kompetanse til å kunne vurdere hvordan teknologien påvirker det faglige innholdet, og hvordan den kan brukes til å forbedre undervisning, vurdering og studentenes læringsmiljø (jf. kap. 10). Inspirasjon kan hentes fra andre institusjoners arbeid, både i Norge og andre land. Vi har inkludert to eksempler, fra USA (Boks 9.1) og Australia (Boks 9.2), som kan ha stor overføringsverdi.
Boks 9.1 Anbefalinger fra Massachusetts Institute of Technology (MIT)
Behovet for handling målbæres tydelig i en rapport fra et internt utvalg ved MIT, som legger frem prinsipper og anbefalinger for bruk av KI-systemer i undervisning, læring og forskeropplæring. Utvalget anbefaler å tilpasse utdanningen til en verden preget av KI-teknologi; å sette mennesker, fellesskap og campus-opplevelser i sentrum; og å bygge prosesser, team og verktøy som legger til rette for kontinuerlig refleksjon og gjentakende runder med forbedring.
MIT-utvalget har definert åtte prinsipper for å veilede institusjonens arbeid fremover:
-
Vær ydmyk for at ting vil fortsette å endre seg, og at kursendringer vil måtte komme.
-
Ha mot til å ta strategiske valg og gripe ekstraordinære muligheter.
-
Sett menneskeheten i sentrum ved å dyrke og beskytte vår felles menneskelighet og verdsette fellesskapet.
-
Sats på læring ved å ta tak i krefter som eroderer utdanningsoppdraget, og hjelpe studentene til å se læringsprosessen som et produktivt strev.
-
Ha tydelige intensjoner med undervisningen ved å definere læringsutbyttet først, og utfra det gjøre det klart hvorfor KI-bruk enten er tillatt, begrenset eller påkrevd.
-
Ikke bruk samme løsning på alt, men tilpasse retningslinjer utfra et felles rammeverk.
-
Forsterk fremfor å automatisere, ved å forme KI-bruken til å støtte læring og fremme nysgjerrighet og kreativitet.
-
Tenk forbi klasserom og campus ved å dyrke en kultur for læring som bidrar til at studentene evner å tolke verden, finne sin plass i samfunnet og se seg selv som kompetente og handlekraftige individer.
Kilde: Massachusetts Institute of Technology (2026)
9.3 Systematisk kvalitetsarbeid i møte med KI
Institusjonenes systematiske kvalitetsarbeid har en annen og mer formell innretning enn det faglig-pedagogiske utviklingsarbeidet, men de to må virke sammen. Institusjonene må kunne følge opp om endringene faktisk bidrar til bedre læring, bedre undervisning, mer egnede vurderingsformer og bedre sammenheng i studieprogrammene. Kvalitetssystemet skal sikre at utdanningskvaliteten dokumenteres og følges opp på en systematisk måte, at studentenes erfaringer inngår i grunnlaget og at eventuell svikt korrigeres. Det skal omfatte alle institusjonens studietilbud, både stedbaserte og fleksible, og på alle nivåer.
KI-systemer og automatisering kan støtte arbeidet med å innhente, strukturere og analysere data som inngår i kvalitetssystemene. Dette må forankres i eksisterende kvalitetsforståelser og styringsverktøy. Det nasjonale kvalifikasjonsrammeverket for livslang læring (NKR) og kravene til læringsutbytte gir et utgangspunkt for vurdering av måloppnåelse og sammenheng i studieprogrammer. De nasjonale veiledende retningslinjene for UH-pedagogisk basiskompetanse (Universitets- og høgskolerådet, 2018) indikerer hvilken utdanningsfaglig kompetanse som er nødvendig for å kunne tolke og bruke slike analyser i pedagogisk utviklingsarbeid.
Slette et al. (2025) peker på et skille mellom kvantitative, standardiserte data og mer lokal og fagspesifikk rapportering, der sistnevnte kan oppleves som mer informativ, men ikke like enkelt aggregeres opp til høyere nivåer. Her kan imidlertid utviklingen innen generative KI-systemer åpne nye muligheter. Kvalitative data kan i større grad enn før systematiseres og ses i sammenheng på tvers av fagområder eller institusjonelle skiller. God bruk av KI-systemer kan også styrke studentenes medvirkning, blant annet ved å synliggjøre hvordan evalueringer og innspill følges opp og hvilke endringer de fører til.
Ved hjelp av KI er det også mulig å utvide datagrunnlaget med flere kilder som kan bidra til dypere analyser. Tilstandsrapporten for høyere utdanning gir grunnlag for sammenligninger på tvers av institusjoner. Studiebarometeret, Studentenes helse- og trivselsundersøkelse og nasjonale og lokale kandidatundersøkelser gir informasjon om studentenes opplevelse og utbytte av studiene, om læringsmiljøet og om overgangen til arbeidslivet. Bransjeundersøkelser, arbeidsmarkedsinformasjon og kvalitative innspill fra arbeidsliv, praksisfelt og fagmiljøer kan også gi verdifull informasjon. Sammenstilt med data om forholdene lokalt på institusjonen kan dette gi ny innsikt og stimulans til kvalitetsarbeidet.
Boks 9.2 Anbefalinger fra University of Sydney
I et strategisk drøftingsnotat fra universitetets utdanningsmiljø argumenteres det for at institusjonen må handle besluttsomt for å sikre at læring forblir meningsfull, at vurdering gir troverdig dokumentasjon på studentenes kompetanse og at kvalifikasjoner fra universitetet har høy tillit og tydelig verdi for arbeidslivet og samfunnet.
Rammeverket vender oppmerksomheten bort fra studentenes produkter og over til utvikling, demonstrasjon og kvalitetssikring av reell kompetanse. Det fremhever seks prinsipper som førende: menneskelige egenskaper, tilhørighet og fellesskap, tillit, integritet, likeverd og relevans.
Notatet foreslår en koordinert omstilling på fem områder:
-
systematisk utvikling av studentenes kompetanse, inkludert KI-forståelse, dømmekraft og ansvarlig bruk av KI-systemer
-
ny utforming av læringsaktiviteter som støtter aktiv, persontilpasset og relasjonell deltakelse
-
videreutvikling av vurdering gjennom helhetlig utforming på studieprogramnivå og et rammeverk for kompetanseutvikling og kvalitetssikring
-
styrking av underviseres kompetanse til å utvikle og gjennomføre utdanning av høy kvalitet med støtte fra KI-systemer
-
videreutvikling av den samlede studentopplevelsen, inkludert engasjement, støtte, fellesskap og forberedelse til arbeidslivet
En slik bred fornyelse krever en kollektiv innsats fra fakulteter, institutter, undervisere og teknisk-administrative ansatte.
Kilde: University of Sydney, 2026
9.4 KI i kvalitetssikring, akkreditering og tilsyn
Utdanningskvaliteten ved norske høyere utdanningsinstitusjoner følges systematisk opp gjennom både interne og eksterne kvalitetssikringsaktiviteter. Den interne kvalitetssikringen ligger hos institusjonene selv og omfatter lovpålagte kvalitetssystemer, evalueringer, analyser og oppfølging av studieprogrammer og læringsmiljøet. Den eksterne kvalitetssikringen skal sørge for at institusjonenes kvalitetsarbeid er forsvarlig og at utdanningene holder tilfredsstillende kvalitet. NOKUT fører tilsyn med institusjonenes systematiske kvalitetsarbeid, akkrediterer institusjoner og studietilbud, gjennomfører evalueringer og analyser og stimulerer til kvalitetsutvikling gjennom kunnskapsdeling og veiledning.
Organisasjonen for europeiske kvalitetssikringsorganer, ENQA, fremhever at organer som NOKUT både må forstå hvordan KI påvirker høyere utdanning, og hvordan de selv kan bruke KI-systemer på en ansvarlig måte i egne prosesser. Deres retningslinjer for ansvarlig KI-bruk i ekstern kvalitetssikring (ENQA, 2025b) løfter særlig frem strategisk forankring, etikk, inkludering, bærekraft, transparens, personvern, rettferdig tilgang, menneskelig kontroll, opplæring og løpende evaluering. I norsk sammenheng innebærer dette at NOKUTs tilsyns- og evalueringspraksis må kunne fange opp hvordan KI påvirker utdanningenes kvalitet, samtidig som eventuell bruk av KI-systemer i NOKUTs egne prosesser må være tydelig regulert, transparent og underlagt menneskelig, faglig ansvar.
Til utvalget opplyser NOKUT at de i 2026 gjør forsøk med KI-støtte i saksbehandlingen for akkreditering og tilsyn. Et spesialisert verktøy analyserer søknadsdokumenter og tilsynsmateriale i lys av gjeldende krav og regelverk, og leverer et strukturert resultat som saksbehandleren kan bruke som grunnlag for sine vurderinger. Systemet er ikke trent på tidligere vedtak eller sakshistorikk – kunnskapen om fagdomenet ligger i maler og regelverk som er bygget inn i instruksjonene. Løsningen kjøres internt på NOKUTs infrastruktur, og alle analyser blir loggført for transparens og etterprøvbarhet. Verktøyet kan blant annet bidra til å identifisere manglende dokumentasjon i en akkrediteringssøknad slik at søkerinstitusjonen kan få raskere tilbakemelding om dette og mulighet til å rette opp. Slik kan den samlede saksbehandlingstiden kortes ned.
NOKUT har også gjort forsøk med bruk av KI-systemer som støtteverktøy for tematiske analyser. De fant at språkmodeller kan gjøre det lettere å få oversikt og støtte analysearbeidet, samtidig som manuell analyse fortsatt er avgjørende for å forstå kontekst, tolke nyanser og gjøre skjønnsmessige vurderinger (NOKUT, 2026). Videre prøver de ut KI-systemer i ulike faser av evalueringsprosessen.
Pilotforsøk i Spania har vist at KI-støttede analyser kan bidra til å identifisere studieprogrammer med forhøyet risiko for ikke å møte akkrediteringskrav, og hente innsikt fra store indikatorsett som ofte samles inn uten å utnyttes godt nok. Samtidig viser erfaringene at kvalitetssikringsprosesser er flerdimensjonale og ikke kan reduseres til kvantitative indikatorer alene. Bruk av maskinlæring kan gi verdifull støtte i å flagge risiko, men kan ikke erstatte menneskelige ekspertvurderinger (ENQA, 2025a).
9.5 Læringsanalyse som støtte for kvalitetsutvikling
Læringsanalyse er systematisk bruk av data for å fremme læring og forbedre undervisning, som definert i utredningen NOU 2023: 19 Læring, hvor ble det av deg i alt mylderet? Et sentralt formål med læringsanalyse er å fremme læring for enkeltindivider eller grupper med tiltak som skjer tett på læringssituasjonen, for eksempel gjennom automatisert tilpasning av læringsressurser (adaptivitet). Det kan innebære at innholdet eller visningen i en læringsressurs automatisk tilpasser seg studentens preferanser basert på tidligere bruk, eller at oppgaver fra et oppgavesett tildeles automatisk ut fra hva studenten har svart på tidligere oppgaver.
Et annet mer organisatorisk formål er å gi bedre grunnlag for utvikling av emner, studieprogrammer og læringsmiljøer. Læringsanalyse kan gi innsikt i hvordan studentene forholder seg til fagstoffet og hvordan den faglige progresjonen deres er. Denne innsikten kan bidra til å gjøre utviklingsarbeidet mer målrettet og effektivt, og gi mer helhetlig og sammenhengende undervisningsdesign.
Den pedagogiske verdien av læringsanalyse ligger i å få innsikt i studentenes faglige utvikling, noe både undervisere og den enkelte student selv kan dra nytte av. Ved å legge til rette for selvregulering, kan læringsanalyse bidra til studentaktiv læring. Undervisere kan bruke læringsdata som grunnlag for tilbakemeldinger til studentene og tilpasning av undervisningen. Læringsanalyse kan også bidra til inkludering og livslang læring gjennom tilpasninger av studietilbudet og tilrettelegging av undervisningen for studenter med ulike behov og forutsetninger.
Videre kan læringsanalyse bidra direkte inn i det strategiske arbeidet med kvalitetsutvikling. Kombinasjonen av læringsdata og KI-baserte modeller åpner for en mer kontinuerlig tilnærming til kvalitetsarbeid, med analyser basert på løpende informasjon om studentenes læring og aktivitet. Analyser av data om studentenes deltakelse i læringsaktiviteter og arbeid med studiene kan blant annet brukes til å predikere frafall, slik at tiltak kan iverksettes på et tidlig tidspunkt. I prosjektet BraStart utforsker Universitetet i Oslo bruk av data fra flere digitale plattformer, spørreundersøkelser og studieadministrative kilder til å undersøke studentenes akademiske integrering og faktorer som støtter gjennomføring i det første studieåret. Samtidig begrenses de reelle mulighetene for å utnytte data på denne måten i stor grad av gjeldende regelverk og utfordringer knyttet til teknisk infrastruktur (Damşa et al., 2026).
Som støtte for menneskelige vurderinger kan læringsanalyse dermed styrke både undervisning og læring på individnivå, den løpende oppfølgingen av studieprogrammer og det mer langsiktige kvalitetsarbeidet på institusjonelt nivå. Det kan også legge til rette for mer utprøving, blant annet av nye undervisnings- og vurderingsformer. Med KI-støtte og økt standardisering kan analyser også gjøres på tvers av institusjoner og på nasjonalt nivå. Slike gevinster forutsetter blant annet tilgang til relevante data, tydelige formål, god styring av personvern og informasjonssikkerhet, tilstrekkelig kompetanse og rom for faglig skjønn. For å ha nødvendig tillit, må bruken av læringsanalyse være forståelig og etterrettelig. Studentene må ha innsyn i hvilke data som brukes og hvordan analyser inngår i beslutninger som berører dem. NOU 2023: 19 fant imidlertid at opplevd usikkerhet rundt personvern er et stort hinder for bruken av læringsanalyse i høyere utdanning. I tillegg til juridiske avklaringer vil en oppskalert bruk kreve endringer i teknisk infrastruktur og dataforvaltning.
9.6 Utvalgets vurdering
KI-teknologien påvirker vilkårene både for faglig-pedagogisk utviklingsarbeid og for systematisk kvalitetsarbeid, og det er nødvendig å se disse dimensjonene i sammenheng. En hovedutfordring i kvalitetsarbeidet er å forene kravene til systematikk og kontroll på overordnet nivå med behovet for fagnært og involverende pedagogisk utviklingsarbeid på emne- og studieprogramnivå. Innføringen av KI-systemer kan forsterke slike spenninger dersom teknologien primært brukes til rapportering og standardisering uten hensyn til institusjonenes og fagmiljøenes egenart. Det er også en risiko for at kvalitetsarbeidet virker teknologisk fremmedgjørende på både studenter og ansatte, hvis det ikke gis tilstrekkelig rom for medvirkning og menneskelig skjønn. Dette kan i seg selv påvirke det læringsmiljøet kvalitetsarbeidet skal bidra til å ivareta.
På den annen side kan bruk av KI-systemer bidra til mer kunnskapsbasert og kontinuerlig kvalitetsarbeid på alle nivåer. Utvalget understreker institusjonenes ansvar for å legge til rette for faglig-pedagogisk utviklingsarbeid i utdanningenes møte med KI-teknologien. Det krever tid, kompetanse, tydelig lederforankring, faglige og teknologiske ressurser samt arenaer for erfaringsutveksling og samarbeid. Data om, og vurderinger av, institusjonenes bruk av KI bør innarbeides i kvalitetssystemer og det ordinære kvalitetsarbeidet. Det innebærer også å plassere ansvar for systematiske vurderinger av konsekvenser for læringsutbytte, undervisningspraksis, vurdering, læringsmiljø og akademisk integritet.
Det faglig-pedagogiske utviklingsarbeidet kan ikke primært handle om å etablere eller tilpasse regler for bruk av KI-verktøy. Fagmiljøene må drøfte hva KI innebærer for utviklingen av deres fagområde og hvilke følger det har for læringsutbyttebeskrivelser, sammenhengen mellom undervisning og vurdering og utviklingen av studentenes faglige dømmekraft. Slike vurderinger må gjøres lokalt for hvert fagområde og involvere både studenter og ansatte.
Det kan innebære utviklingsprosjekter på emne- og studieprogramnivå, deling av læringsressurser, undervisnings- og vurderingsopplegg, støtte fra utdanningsfaglige miljøer og samarbeid på tvers av fagområder og institusjoner. Studentene bør inviteres til å bidra med sine erfaringer om hvordan KI-systemene påvirker læringsprosesser og læringsmiljø. Forankring i ledelsen og tilgang til utdanningsfaglig, teknologisk og juridisk støtte kan være avgjørende for å lykkes med endringene.
I tillegg kan økonomiske insentivordninger – på lokalt eller nasjonalt nivå – være et virkemiddel for å gi dette arbeidet større rom. Økonomiske insentiver for kvalitetsutvikling kan bidra til at arbeidet prioriteres, får oppmerksomhet og nødvendige ressurser. Etter avviklingen av nasjonale tilskuddsordninger som Sentre for fremragende utdanning og Program for studentaktiv læring er det i dag opp til den enkelte institusjon å vurdere denne typen virkemiddelbruk. Det kan bety at institusjonene må tenke nytt om virkemidler som kan gi tilstrekkelig rom for designprosjekter og fagspesifikk teknologiutvikling der dyp forståelse for fagene og læringsprosessene inngår. Samtidig står sektoren overfor en omfattende omstilling der mange av utfordringene går på tvers av institusjonelle grenser. Behovet for nyskapende faglig-pedagogisk utviklingsarbeid knyttet til innføringen av KI-teknologi kan på kort sikt overstige det eksisterende rammebevilgninger gir rom for. Utvalget anbefaler derfor å innføre nasjonale konkurransebaserte tilskuddsordninger som kan styrke dette arbeidet.
Som del av kvalitetsarbeidet bør institusjonene også vurdere om fagmiljøene har den nødvendige kompetanse til å utvikle studieprogrammene i lys av KI-relaterte endringer i innhold, undervisning, vurdering og læringsmiljø (jf. kap. 10). Dette kan systematiseres gjennom periodiske programevalueringer og vurderinger av fagmiljøenes samlede kompetanse.
Legitimitet og oppslutning om kvalitetsarbeidet fordrer en god balanse mellom faglig-pedagogisk utviklingsarbeid og formell kvalitetssikring. Institusjonene bør sikre at kvalitetssystemene brukes til å støtte og stimulere fagmiljøenes utviklingsarbeid, sikre medvirkning fra studentene og legge til rette for erfarings- og kunnskapsdeling på tvers.
Utvalget vurderer videre at KI-støttet læringsanalyse kan styrke grunnlaget for kvalitetsutvikling og legge til rette for mer løpende oppfølging av studiekvaliteten, både på individnivå, i enkeltemner og studieprogram, og på institusjonelt og nasjonalt nivå. Det forutsetter tilgang på relevant datagrunnlag, forsvarlige rammer for personvern og datasikkerhet, nødvendig kompetanseutvikling, medvirkning fra fagmiljøene samt institusjonell kapasitet.
Selv om KI-systemer kan være nyttige støtteverktøy i kvalitetsarbeidet, kan det ikke erstatte faglige og skjønnsmessige vurderinger. Kvalitet i høyere utdanning er flerdimensjonal og må fortsatt vurderes i lys av faglige mål, pedagogiske hensyn, studentenes rettigheter og forhold ved den enkelte institusjon.
9.7 Anbefalinger
Utvalget anbefaler universiteter og høyskoler å
-
sørge for gode rammer for faglig-pedagogisk arbeid med å utvikle utdanningene i lys av KIs betydning for utdanningskvaliteten
-
sørge for at følgende blir vurdert som en del av det ordinære kvalitetsarbeidet:
-
KIs påvirkning på kvalitetsaspekter ved studietilbudene, nærmere bestemt studietilbudenes læringsinnhold, læringsaktiviteter, vurderingsaktiviteter, læringsmiljø og samfunns- og arbeidslivsrelevans
-
fagmiljøenes samlede KI-kompetanse
-
-
utforske og over tid utvikle bruken av KI-støttet læringsanalyse som grunnlag for den løpende kvalitetsutviklingen
-
utforske bruk av KI-systemer til sammenstilling og analyse av ikke-standardiserte data som grunnlag for kvalitetsutvikling
Utvalget anbefaler sentrale myndigheter å
-
legge til rette for kunnskapsdeling på tvers av institusjoner og fagområder om bruk av KI-systemer og læringsanalyse i kvalitetsarbeid
-
innføre konkurransebaserte tilskuddsordninger for å styrke det faglig-pedagogiske arbeidet med å utvikle utdanningene i lys av KIs betydning for utdanningskvaliteten
-
videreutvikle tilsyns- og evalueringspraksis slik at institusjonenes arbeid med KI inngår i vurderingen av det systematiske kvalitetsarbeidet
-
legge til rette for innsamling og utnytting av data som er tilgjengelig ved institusjonene
10 Universitets- og høyskoleansattes kompetanse
Kunstig intelligens (KI) har en omfattende innvirkning på høyere utdanning og dermed på hva slags kompetanse det er behov for på universiteter og høyskoler. KI påvirker hva vi skal lære, hvordan vi lærer og hvordan vi kan dokumentere et læringsutbytte. I tillegg er KI en krevende teknologi å forvalte på en forsvarlig måte. For at KI skal bli tatt i bruk på forsvarlig og formålstjenlig vis i høyere utdanning, behøver universitets- og høyskoleansatte kunnskap om og ferdigheter med teknologien.
Riktig kompetanse hos ansatte vil bidra til at de kan treffe bedre beslutninger i møte med spekteret av KI-relaterte problemstillinger. Dette støttes av mange av innspillene utvalget har fått og av en rapport fra Direktoratet for høyere utdanning og kompetanse (HK-dir) om KI i UH-sektoren (HK-dir, 2025b).
Dette kapittelet utdyper betydningen av kompetanse for god studiekvalitet, skisserer et rammeverk for KI-kompetanse hos de ansatte, skiller i den sammenheng mellom behovet for felles minimumskompetanse og for mer differensiert KI-kompetanse, og plasserer ansvaret for kompetanseutvikling hos både fagmiljøene, den enkelte ansatte og institusjonen. Til sist følger utvalgets anbefalinger.
10.1 En forutsetning for god studiekvalitet
Behovene for KI-kompetanse hos universitets- og høyskoleansatte kan utledes av formålene med høyere utdanning (jf. kap. 2), som innebærer å gi studentene nødvendige kunnskaper og ferdigheter til å forstå og håndtere fremtidige utfordringer, og å være en arena for utvikling av selvstendige og kritisk tenkende samfunnsborgere. For å kunne innfri dette, må ansatte ha kompetanse om teknologiens virkemåte, effekter på individ og samfunn, fagspesifikke anvendelser, virkninger på læring og vurdering, og hva som skal til for å sikre forsvarlig bruk.
Kapittel 5 viser hvorfor det er ønskelig at studentene utvikler fagspesifikke ferdigheter i bruk av KI-systemer og fagspesifikk kunnskap om KI som teknologi. Slike ferdigheter og slik kunnskap tjener både formålet om samfunns- og arbeidslivsrelevans og formålet om faglig kvalitet i en ny tid. For at studentene skal kunne tilegne seg dette, må underviserne ha tilstrekkelig kunnskap om KI på eget fagområde til å kunne støtte og veilede studentene. Tilsvarende gjelder også for generell KI-kompetanse: Skal universitetene og høyskolene kunne tilby emner som er egnet til å gi studentene en grunnleggende forståelse av teknologien og problemstillingene den reiser, trenger de undervisere med rett kompetanse.
Kapittel 6 viser hvordan KI griper inn i forutsetningene for studentenes læring. På sitt beste gir KI-systemer muligheter for persontilpassede forklaringer og læringsfremmende tilbakemeldinger i en helt ny skala; på sitt verste kan bruk av KI-systemer kortslutte læringsprosesser. Mens ni av ti studenter ifølge Studiebarometeret 2025 bruker KI i studiearbeidet, oppgir kun to av ti at de får tilstrekkelig opplæring (HK-dir, 2026b). Skal underviserne kunne legge opp KI-bevisste læringsaktiviteter og veilede studentene i god bruk av tilgjengelige KI-systemer, har de behov for anvendbar kunnskap i skjæringsfeltet mellom KI og læring. Dette tjener også som en forutsetning for godt faglig-pedagogisk utviklingsarbeid, som omtalt i kapittel 9.
Kapittel 7 viser at også forutsetningene for vurdering av læring blir vesentlig endret av KI. Det dreier seg om hvordan man kan gjennomføre vurdering og eksamen på en måte som både fremmer og gir en reell prøving av læringsutbyttet studentene skal utvikle. Det dreier seg også om hvordan KI-systemer kan brukes av universitetene og høyskolene som verktøy for å gi studentene tilbakemeldinger eller i utformingen av oppgaver og vurderingsformer. Skal universitetene og høyskolene utvikle gode, KI-bevisste vurderingsformer og dra nytte av de mulighetene KI gir for utvikling og gjennomføring av vurdering, har de behov for kunnskap om problemstillingene og ferdigheter med teknologien.
Kapittel 8 viser at når KI-systemer skal brukes og forvaltes på en forsvarlig måte, innebærer det å ta en rekke hensyn til personvern, datasikkerhet, opphavsrett, bærekraft mv. Som beskrevet, stiller også KI-forordningen krav om at universiteter og høyskoler – i kraft av rollen som idriftsettere eller leverandører av KI-systemer – treffer tiltak som sikrer at de har et nødvendig nivå av KI-kompetanse.
Kapittel 9 viser at KI stiller fagmiljøene overfor flere utfordringer i det faglig-pedagogiske utviklingsarbeidet. Emneinnhold, læringsaktiviteter og vurderingsformer kan måtte endres for å møte samfunnets og arbeidslivets behov og for å ivareta kvaliteten i utdanningene. Ansattes kompetanse er videre en forutsetning for god helhet og sammenheng i studieprogrammene. Dersom faglærere innenfor samme program gir for uklare eller forskjellige signaler om bruk av KI-systemer – utover den legitime faglige uenigheten som vil finnes om bruk av KI-systemer i undervisningen innenfor et fag og et program – kan det svekke studentenes forståelse av hva som er faglig og akademisk forsvarlig. Det kan gå ut over både studentenes læringsutbytte, prestasjoner og rettssikkerhet i vurderingssituasjoner. Studentenes fagspesifikke KI-kompetanse vil dessuten utvikles over tid, med progresjon som kan spenne over flere enkeltemner. Institusjonene og fagmiljøene må derfor sørge for nødvendig samordning, samtidig som det skal være rom for forsøk og faglig begrunnet variasjon. Det er også viktig å anerkjenne at det er variasjon ikke bare i fagpersoners kompetanse om KI, men også deres holdninger til bruk av KI-systemer. Dette kan igjen påvirke arbeidet med kompetanseheving blant ansatte.
10.2 Kompetanseområder
Problemstillingene som er beskrevet i foregående kapitler peker mot et sammensatt behov for teknisk, utdanningsfaglig, etisk, juridisk og fagspesifikk kompetanse blant ansatte ved universiteter og høyskoler. Det konkrete behovet vil variere fra et fagområde til et annet og mellom ulike roller i organisasjonen.
10.2.1 DECs rammeverk for KI-kompetanse
Kapittel 5 viser til en rekke rammeverk som er blitt utviklet for å kartlegge behovene for KI-kompetanse, såkalte AI literacy frameworks. Etter utvalgets vurdering er Digital Education Councils (DECs) rammeverk det nyttigste av etablerte rammeverk, for arbeid med KI-kompetanse i høyere utdanning. Dette internasjonale rammeverket dekker både generell KI-kompetanse og kompetanse tilpasset spesifikke fag, roller og kontekster. Som nevnt er rammeverket laget for høyere utdanning. Kapittel 5 viser hvordan DEC-rammeverket kan brukes som et grunnlag for beskrivelser av den KI-kompetansen studenter har behov for å utvikle.
Utvalget mener rammeverket også er et nyttig utgangspunkt for arbeidet med ansattes KI-kompetanse, forutsatt at det fortolkes i lys av fagspesifikke behov og de ansattes ulike roller ved institusjonene. En fordel ved å bruke dette rammeverket er at det også benyttes i internasjonale kartlegginger av KI-kompetanse i høyere utdanning, både blant studenter og ansatte (Digital Education Council, 2026a). Det kan gi norske institusjoner et nyttig grunnlag for å sammenligne kompetansenivåer og følge utviklingen over tid.
Figur 10.1, fremstilt i kapittel 5 og gjengitt her, viser DECs inndeling av ulike kompetanseområder («dimensjoner»).
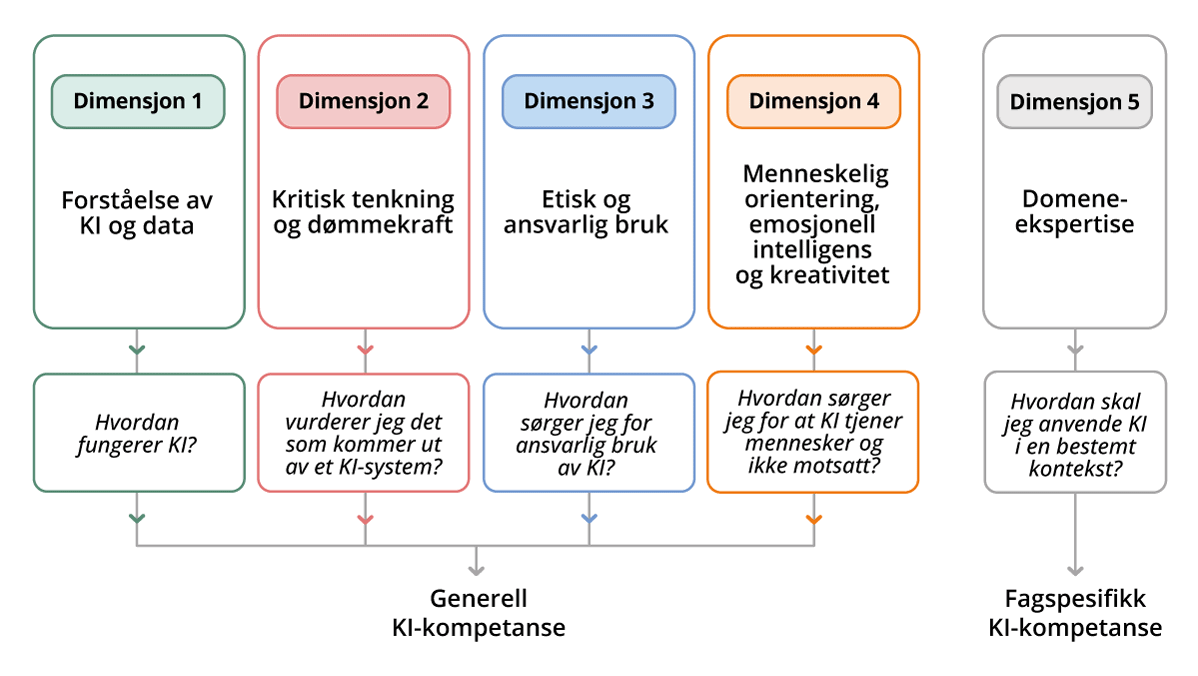
Figur 10.1 Kompetanseområder i DECs rammeverk for KI-kompetanse
Utvalgets oversettelse og reproduksjon av DECs figur.
Kilde: Digital Education Council (2025a)
De fire første kompetanseområdene i DECs rammeverk omfatter generell KI-kompetanse. Det femte er domeneekspertise, som omfatter den spesialiserte kunnskapen og ferdighetene som er nødvendige for å forstå, vurdere og håndtere KI i en undervisningskontekst og i faglige kontekster.
Vitenskapelig ansatte ved UH-institusjonene har nytte av to ulike (men tilknyttede) former for domeneekspertise. Den første handler om den fagspesifikke KI-kompetansen de besitter som utøvere av fag som sosiologi, matematikk, lingvistikk, medisin osv. Den andre handler om KI-kompetansen de trenger i egenskap av å være undervisere som skal utvikle KI-bevisste undervisnings- og vurderingsaktiviteter; deres utdanningsfaglige KI-kompetanse. Sistnevnte form for domeneekspertise kan variere på tvers av fag. Likevel er det en større grad av overlapp. DEC utbroderer denne formen for domeneekspertise for undervisere, se Tabell 10.1.
Tabell 10.1 Utdanningsfaglig domeneekspertise i DECs rammeverk
|
Underkategorier til utdanningsfaglig domeneekspertise |
Eksempel på ferdighet |
|---|---|
|
Å fremme studenters kritiske tenkning og læring i møte med KI |
Å gi studentene forståelse av risikoene ved kognitiv avlastning |
|
Å gi studentene generell KI-kompetanse |
Å forklare hva som ligger i KI-relaterte begreper |
|
Pedagogisk innovasjon |
Å kunne utnytte mulighetene KI gir for person- og gruppetilpasning |
|
Tilpasningsdyktighet |
Å identifisere hvordan KI endrer fag og profesjoner, og respondere hensiktsmessig |
|
Etisk og ansvarlig KI |
Å identifisere risikoer knyttet til skjevheter, diskriminering og feilinformasjon |
Tabellen gir en forenklet fremstilling. DEC definerer tre mestringsnivåer for hver kompetansekategori, med tre eksempler på ferdigheter innenfor hvert mestringsnivå.
Kilde: Basert på og oversatt fra Digital Education Council (2025a, s. 18–19)
10.2.2 Utvalgets vurdering
DECs rammeverk gir gjennom de fire første kompetanseområdene en nyttig beskrivelse av hva generell KI-kompetanse er (jf. kap. 5). Universitets- og høyskoleansatte har behov for slik kompetanse av ulike grunner. For det første har de på lik linje med studentene behov for å forstå teknologien og hvordan den brukes på en ansvarlig måte, og for å kunne tenke kritisk om den. Dette har nytteverdi i deres egen bruk av KI-systemer, i tillegg til å ha verdi for hva undervisere kan lære studentene. Videre er generell KI-kompetanse viktig som en forutsetning for det som kalles domeneekspertise i rammeverket.
Domeneekspertise er en svært viktig dimensjon i DECs rammeverk. For vitenskapelig ansatte omfatter den som nevnt både utdanningsfaglig KI-kompetanse og fagspesifikk KI-kompetanse. Begge typer kompetanse har stor betydning, av ulike grunner.
Utdanningsfaglig KI-kompetanse er verdifullt for alle undervisere. Fordi KI endrer forutsetningene for læring og de aller fleste studenter bruker KI-systemer i et eller annet monn, berører dette alle undervisere, også dem som ikke selv bruker KI-systemer. Når undervisere skal utvikle hensiktsmessige lærings- og vurderingsaktiviteter i en tid med generativ KI, har de behov for å forstå hvilke muligheter KI-systemene gir i læringsprosessen, hvordan ukritisk bruk kan forstyrre læringsprosesser og svekke læringsutbyttet, og betydningen teknologien har for hvordan man gjennomfører vurdering.
De ansattes fagspesifikke KI-kompetanse er i denne sammenhengen en viktig forutsetning for at studenter kan utvikle fagspesifikk KI-kompetanse. Uten undervisere som vet hvordan de kan utnytte de spesifikke mulighetene KI-systemer gir i det respektive fag, kan universitetene og høyskolene vanskelig hjelpe studentene til å utvikle fagspesifikke ferdigheter i bruk av KI-systemer. Det går i så fall på bekostning både av utdanningenes samfunns- og arbeidslivsrelevans, og i flere tilfeller også den faglige kvaliteten. Tilgang på undervisere med fagspesifikk KI-kompetanse kan altså være svært betydningsfullt for studiekvaliteten.
Utvalget understreker at de fem kompetanseområdene i DECs rammeverk ikke kan betraktes som sideordnede ved at de tillegges lik vekt og fungerer uavhengig av hverandre. Høy kompetanse på ett område kompenserer ikke for lav kompetanse på et annet. Man kan for eksempel ikke vurdere om KI-generert innhold er faglig relevant, metodisk holdbart eller normativt forsvarlig, uten å ha innsikt i det aktuelle fagområdets kunnskapsgrunnlag, terminologi, metoder, normer og kvalitetsforståelser. Tilsvarende er det nødvendig med en viss teknologiforståelse for å kunne vurdere KI-modellers begrensninger og feilkilder, uansett hvor godt man kjenner eget fagområde. Evnen til kritisk og ansvarlig bruk av KI i høyere utdanning formes gjennom et samspill av flere former for kunnskap, ferdigheter og vurderingsevne.
Den kompetansen som i DECs rammeverk er beskrevet under dimensjonen «etisk og ansvarlig bruk», har betydning for alle ansatte som skal ha tilgang på KI-systemer. Men universiteter og høyskoler har også behov for ansatte med en dypere forståelse av de etiske, juridiske og sikkerhetsmessige problemstillingene KI reiser. Som forvaltere av KI-systemer (jf. kap. 8) må universitetene og høyskolene gjøre flere krevende etiske, juridiske og sikkerhetsmessige vurderinger knyttet til anskaffelse og drift. Det dreier seg blant annet om personvern, diskriminering, opphavsrett, språkpolitikk og bærekraft, og å kunne gjøre relevante risikovurderinger knyttet til KI-bruk i undervisning, vurdering og til administrative oppgaver. I tillegg må institusjonene sørge for at bruken er forankret i menneskelige verdier og tar hensyn til menneskelige egenskaper og ferdigheter. Det krever innsikt i hvordan KI påvirker menneskers atferd, beslutninger og samspill, og hvordan man ivaretar menneskelige verdier som empati, kreativitet, intellektuell nysgjerrighet, kommunikasjon og inkludering i studentenes læringsmiljø.
10.3 Minimumskompetanse og differensiering
Behovene for KI-kompetanse vil variere mellom ulike grupper av ansatte. Krav til kvalitet, faglig forsvarlighet og sammenheng i studietilbudet innebærer at alle som arbeider innen høyere utdanning, uavhengig av rolle, bør ha et visst nivå av kunnskap om teknologien og ansvarlig bruk av den. Et slikt minimumskrav kan kobles til ferdighetsnivå 1 i DECs rammeverk (Digital Education Council, 2025a). Det vil gi en grunnleggende forståelse av hva KI er, hvordan KI-systemer fungerer, hva de kan brukes til og hvilke begrensninger de har. I dette inngår kunnskap om hvordan KI påvirker menneskelig atferd, forståelse av risiko knyttet til skjevhet, feilinformasjon og diskriminering, samt evne til å ta i bruk enkle KI-verktøy på en ansvarlig og kritisk måte i eget arbeid. I tillegg bør alle ansatte ha basiskunnskaper om sentrale etiske og juridiske problemstillinger knyttet til KI-bruk, som personvern, opphavsrett, datasikkerhet og saksbehandlingsregler.
Utover denne grunnleggende kunnskapen vil vitenskapelig ansatte trenge å forstå hvordan KI påvirker eget fag, undervisning og vurdering. Slik domenespesifikk kompetanse er nært knyttet til forskning, som i sin tur påvirker og brukes i undervisningen. Utdanningsledere trenger i tillegg å kunne vurdere konsekvenser for studieprogramutvikling, kvalitet og sammenheng på tvers av emner, og om utdanningene er egnet til å møte endrede behov i samfunnet og arbeidslivet når studentene uteksamineres.
Teknisk-administrative ansatte har på sin side behov for kompetanse om regelverk, anskaffelser, informasjonssikkerhet, personvern og drift av systemer, samt forsvarlig bruk av KI i administrativ støtte til studenter og undervisere.
Ansatte i nøkkelroller og utvalgte støttefunksjoner vil ha behov for særlig spesialisert KI-kompetanse på sine områder, for eksempel knyttet til juridiske rammer for anskaffelse, forvaltning og bruk av KI-systemer, tekniske forhold rundt utvikling, styring og drift av systemene, datasikkerhet og risikovurdering, eller vurderingsdesign og utdanningsfaglig støtte.
I lys av disse forskjellene bør institusjonene utvikle differensierte kompetansehevingstiltak tilpasset ulike roller og funksjoner.
10.4 Individuelt og institusjonelt ansvar for kompetanseutvikling
Utvalget legger til grunn at fagmiljøene og den enkelte ansatte har ansvar for å utvikle sin generelle, fagspesifikke og utdanningsfaglige KI-kompetanse. Universitets- og høyskoleforskriften § 1-12 slår fast at «[f]agmiljøet skal ha relevant utdanningsfaglig kompetanse i universitets- og høyskolepedagogikk og -didaktikk, samt kompetanse til å utnytte digital teknologi for å fremme læring.» Videre sier forskriften at «[i]nstitusjonen skal legge til rette for oppdatering og utvikling av fagmiljøets kompetanse». Forskriften stiller også krav til utdanningsfaglig kompetanse hos den enkelte ansatte i undervisnings- og forskningsstillinger (jf. § 3-8).
Ansvaret for å tilegne seg den nødvendige kompetansen påhviler altså fagmiljøene og den enkelte ansatte, mens institusjonene skal legge forholdene til rette. Utvalget vurderer at dette er en hensiktsmessig fordeling av ansvar, og en som er i tråd med den akademiske friheten.
Som vist i kapittel 10.1 er KI-kompetanse blitt en nødvendig del av den utdanningsfaglige kompetansen til universitets- og høyskoleansatte. Uavhengig av om ansatte selv bruker KI i sin undervisnings- og forskningspraksis, må de kunne støtte studentene i å utvikle nødvendig KI-kompetanse. De må blant annet kunne veilede studenter i forsvarlig bruk av KI-systemer i studiearbeid. Forventninger til at ansatte sørger for å utvikle og styrke sin egen KI-kompetanse ligger innenfor institusjonenes ansvar for å sikre faglig kvalitet og sammenheng i studieprogrammene. Rammene for kompetanseutviklingen bør like fullt utformes i dialog med fagmiljøene, ansatte- og studentrepresentanter og relevante støttefunksjoner.
KI-forordningen stiller i artikkel 4 krav om at leverandører og idriftsettere av KI-systemer skal treffe tiltak for å sikre «et tilstrekkelig nivå av KI-kompetanse» hos egne ansatte og andre som opererer eller bruker KI-systemer på deres vegne, tilpasset kontekst og risikonivå. HK-dirs temarapport KI-forordningen kort fortalt (2026a) viser nødvendigheten av å gjennomføre relevante opplærings- og informasjonstiltak i UH-sektoren. Rapporten peker på at EU-kommisjonens samling med eksempler på kompetansehevende tiltak kan være til nytte i dette arbeidet (EU-kommisjonen, u.å.).
Institusjonene har dermed ansvar for å tilby kompetanseutvikling og for å sikre tilstrekkelig etisk, juridisk og forvaltningsmessig kompetanse knyttet til KI i virksomheten. Gjennom samarbeid og kunnskapsdeling kan fagmiljøer samordne innhold og nivå på opplæringen og dra nytte av hverandres ressurser, både innad i og på tvers av institusjoner. Systematisk deling av erfaringer fra forsøksprosjekter og gjennomførte tiltak kan styrke utviklingsarbeidet. Dette kan for eksempel organiseres gjennom Universitets- og høyskolerådet (UHR) eller dedikerte sentre.
KI-kompetanse er ikke noe som kan etableres én gang for alle. Teknologien er i utvikling, og både verktøy, praksis, regelverk og forventninger til ansvarlig bruk er i endring. Det er også store forskjeller mellom fagområder. Det samme gjelder påvirkningen teknologien har på arbeids- og samfunnsliv. Kompetanseutvikling bør derfor anses som et utviklingsområde der ansatte får mulighet til kunnskapsoppdatering, utprøving, refleksjon og erfaringsdeling. Opplæringen må bygge på oppdatert, forskningsbasert kunnskap. Sentrale myndigheter kan bidra ved å skape plattformer for samarbeid, tilby regulatoriske sandkasser for utvikling av ny juridisk, etisk og teknisk kompetanse, og legge til rette for utviklingsprosjekter.
10.4.1 Utvalgets vurdering
Ansattes KI-kompetanse kan ikke forstås som et tillegg til eksisterende kompetansekrav, men som en videreutvikling av fagspesifikk, utdanningsfaglig og administrativ kompetanse. Det er ikke tilstrekkelig at utvalgte fagmiljøer eller enkeltpersoner bygger opp høy kompetanse; institusjonene bør sørge for at alle ansatte har et minimumsnivå av KI-kompetanse (jf. kap. 10.3), og sikre tilgang til spesialisert støtte der risiko og kompleksitet tilsier det. Kompetanseutviklingen bør foregå i lys av rolle og kontekst, knyttes til konkrete arbeidsoppgaver og være integrert i institusjonenes kvalitets- og styringsarbeid.
UHRs veiledende retningslinjer for UH-pedagogisk basiskompetanse svarer på universitets- og høyskoleforskriftens krav om pedagogisk og didaktisk kompetanse for undervisere, og gir en overordnet nasjonal ramme for institusjonenes arbeid med dette. Det er derfor naturlig å legge grunnleggende kunnskap om KI og ansvarlig bruk av KI-systemer inn i disse retningslinjene. De nasjonale retningslinjene er formulert på formålsnivå, og det er opp til den enkelte institusjon å utforme mer presise kvalifikasjonsmål tilpasset fagområdenes spesifikke behov (Universitets- og høgskolerådet, 2018). De fleste universiteter og høyskoler har utdanningstilbud der ansatte kan tilegne seg denne basiskompetansen, som gjerne går under navnet UH-ped, universitetspedagogikk eller uniped. Samtidig må det legges til rette for at ansatte som allerede har gjennomført denne typen opplæring, får anledning til å videreutvikle sin kompetanse.
Arbeidet med kompetanseutvikling bør innrettes slik at det fremmer endring i praksis. Det tilsier en kombinasjon av rollebaserte opplæringsløp, tilrettelegging for kollegaveiledning og arenaer for deling av undervisnings- og vurderingsopplegg der KI inngår. Erfaringer fra kvalitetsarbeid i sektoren viser at tiltak som kobles til konkrete utviklingsoppgaver på studieprogramnivå oppleves som mer virkningsfulle enn tiltak som står alene (Slette et al., 2025). HK-dir legger vekt på at institusjonene bør ha en lav terskel for å la ansatte prøve ut teknologien, støttet opp av en mer systematisk tilnærming til kompetanseheving og bruk av KI i organisasjonen samlet sett (HK-dir, 2025b).
For å unngå store forskjeller i institusjonenes evne til å håndtere KI på en faglig innovativ og etisk forsvarlig måte, bør nasjonale myndigheter og sentrale aktører i sektoren legge til rette for deling av ressurser og samarbeid om kompetansehevende tiltak (HK-dir, 2025b). Det kan bidra til standardisering av kompetansekrav og effektiv utnyttelse av opplæringsressurser på tvers av institusjoner og fagmiljøer.
Høyere utdanning kjennetegnes ved at den er forsknings- og praksisnær. Utvikling av fagspesifikk KI-kompetanse skjer gjennom forskning og annet faglig utviklingsarbeid, som i sin tur ligger til grunn for arbeid med å integrere KI i undervisning og veiledning. Kunnskapen om hvordan fagutøvelsen endres i møtet med KI ligger hos de vitenskapelig ansatte og fagmiljøene. Endringsprosessen skjer gjennom det faglige utviklingsarbeidet, men hastigheten kan avhenge av faktorer som kvalitet på forskningen, aktivitetsnivå, grad av internasjonalisering og grad av konkurranse. For å sørge for at ansatte og fagmiljøer utvikler fagspesifikk KI-kompetanse, må institusjonene påskynde prosessen ved å stimulere til faglige aktiviteter som integrerer KI i forskning og faglig praksis der det er faglig relevant. Det kan skje gjennom å prioritere støtte til initiativer som integrerer KI i faglige problemstillinger og forskning, og gjennom strategiske ansettelser og satsinger for å styrke fagmiljøenes tilgang på eksisterende KI-kompetanse. Det er utvalgets vurdering at en slik omstilling haster for at ansatte skal utvikle tilstrekkelig fagspesifikk KI-kompetanse til å kunne tilby studentene utdanning av god kvalitet i en tid preget av KI.
Som omtalt i kapittel 9 bør kompetanseutviklingen inngå i institusjonenes arbeid med faglig-pedagogisk utvikling og systematisk kvalitetsarbeid. Det innebærer å vurdere om fagmiljøene samlet har tilstrekkelig KI-kompetanse til å følge opp endringer i undervisning, vurdering, læringsmiljø og studieprogramutvikling, blant annet gjennom periodiske programevalueringer.
Å gjøre institusjonene i stand til å tilby opplæring til sine ansatte i det omfanget som er nødvendig, vil kreve et stort løft. Tid, kompetanse og kapasitet til gjennomføring av slike opplæringstiltak kan avhenge av økt støtte til sektoren i en overgangsperiode. Sektoren kan også ha noen områder hvor bruk av KI kan effektivisere oppgaver og dermed frigjøre noen ressurser som kan omprioriteres.
Boks 10.1 Deling av læringsressurser
Flanders AI Academy (VAIA) er en belgisk plattform der universiteter og andre tilbydere deler videoforelesninger, kurs, seminarer, sommerskoler og andre opplæringstilbud på engelsk og nederlandsk. Innholdet kan være knyttet til spesifikke fagområder og kompetansenivåer, og retter seg mot arbeidstakere i alle sektorer, inkludert undervisere, forskere, teknisk og administrativt personale og beslutningstakere i høyere utdanning. Plattformen legger til rette for kunnskapsdeling nedenfra og opp, og her finner man både enkeltmoduler om spesifikke tema og komplette opplæringsløp tilpasset universiteter og høyskoler.
Kilde: VAIA, u.å.
10.5 Anbefalinger
Utvalget anbefaler universiteter og høyskoler å
-
sørge for at alle undervisere har generell KI-kompetanse og utdanningsfaglig KI-kompetanse
-
tydeliggjøre krav til KI-kompetanse for andre roller
-
sørge for og støtte utviklingen av fagspesifikk KI-kompetanse i sine fagmiljøer
-
samarbeide med andre institusjoner om kompetanseutvikling
-
sørge for samarbeid om kompetanseutvikling mellom enheter på egen institusjon
Utvalget anbefaler sentrale myndigheter å
-
følge opp institusjonenes arbeid med utvikling av KI-kompetanse i styringsdialogen
11 Fremtidsbilder for norsk høyere utdanning
Endring er ikke noe nytt for universitets- og høyskolesektoren. Europas første universiteter ble etablert i middelalderen, med linjer som kan trekkes tilbake til antikkens læreseter, og for om lag to hundre år siden fikk Norge sitt første universitet. Gjennom hundreårene har universitetene og høyskolene utviklet seg, både som følge av teknologiske fremskritt, endringer i samfunnsmessige, kulturelle, økonomiske og sosiale forhold, utviklingen av stater og embetsverk mv. I kraft av sin samfunnsrolle har institusjonene også selv vært drivere av endring, gjennom kunnskapsutvikling, samfunnskritikk og i dyrkingen av akademiske idealer, som akademisk frihet, sannhetssøking og saklighet.
Som denne rapporten viser, bringer fremskrittene innen kunstig intelligens (KI) med seg både muligheter, utfordringer og en rekke dilemmaer som griper inn i kjernen av institusjonenes virksomhet. Fremtidens samfunn vil på ulike måter være preget av den nye teknologien. Hvilken rolle høyere utdanning vil spille i dette avhenger av hvordan sektoren håndterer de mulighetene og utfordringene vi ser i dag, og de som vil vise seg senere. Hvordan situasjonen vil se ut fremover, bestemmes ikke bare av utviklingen i KI-kapabiliteter, men også av samspillet mellom teknologiutvikling, politiske prioriteringer, arbeidslivets behov, normer og endringer i fagene og valg som gjøres ved institusjonene.
Utvalgets arbeid skal i henhold til mandatet basere seg på det som finnes av relevante KI-teknologier mens utredningen pågår. Samtidig er utvalget bedt om å drøfte hvilke antakelser det er rimelig å legge til grunn om hvilken retning teknologiutviklingen tar, være føre var og vurdere konsekvensene en slik utvikling vil ha for høyere utdanning. Denne tilnærmingen ligger nær det som kalles foregripende styring (Guston, 2014).
KI-utviklingen er preget av stor usikkerhet og påvirkes av en rekke ulike faktorer, til dels på globalt nivå og langt utenfor universitets- og høyskolesektorens og norske myndigheters kontroll. Det vil like fullt være viktig for sektoren og myndighetene å forberede seg på hvordan teknologien og bruken av den kan utvikle seg fremover. Som et bidrag til det vil utvalget i dette kapittelet skissere noen mulige fremtidsbilder. Fremtidsbildene bygger på utviklingstrekk som det er betydelig usikkerhet om. Helt til sist trekkes det frem noen oppgaver som fremstår som særlig viktige for universiteter og høyskoler i tiden fremover, på tvers av scenarioene.
11.1 Usikkerhet i flere dimensjoner
De følgende betraktningene omkring mulige fremtidsbilder er ikke knyttet til bestemte akser i en scenariomodell, men bygger på flere underliggende dimensjoner som kan gjøre seg gjeldende i større eller mindre grad. Vi kan peke på fire dimensjoner av usikkerhet:
-
Den første gjelder selve teknologiutviklingen: hvor raskt systemene blir bedre, og på hvilke områder. Dette er hovedtemaet for OECD sine scenariobeskrivelser som er omtalt i kapittel 3.7. Scenarioene spenner fra stagnasjon til at utviklingen akselerer og nye fremskritt kommer enda raskere enn før. Innenfor scenarioene kan det være variasjoner i utviklingstakten mellom ulike kapabiliteter, som språk, evne til å tolke visuell informasjon og fysisk interaksjon med omgivelsene. En annen variabel er graden av integrering og oppskalering av agentisk KI. Strategiske beslutninger hos store teknologileverandører, internasjonale konkurranseforhold og tilgang på regnekraft vil også kunne styre hvilke kapabiliteter som vil være tilgjengelige for sektoren, og til hvilken pris.
-
Arbeidslivets behov er en annen sentral dimensjon. Kompetansebehovsutvalget (KBU) sin temarapport om digital omstilling (2025) skisserer fire ulike scenarioer for fremtidens arbeidskraft- og kompetansebehov (se kap. 5.5.1). KBU argumenterer for å sikte mot et scenario de kaller «integrert samspill», der bruken av KI-teknologi er dypere integrert enn i dag og den i større grad virker komplementært til arbeidskraften, fremfor å fortrenge den. Det innebærer en vridning mot yrker der arbeidstakere må kombinere fagkompetanse med en mer avansert KI-forståelse. Etter KBUs forståelse medfører dette økt behov for spesialisert digital kompetanse, kritisk tenkning, etisk og juridisk kompetanse og innovasjonskompetanse. I tillegg til å belyse hva slags arbeidsmarked fremtidens universitets- og høyskolekandidater skal utdannes til, kan deler av KBUs analyse også overføres til sektoren som arbeidsplass, der graden av KI-integrasjon og rollefordelingen mellom mennesker, maskiner og ulike faglige kompetanser vil ha stor betydning for utviklingen fremover. Samtidig kan utbredelsen og anvendelsen av KI innen høyere utdanning komme til å arte seg annerledes enn i arbeidslivet ellers.
-
En tredje usikkerhetsdimensjon gjelder samfunnets respons: tillit, motstand, regulering, oppfatninger av ansvarlig bruk, samt politiske avveininger mellom behovet for innovasjon og konkurransekraft på den ene siden og hensyn til personvern, sikkerhet, bærekraft og demokratisk kontroll på den andre. Det geopolitiske bakteppet spiller sterkt inn her, ved at USA, Kina og Europa følger ulike spor. EU har gjennom KI-forordningen etablert et omfattende risikobasert rammeverk med sterk vekt på rettigheter og sikkerhet, mens den amerikanske tilnærmingen er mer markedsdrevet. Kina kombinerer sentral styring med pragmatisk sektorbasert regulering og relativt fleksibel håndheving for å støtte innovasjon. Globale spenninger knyttet til handel og konkurransekraft innebærer at det regulatoriske landskapet vil fortsette å være i endring (Chun et al., 2024).
-
Den siste dimensjonen handler om hvordan sektoren og institusjonene selv forholder seg til utviklingen og de mulighetene og utfordringene som oppstår.
På grunnlag av disse fire usikkerhetsdimensjonene kan vi se for oss flere ulike utviklingsretninger for hvordan KI vil virke inn på norsk universitets- og høyskolesektor.
11.2 Målbilde: videreutvikling av dagens institusjoner
La oss ta utgangspunkt i en ønsket fremtidig situasjon – sett fra universitets- og høyskolesektorens perspektiv – der institusjonene lykkes i å forholde seg til, og håndtere teknologien på en forsvarlig og formålstjenlig måte. Det vil innebære å legge til rette for god læring og treffsikker og tillitsverdig sertifisering av kandidater som kan bidra til å forme og ta del i en produktiv og bærekraftig økonomi, fremme fortsatt kunnskapsutvikling og utøve kritisk medborgerskap. For institusjonene handler det blant annet om å ha kontroll på teknologien og et tilstrekkelig handlingsrom til å kunne ta i bruk egnede systemer for egnede oppgaver på en egnet måte.
I foregående kapitler har utvalget søkt å klargjøre noen av premissene for at norsk høyere utdanning skal kunne nærme seg en slik idealsituasjon.
Som vist i kapittel 5, påvirker KI-utviklingen hva det er formålstjenlig å lære. Vi står overfor potensielt store endringer i hva slags læringsutbytte som vil ha størst nytteverdi. En risiko er å utdanne studentene til irrelevans, ved at studiene ikke er tilpasset det arbeidslivet og samfunnet studentene skal ta del i etter endt utdanning. Det krever at fagmiljøene regelmessig diskuterer og revurderer læringsinnholdet. På samme tid endrer KI vilkårene for gode læringsprosesser, som omtalt i kapittel 6. Brukes KI-systemer som erstatning for kognitiv anstrengelse, kan det hindre læring, og brukes KI-systemer som erstatning for interaksjon med undervisere og medstudenter, kan det gå utover læringsfellesskapet. Like fullt er det mulig å bruke KI-systemer til å styrke læringen gjennom blant annet individuell tilpasning og tilbakemeldinger på eget arbeid. Behovet for å endre vurderingsformer er beskrevet i kapittel 7. Dette er nødvendig for å gi læringsinsentiver og opprettholde tillit til den kompetansen vitnemålet stadfester.
Ved å tilpasse seg dette risikobildet, bygge opp nødvendig kompetanse (kapittel 8 og 10), justere læringsdesign og vurderingsformer og utnytte teknologien på adekvate måter (kapittel 9), kan universitets- og høyskolesektoren bevare og styrke sin rolle og ivareta samfunnets tillit. Det innebærer omfattende omstillinger og behov for kontinuerlig forbedringsarbeid. Det kan kreve kapasitet til å inngå strategiske samarbeid og involvere fagmiljøer og studenter i viktige veivalg. Det kan innebære behov for et sterkere infrastruktur- og styringslag for KI-teknologi i høyere utdanning, blant annet for å sikre langsiktige interesser som bedre kontroll over data og uavhengighet av leverandører. Slike løsninger kan også påvirke utviklingen av tilsvarende løsninger i andre deler av utdanningssystemet.
Samtidig kan denne typen endringer innebære nye utfordringer for institusjoner som ikke har tradisjon for sterk samordning, samt kreve en balansegang mot ansatte og studenters akademiske frihet.
Å lykkes med en slik omstilling innebærer ikke at alle utfordringer elimineres: Studenters KI-bruk vil fortsette å utfordre læringsprosesser og vurderinger. Teknologien påvirker samarbeidsforhold og relasjoner blant studentene og mellom studenter og undervisere. Studenter kan være mer opptatt av karakterer og gjennomføring enn av selve læringsprosessen, mens kampen om studentenes tid og oppmerksomhet fortsetter. I et geopolitisk landskap der tilgangen til data, skytjenester, avanserte brikker og beregningskapasitet i økende grad forstås som strategiske ressurser, blir dessuten spørsmål om digital suverenitet og institusjonenes robusthet, beredskap og handlefrihet mer presserende. Fremtidens utdanning vil stadig være i støpeskjeen.
11.3 Alternative fremtidsbilder
Fremtiden er usikker og avhenger av faktorer som ligger utenfor universitets- og høyskolesektoren. Som kontrast til målbildet beskrevet ovenfor, og for å belyse spennet i muligheter, tegner vi her opp tre alternative utviklingsretninger.
Utvalget har ikke funnet det hensiktsmessig å gå inn i de mest ytterliggående scenarioene for utviklingen av KI-kapabiliteter, som innebærer realisering av kunstig generell intelligens eller superintelligens med dramatiske samfunnsmessige konsekvenser.
Fremtidsbildene representerer dermed ikke alle tenkelige muligheter. De er heller ikke gjensidig utelukkende. Hensikten er ikke å fastslå hvor sannsynlig den ene eller andre retningen er, eller å ta høyde for alle eventualiteter. Utvalget ønsker isteden å tilby en innramming for å kunne vurdere hvilke implikasjoner teknologiutviklingen og institusjonenes måter å møte denne på kan ha for norsk høyere utdanning.
Fremtidsbildene er rene beskrivelser av en tenkt utvikling og gir ikke uttrykk for hvordan utvalget mener utviklingen bør gå.
11.3.1 Individualisert læring og krav om fleksibilitet
I dette fremtidsbildet gir en kraftigere forskyvning av kompetansebehov og raskere endringstakt i arbeidslivet økt etterspørsel etter løpende etter- og videreutdanning. Behovet for fleksibilitet og tilpasningsmuligheter vokser. Dette sammenfaller med at KI-systemer gir nye muligheter for persontilpasset læring, veiledning og tilbakemelding. Studenter kan få skreddersydde utdanningsopplegg tilpasset deres konkrete arbeidssituasjon og kompetansen de har fra før. Minikvalifikasjoner, det vil si mindre studietilbud som er ment å dokumentere avgrenset kompetanse, får økt betydning. I stor skala kan kombinasjoner av minikvalifikasjoner, bygget over tid, komme til å fortrenge lengre, sammenhengende studieprogrammer.
Utviklingen kan også føre til økt betydning av såkalt åpne universiteter, som tilbyr fleksible utdanningsløp – ofte digitale, basert på utstrakte selvstudier og uten strenge opptakskrav. Slike institusjoner kan både bli samarbeidspartnere med og konkurrenter til tradisjonelle universiteter og høyskoler, dersom de lykkes bedre med å møte etterspørselen etter fleksibel kompetanseutvikling.
Forholdet mellom campusbasert undervisning, digitale tilbud og læring i kombinasjon med jobb forskyves i dette bildet. Det kan utfordre opprettholdelsen av felles læringsarenaer, sammenhengen i studieprogrammene og oppfølgingen av studentene. Samtidig svarer det til drivkrefter og utviklingstrekk som fra før er tydelige i utdannings- og kompetansepolitikken, der fleksibilitet, tilgjengelighet og arbeidslivsrelevans løftes frem som sentrale hensyn.
Endringer i arbeidslivets kompetansebehov kan ha vidtrekkende konsekvenser i jobbmarkedet for nyutdannede, ved at behovet for juniorkompetanse i stor grad kan dekkes av kapable KI-systemer. Arbeidslivets funksjon som arena for spesialisering svekkes, samtidig som behovet for spesialisert kompetanse øker. Arbeidsgivere har ikke behov for nyutdannede juniorer, men for erfarne seniorer som kan styre og dra nytte av mulighetene som ligger i KI-systemene.
I et slikt fremtidsbilde får samspillet mellom arbeidslivet og utdanningsinstitusjonene avgjørende betydning. Det blir også viktig å avklare hvilke utdanninger og hvilke deler av utdanningsløpet som fortsatt krever fysiske møteplasser. Nærmest alle utdanninger vil måtte ta en grundig gjennomgang av læringsutbytte, læringsmetoder og vurdering. Universiteter og høyskoler må dessuten håndtere at de står både i et avhengighets- og et konkurranseforhold til leverandører av utdanningsteknologi. Mange læringsressurser er KI-baserte, og leverandørene får en stadig mer sentral rolle.
Dette fremtidsbildet har likhetstrekk med forventningene som ble knyttet til åpne nettkurs (MOOC) for vel ti år siden, og som ble utredet i Norge (NOU 2014: 5). Den gangen ble det spådd at fleksible, digitale kurs ville løse opp de tradisjonelle studieprogrammene, men det skjedde i liten grad. Fullføringsgraden var lav, deltakerne hadde i hovedsak høyere utdanning fra før, og tilbudene ble etter hvert tatt opp i institusjonenes ordinære virksomhet, inkludert etter- og videreutdanning (Reich & Ruipérez-Valiente, 2019). Det var blant annet fordi selvstudier krever god selvregulering, at arbeidsgivere fortsatte å etterspørre grader, og at tilbakemelding og faglig fellesskap var vanskelig å skalere (Reich, 2020). KI-systemer kan avhjelpe det siste, og endringer i arbeidslivets kompetansebehov kan gi et sterkere press enn MOOC-ene gjorde, men de øvrige hindrene består.
11.3.2 Et mer konkurranseutsatt utdanningsmarked
Store, internasjonale teknologiselskaper og andre nye tilbydere utvikler attraktive lærings-, veilednings- og sertifiseringstilbud som er gode til å treffe arbeidsmarkedets behov. Det gir et bredere tilfang av læringsressurser, men har også konsekvenser for hvordan læring organiseres, hvem som legger premissene for utvikling av kompetanse, og hvilke aktører som får tilgang til data om studentenes læringsmønstre og prestasjoner. I dette fremtidsbildet er kommersialiseringen og markedskonsentrasjonen selvforsterkende ved at de store aktørene befester sin posisjon, får tilgang til stadig mer treningsdata og blir vanskelige eller umulige for andre aktører å ta igjen. Dersom arbeidsgivere i økende grad anerkjenner kompetansebevis utstedt av teknologiselskaper eller internasjonale utdanningsaktører, kan universitetenes tradisjonelle rolle som sertifiseringsinstans bli svekket.
Universiteter og høyskoler møter da sterkere konkurranse om studenter og ressurser, noe som på sikt også vil utfordre deres posisjon som samfunnsutviklende og dannende institusjoner. Høyere utdanning preges av mer gjør-det-selv-læring, med studentene som kunder i et marked der klassisk akademisk renommé har mindre betydning enn effektiv og fleksibel gjennomføring av studiene. I ytterste konsekvens mister universitetene og høyskolene sin relevans som utdanningsarena og sertifiseringsinstans, og utvikler seg til rene forskningsinstitusjoner.
En slik utvikling kan presse institusjonene til å tilpasse seg rammeverk og plattformer de ikke selv kontrollerer. Skillet mellom utdanning og kommersielle tjenester kan bli mindre tydelig. I møte med en slik utvikling kan det bli viktig å bevare institusjonenes rolle som kunnskapsforvaltere, danningsarenaer og forskningsbasert utdanning. Her kan det oppstå forskjeller mellom institusjonene, eller mellom ulike fagområder, i hvor godt de evner å omstille seg. Det kan gi mer spesialiserte institusjoner, spisset mot å levere fremragende utdanning, mens øvrige behov dekkes av kommersielle aktører.
Dette fremtidsbildet har også forløpere. Barber et al. (2013) spådde at nye tilbydere ville overta deler av universitetenes oppgaver. Så langt har det skjedd i begrenset grad. Mange arbeidsgivere har fjernet formelle gradskrav, men ansetter i praksis nesten like få uten grad som før (Sigelman et al., 2024). I Norge gjør gratisprinsippet, akkreditering og lovregulerte yrker gradsstudiene mindre utsatt for konkurranse enn i land med høye studieavgifter, mens etter- og videreutdanning er mer utsatt. En mer nærliggende utvikling enn at institusjonene erstattes, er at de består, men blir avhengige av kommersielle plattformer og KI-systemer de ikke selv kontrollerer (Komljenovic, 2021).
11.3.3 Strammere styring og vekt på digital uavhengighet
I dette fremtidsbildet ledsages nye fremskritt i KI-kapabiliteter av en økende skepsis i befolkningen, basert på reelle og potensielle konsekvenser av måten teknologien blir tatt i bruk på. Det fører til et politisk press for sterkere regulering, nasjonalt og internasjonalt, med tydelige krav til ansvarlig bruk. Hensyn til personvern, opphavsrett, sikkerhet, bærekraft og demokratisk kontroll blir enda viktigere. I Europa kan dette allerede knyttes til en bredere politikk for teknologisk suverenitet og redusert avhengighet av ikke-europeiske leverandører (Europaparlamentet, 2025). I juni 2026 la EU-kommisjonen (2026b) frem en pakke for teknologisk suverenitet, med blant annet forslag til en forordning om utvikling av skytjenester og KI (Cloud and AI Development Act) og en strategi for åpen kildekode, som skal redusere avhengigheten av leverandører utenfor EU (EU-kommisjonen, 2026b). Samtidig er deler av de omfattende reguleringene i KI-forordningen moderert gjennom utsettelser og endringer (EU-kommisjonen, 2026a).
I USA har kontroverser omkring mulige anvendelser av KI i våpenteknologi og masseovervåkningssystemer satt søkelys på myndighetenes ansvar og evne til å sette etiske grenser, og på avveininger mellom behovet for en kontrollert teknologiutvikling og ønsket om å beholde ledelsen i det internasjonale KI-kappløpet. I april 2026 førte nyheten om at en ny KI-modell fra Anthropic var i stand til å finne store mengder sikkerhetshull som hadde ligget uoppdaget i kritiske IT-systemer i flere tiår, til at myndighetene så med nye øyne på behovet for å regulere teknologien. I mai samme år advarte pave Leo XIV mot KI og teknologimaktenes påvirkning på menneskeheten, og la særlig vekt på utdanningens avgjørende rolle (Leo XIV, 2026). Måneden etter kom det første søksmålet fra en amerikansk stat mot et KI-selskap basert på at samtalerobotene utgjør en risiko for enkeltbrukeres mentale helse og for sikkerheten i samfunnet (Mak et al., 2026). Omtrent på samme tid signerte president Trump en presidentordre som åpner for mer statlig tilsyn med lansering av nye KI-modeller (Frenkel & Mickle, 2026). I juli 2026 vakte det oppsikt at KI-modeller fra OpenAI i forbindelse med testing brøt seg ut av det som skulle være et sikret, internt område – en såkalt sandkasse – og utførte et dataangrep mot nettstedet Hugging Face (Dydland, 2026). En påfølgende gjennomgang avdekket at selskapets modeller også hadde hentet ut ikke-offentlige data fra flere australske offentlige etater, og Australias statsminister varslet rettslige konsekvenser (Sekulich & Lam, 2026). OpenAI har siden stanset treningen av sine mest avanserte modeller (Ward, 2026). I en tale til FN i september 2026 avviste imidlertid den amerikanske presidenten ethvert forslag om å etablere en global mekanisme for å sikre menneskelig kontroll over KI (Gangitano, 2026).
Disse temaene gjenspeiles i den levende debatten om bruk av KI-systemer innad i UH-sektoren. I juni 2026 kom den europeiske studentorganisasjonen European Students’ Union (ESU) med en uttalelse om at integrasjonen av KI-systemer i høyere utdanning ikke må styres av teknologiske muligheter eller markedsinteresser, men av pedagogiske hensyn, samfunnsansvar og grunnleggende europeiske verdier. ESU legger vekt på prinsipper for digital suverenitet, åpne standarder og europeisk samordning og regulering, og advarer mot uheldige effekter og risikoer på en rekke områder (European Students’ Union, 2026).
Slike brede strømninger i opinionen kan bidra til å styrke et prinsipp om tilbakeholden og selektiv bruk av KI-teknologi i høyere utdanning. Det kan føre til at teknologivalg i større grad blir et spørsmål om etikk, avhengigheter, beredskap og samfunnsansvar, og at universiteter og høyskoler må kunne begrunne hvorfor og på hvilke vilkår de tar teknologien i bruk.
En risiko i dette fremtidsbildet er at sektorens tilnærming blir for konservativ og fører til en svekkelse av utdanningenes relevans. Samtidig vil reguleringene og tilbakeholdenheten stå under et konstant press fra sterke kommersielle og geopolitiske interesser. Ukontrollert bruk av KI-systemer blant studenter og undervisere vil vedvare, og det samme vil utfordringene knyttet til læring og vurdering.
11.4 I kunnskapens tjeneste
Uavhengig av disse fremtidsbildene fremstår noen oppgaver som særlig viktige for universiteter og høyskoler i tiden som kommer. Institusjonene har et særskilt ansvar for å opprettholde og utvikle fagområdene gjennom forskning og forskningsbasert utdanning. Koblingen mellom forskning og utdanning er et grunnleggende kjennetegn ved høyere utdanning og en viktig forutsetning for faglig kvalitet og fornyelse, med betydning langt utenfor sektoren. Kunnskapen som utvikles og formidles i universitets- og høyskolefagene danner også grunnlag for undervisningen i andre deler av utdanningssystemet, som grunnskolen og videregående opplæring.
Dersom læringen individualiseres og kommersialiseres, kan forbindelsen mellom forskning, fagutvikling og utdanning bli svakere. Dette motvirkes best ved å sørge for at høyere utdanning ved universiteter og høyskoler har en merverdi ut over rent teknologibaserte læringstilbud.
Institusjonene skal ivareta funksjoner utover det å produsere kompetanse for arbeidslivet. De skal sørge for danning, faglige fellesskap, utvikling av vitenskapelige metoder og tenkemåter, og bidra til å ivareta en kritisk, demokratisk offentlighet.
Institusjonene skal også forvalte og utvikle kunnskap om teknologien som sådan, herunder dens virkninger, begrensninger og normative implikasjoner. I dette inngår det å utdanne kandidater som kan bruke og utvikle KI-systemer på en faglig forsvarlig, kritisk og ansvarlig måte.
Til slutt har universitets- og høyskolesektoren en sentral rolle i å sikre troverdig sertifisering av læringsutbytte i en tid der forholdet mellom informasjonskilder, hjelpemidler, samarbeid og selvstendige prestasjoner blir mer uklart. Dette gjelder både for tradisjonelle grader og for fremveksten av minikvalifikasjoner eller andre former for dokumentasjon av kompetanse. Dersom nye aktører får større innflytelse over hvordan kompetanse dokumenteres og blir verdsatt, kan det bli viktig å tydeliggjøre universitetenes og høyskolenes rolle som legitim og tillitvekkende sertifiseringsinstans.
Utvalget er overbevist om at den norske universitets- og høyskolesektoren har de beste forutsetninger for å lykkes med disse oppgavene. Gjennom å holde fast ved samfunnsoppdraget, sette menneskelig utvikling og faglige fellesskap i sentrum, opprettholde etiske prinsipper, gripe utviklingsmuligheter og dyrke en kultur for bevisst og reflektert KI-bruk, kan institusjonene være med på å forme utviklingen på måter som ivaretar menneskelig handlekraft og kognitive ferdigheter, bedrer tilgangen til kunnskap, støtter akademisk innsats og bidrar til dypere forståelse.
12 Økonomiske og administrative konsekvenser
Flere av utvalgets anbefalinger har økonomiske og administrative konsekvenser. Utvalget har ikke hatt mulighet til å kostnadsberegne anbefalingene, men vil likevel synliggjøre de økonomiske konsekvensene så godt som mulig, basert på utvalgets forståelse av dem. Anbefalingene med nevneverdige ressursimplikasjoner kan for dette formålet sorteres i fem temaer: faglig-pedagogisk utviklingsarbeid, kompetanseheving for ansatte, datainfrastruktur, vurderingsformer og karakterbegrunnelser.
Faglig-pedagogisk utviklingsarbeid
Utviklingen av kunstig intelligens (KI) har gitt et behov for å revurdere studietilbudenes læringsinnhold, læringsaktiviteter og vurderingsformer, både hver for seg og i sammenheng. Flere av utvalgets anbefalinger i kapitlene 5–7 og 9 dreier seg om behovet for faglig-pedagogisk utviklingsarbeid med bevissthet om KI. Behovet for slikt arbeid er særlig stort nå, mens generativ KI drevet på store grunnmodeller fortsatt er en fersk teknologi. Men det er også behov for å gjøre løpende og regelmessige vurderinger av studietilbudene i lys av teknologiutviklingen, kunnskapsutviklingen og rettsutviklingen på området.
For at fagmiljøene skal gjøre dette arbeidet godt, må de ha tid til det, og vitenskapelig ansatte jobber allerede langt over normal arbeidstid (Gunnes & Wendt, 2025). Hvilket omfang av arbeidstid det krever er praktisk talt umulig å beregne. Samtidig er det skalerbart. Institusjonenes rammebevilgning er i utgangspunktet ment å dekke faglig-pedagogisk utviklingsarbeid, men det må samtidig bemerkes at KI-utviklingen gir et vesentlig større behov for faglig-pedagogisk utviklingsarbeid enn hva institusjonene har måttet møte tidligere. Det er viktig at institusjonenes rammebevilgning tar høyde for dette behovet, som kommer i tillegg til andre faglige omstillingsbehov knyttet til politiske prioriteringer.
Utvalget anbefaler også sentrale myndigheter å opprette en konkurransebasert tilskuddsordning for faglig-pedagogisk utviklingsarbeid i lys av KI-utviklingen. Et slikt tiltak vil være en måte å støtte opp om institusjonenes arbeid og insentivere til utvikling av utdanningene, utenom rammebevilgningen, og skaper bedre muligheter for utviklingsarbeid på tvers av institusjoner. Et slikt tiltak er skalerbart, og utvalget legger til grunn at Kunnskapsdepartementet har erfaring med tilskuddsordninger fra tidligere.
Kompetanseheving for ansatte
Utvalget anbefaler universiteter og høyskoler å sørge for at alle undervisere har generell KI-kompetanse og utdanningsfaglig KI-kompetanse, og at alle fagmiljøer har tilstrekkelig fagspesifikk KI-kompetanse (kap. 10). Utvalget har ikke prioritert å forsøke å kartlegge kompetansenivået i sektoren eller detaljere mulige kompetansehevingstiltak. I fravær av tilstrekkelig informasjon kan ikke de nevnte anbefalingene kostnadsberegnes. At det vil kreve betydelige ressurser å få til det kompetanseløftet som anbefalingene innebærer, er utvalget imidlertid i liten tvil om. Samtidig er det nødvendig at ansatte har kunnskap om teknologien og dens rolle i utdanning og i fagene, dersom de skal kunne dra nytte av mulighetene og løse utfordringene KI skaper. Forvaltning av KI utgjør også et kompetansebehov. Utvalget vurderer at både den enkelte faglige ansatte, fagmiljøene, institusjonene og sentrale myndigheter har ansvar for å bidra til kompetanseutviklingen i sektoren.
Datainfrastruktur
Utvalget anbefaler at høyere utdannings behov for regnekraft og datalagring møtes gjennom nasjonal datainfrastruktur og gjennom samarbeid om datainfrastruktur med andre nordiske og europeiske land (kap. 8). Kostnaden for å anskaffe slik datainfrastruktur er betydelig, samtidig som en nasjonal infrastruktur vil gjøre at man over tid kan spare betydelige utgifter til lisenser på KI-systemer levert gjennom kommersielle skytjenester (med uviss prisutvikling i årene fremover). For å møte dagens behov, og vurdere omfanget av høyere utdannings fremtidige behov for regnekraft og datalagring, anbefaler utvalget at sentrale myndigheter henholdsvis avsetter midler og setter i gang en utredning.
Eksamen og vurdering
Utvalget anbefaler at institusjonene gjør større bruk av kontrollerte eksamensformer og supplerer ikke-kontrollerte eksamener med en kontrollert eksamensdel (kap. 7). Utvalget har kontaktet et utvalg institusjoner for å få informasjon om hva ulike eksamensformer koster i praksis. Informasjonen utvalget har mottatt, gir ikke grunnlag for å tallfeste kostnadene, blant annet fordi det er for mange variabler til at (de fleste) institusjonene selv kan beregne dem på generelt grunnlag. Se kapittel 7 for en beskrivelse av de ulike kostnadsdriverne ved valg av vurderingsform.
Utvalgets anbefalinger om eksamensformer vil trolig drive opp kostnadene til vurdering på to ulike måter: gjennom flere skoleeksamener (skriftlige, muntlige eller andre) og gjennom flere sammensatte vurderinger (altså flere vurderingsenheter i samme emne).
Når det gjelder skoleeksamen, antar utvalget at det jevnt over er dyrere enn hjemmeeksamen på grunn av behovet for eksamensvakter. Dette driver opp kostnadene noe. Det som kan drive opp kostnadene mer, er behovet for eksamenslokaler og eventuell datainfrastruktur. Sektoren har over tid tilpasset seg at mange emner kan gjennomføres med hjemmeeksamen eller semesteroppgaver som eksamensform, og har ikke nødvendigvis kapasitet til å gjennomføre skoleeksamener i det omfanget det blir behov for.
Når det gjelder sammensatte vurderinger, er de ikke nødvendigvis dyrere å gjennomføre enn ikke-sammensatte vurderinger. Likevel vil for eksempel muntlig eksamen på toppen av innlevert semesteroppgave innebære mer arbeid til vurdering enn hva en semesteroppgave alene krever. Dette gjelder spesielt om den kontrollerte eksamensdelen skal være egnet til å sette sensor i god posisjon til å gjøre en samlet vurdering av hvilket læringsutbytte kandidaten har oppnådd.
Karakterbegrunnelser
Utvalget mener at det er mulig å utvikle KI-systemer som kan gi tilfredsstillende, mer detaljerte automatiserte karakterbegrunnelser. Utvalget gir i kapittel 7 en betinget anbefaling om å lage en hjemmel for automatiserte karakterbegrunnelser. For å kunne gjøre dette på en forsvarlig måte, må det først utvikles egnede systemer og nødvendig kunnskap. Dersom karakterbegrunnelser blir automatisert, vil det imidlertid kunne spare sektoren for mange arbeidstimer.
Utvalget har gjort et forenklet overslag over hvor mye arbeidstid sensorer bruker på å utarbeide karakterbegrunnelser. Overslaget tar utgangspunkt i antallet karakterbegrunnelser Universitetet i Agder (UiA) ga i 2024 og 2025, sett opp mot deres andel av studentmassen, under den usikre antakelsen om at mengden karakterbegrunnelser ved UiA er representativ for sektoren. UiA mottok henholdsvis 10 518 og 10 274 krav om karakterbegrunnelser i 2024 og 2025. Tiden det tar å utarbeide karakterbegrunnelser avhenger av oppgavens omfang, hvor grundige notater sensor tar under karaktersetting og av hvor grundige karakterbegrunnelser sensor tar mål av seg å gi.56 Utvalget anser 20 minutter per karakterbegrunnelse som et forsiktig anslag. Under disse usikre antakelsene gikk det i sektoren med henholdsvis 74 280 og 72 095 timer av sensorers arbeidstid til karakterbegrunnelser, noe som svarer til nærmere 44 og 43 årsverk (1 695 timer).
Samlet vurdering
Slik utvalget vurderer behovene, vil høyere utdanning samlet sett bli mer ressurskrevende, spesielt på kort sikt, mens utdanningene tilpasser seg en ny teknologisk virkelighet. Flere av ressursbehovene gjelder også på lang sikt. Sett bort fra den betingede anbefalingen om automatiserte karakterbegrunnelser, kan sektoren trolig dekke inn noen av behovene gjennom muligheter KI-systemer gir for, for eksempel, administrativt arbeid og utvikling av undervisningsopplegg og -materiell. Likevel vurderer utvalget at høyere utdanning samlet sett blir mer ressurskrevende å drive, dersom sektoren skal dra nytte av mulighetene og løse utfordringene KI-utviklingen skaper, på en forsvarlig og faglig god måte.
Fotnoter
Det er verdt å minne om at utvalget er avgrenset fra å vurdere dimensjonering av studietilbud (jf. kap. 1.2 om utvalgets mandat). Kapittelet er derfor utformet slik at det skal kunne støtte arbeid med å utvikle studietilbudenes læringsinnhold, til forskjell fra det å vurdere hvor mange studieplasser det er behov for i den respektive utdanning.
En resonnerende modell gjør mange beregninger mens den skaper utdata, for eksempel gjennom å stykke opp forespørselen i deloppgaver som kan løses trinnvis, eller for å kvalitetssikre svarene den gir fra seg.
«Total faktorproduktivitet» viser til hvor effektivt en økonomi eller virksomhet klarer å bruke sine produksjonsfaktorer – vanligvis arbeid og kapital – til å skape verdier.
Digital Education Council er en global organisasjon med rundt 200 høyere utdanningsinstitusjoner som medlemmer. Organisasjonen har partnerskap med forlaget Pearson og utdanningsteknologiselskapet Instructure.
Kompetansebehovsutvalget fremhever i tillegg «muliggjørende kompetanser» som en viktig kategori, se kommentar nedenfor (jf. kap. 5.4.2).
Utvalget tar ikke for seg såkalt spesialisert KI-kompetanse – den kunnskapen og de ferdighetene som kreves for å utvikle og drifte KI-systemer. Fagmiljøene som til daglig jobber med å utvikle spesialistkompetanse er i en bedre posisjon enn utvalget til å bedømme hva slags KI-kompetanse deres studenter har behov for.
Noen av studiene fokuserer på yrkers KI-eksponering, men oppgaver er typisk sett den mer grunnleggende analyseenheten i studiene. Yrker kan, som en nyttig forenkling, forstås som sett med oppgaver (Autor, 2013).
I studien ble hver oppgave klassifisert enten av mennesker med ekspertise på egenskapene til store språkmodeller eller av en stor språkmodell (OpenAIs GPT-4). De maskinelle klassifikasjonene viste lite avvik fra de menneskelige. Klassifikasjonene har vel å merke ikke uavhengig empirisk støtte, noe som innebærer at man må være forsiktig med å trekke sterke slutninger fra funnene, jf. Mouchel et al. (2026).
Claude Code fra Anthropic og Codex fra OpenAI er gode eksempler.
Problemløsning er en kjerneaktivitet, men matematikk består av mer, for eksempel teoriutvikling (Tao, 2026).
Med «kanonisering» menes her at de blir en del av konsensus i faget, som en del av et større repertoar av løsninger. Det innebærer blant annet at bevisene blir innlemmet i lærebøker, i forbedret form (Tao, 2026, s. 8–9).
Prinsippet er også forskriftsfestet som et akkrediteringsvilkår, i den forstand at «undervisnings-, lærings- og vurderingsformer skal være tilpasset læringsutbytte» (universitets- og høyskoleforskriften, § 1-11e, se også kap. 2).
Merk at studien tar for seg elever på videregående.
Slik bruk kan også utgjøre brudd på opphavsretten (jf. kap. 4).
Det er verdt å understreke at læringsgevinsten av tilbakemeldinger avhenger av hva studentene gjør med tilbakemeldingene, ikke bare av tilbakemeldingenes kvalitet.
Vi ser i denne sammenhengen bort fra arbeidskrav som ikke er vurderingsaktiviteter, f.eks. krav om oppmøte til undervisning.
For dette formålet har vi altså sett bort fra arbeidskrav, som det også finnes rapportering på.
En oversikt over FS-virksomheter ligger her: https://www.fellesstudentsystem.no/samarbeid-og-medvirkning/FS-virksomheter.html (sist besøkt 15 desember 2025). Av disse inkluderer ikke datasettet data fra Forsvarets høyskoler, Samisk Høgskole eller Noroff. Andelen studenter («90 prosent av den totale studentmassen») er basert på registrerte studenter i 2025 (DBH, 2025a).
For enkelhets skyld skriver vi her «eksamensregler» også når reglene gjelder arbeidskrav.
Tilsyn med gjennomføring av digitale hjemmeeksamener innebærer behandling av personopplysninger etter GDPR artikkel 4 nr. 1 og nr. 2. Video- og lydopptak fra studentens hjem, samt identitetskontroll, faller klart innenfor forordningens virkeområde.
I august 2026 har Anthropic lansert vannmerking av KI-generert tekst, som er en usynlig og innebygd metode. Se Gibney (2026).
Bestemmelsens forarbeider utdyper om sensurering av bacheloroppgaver: «Begge sensorene kan komme fra den aktuelle institusjonen. Institusjonen bør imidlertid tilstrebe at den ene av de to sensorene kommer fra annen institusjon dersom dette er praktisk mulig. Hvis ikke dette er mulig, bør sensoren ikke ha tilknytning til eller kjennskap til studentene på det studiet den skal være sensor ved. For eksempel bør den ene sensoren ikke være ansatt i hovedstilling eller bistilling tilknyttet utdanningen, og heller ikke hatt engasjement som timelærer i det aktuelle emnet for eksamenskullet. Hensyn til kvalitetssikring og rettssikkerhet for studentene må veie tungt ved oppnevning av sensorer.» (Prop. 126 L (2022–2023), s. 341).
Muntlige eksamener kan naturligvis også være begrunnet på andre måter, ved at de gir mulighet til å prøve en viktig ferdighet, nemlig muntlig formidling av kunnskap.
Utvalget uttaler seg her kun om kombinasjonseksamener for å sikre at en ukontrollert eksamen med tilgang til KI-systemer kan suppleres med en kontrollert eksamensdel. Regelen kan fortsatt være relevant i andre eksamenssammenhenger, for eksempel tilfellet det vises til i forarbeider til uhl. § 11-11 fjerde ledd: «Hvis den skriftlige delen er en gruppeinnlevering med justerende muntlig skal den som klager få lov til å prøves i muntlig alene dersom den skriftlige delen endrer sluttvurderingen fra førstegangssensuren.» (Prop. 126 L (2022–2023), pkt. 23-11, merknad til § 11-11).
Filming av muntlig eksamen og klageadgang ble tidligere omtalt i Prop. 64 L (2017–2018), punkt 4.2.4. Utvalgets anbefaling i NOU 2020: 3 ble fulgt opp i Prop. 126 L (2022–2023), pkt. 15.10.2 og 15.10.4.2.
Det er også mulig å hente inn samtykke fra studenter til å gjøre lyd- eller videoopptak på muntlige eksamener, men det vil ikke nødvendigvis oppfylle kravene til frivillig samtykke etter GDPR art. 7 nr. 4, gitt det skjeve maktfoholdet mellom studenten og institusjonen.
Dersom den KI-utarbeide oppfølgingsprøven derimot skal brukes til formål utover dette, mer som et selvstendig eller likeverdig vurderingsgrunnlag, er det usikkert om det er saklig grunn for ulike prøver.
Nærmere bestemt fant Kortemeyer at 84 prosent av variasjonen i de manuelt tildelte karakterene kan forklares av karakterene gitt av KI.
Dette målet er også grunnen til at universitets- og høyskoleloven stiller krav om sensorveiledning: Den skal sikre en mest mulig ensartet vurdering av eksamensoppgavene, jf. merknad til § 11-7 i Prop. 126 L (2022–2023).
Uhl. § 17-1 åpner for tidsavgrensede pedagogiske eller organisatoriske forsøk, der Kunnskapsdepartementet kan innvilge unntak fra uhl. og tilhørende forskrifter. Forarbeidene til regelen avgrenser slike forsøk mot studentenes grunnleggende rettigheter (Prop. 126 L (2022–2023), merknad til § 17-1). Det kan være at retten til (menneskelig) sensur regnes som en grunnleggende rettighet.
Merk at ikke-automatisert bruk av KI-systemer, for eksempel til utarbeidelse av forslag til sensur, eller til å fungere som et mindre inngripende hjelpemiddel, ikke faller under automatiserte avgjørelser etter GDPR art. 22 jf. ny forvaltningslov §§ 11 og 12. Den menneskelige rollen i sensurarbeidet må imidlertid være reell og utført av kompetente sensorer som har fått retningslinjer og/eller trening slik at sensorene gjør en selvstendig vurdering. Se Colonna (2024, s. 14–15).
Gjennomføring av KI-forordningen i norsk rett har vært på høring, skal på ny høring, og en lovproposisjon er planlagt sendt til Stortinget våren 2027. Ikrafttredelse av KI-forordningens regler om høyrisikosystemer (Vedlegg III, herunder utdanning) er utsatt til 2. desember 2027. Se kapittel 4.3.2.
Det kan være gråsoner mellom summative og formative vurderinger. For veiledning og praktiske eksempler, se EU-kommisjonens utkast til veileder om klassifisering av høyrisikosystemer (EU-kommisjonen, 2026d, avsnitt 220–225 med eksempler).
Hvorvidt avvik skal føre til endringer i karakterer, er noe som må vurderes av sensor, dersom kvalitetssikringen skal falle under unntaket fra høyrisikoklassifisering. Se KI-forordningen art. 6 nr. 3 første ledd og andre ledd, bokstav c jf. EU-kommisjonen, 2026d, avsnitt 97–102 og 220–225 med eksempler. Merk at dersom et KI-system identifiserer avvik basert på profilering av fysiske personer, vil det likevel bli klassifisert som høyrisikosystem etter KI-forordningen art. 6 nr. 3 tredje ledd.
For automatisering trengs det en hjemmel i nasjonal rett, som nevnt ovenfor.
Ved bruk av KI-systemer som hjelpemiddel er det påbudt å gjennomføre en personvernkonsekvensvurdering (DPIA), etter GDPR art. 35 nr. 1. Kravet gjelder ved høy risiko for fysiske personers rettigheter og friheter, og særlig ved bruk av ny teknologi. Samlet gjør dette at bruk av KI-systemer som hjelpemiddel til sensur er omfattet av påbudet. I de tilfellene det er hjemmel for å automatisere, er det påbudt å gjennomføre en personvernkonsekvensvurdering etter GDPR art. 35 nr. 3 bokstav a.
Trening av KI-modeller med eksamensbesvarelser må være tilstrekkelig hjemlet i henhold til personvernregelverket. Studenters samtykke er ikke egnet som hjemmel, blant annet fordi det i praksis kan være umulig å fjerne treningsgrunnlaget til en KI-modell dersom en student trekker sitt samtykke tilbake. Skal eksamensbesvarelser brukes til trening er det behov for en generell hjemmel i nasjonal rett.
Kulturdepartementet har sendt en lovproposisjon til Stortinget om endringer i åndsverkloven mv. (Prop. 41 LS (2025–2026)) som er planlagt behandlet høsten 2026.
Dette bryter med blant annet sensorkravet i universitets- og høyskoleloven § 11-7 og ny forvaltningslov, prinsipper for behandling av personopplysninger i GDPR art. 5 og ansattes forpliktelser etter GDPR art. 29. Et samtykke fra studenten avhjelper ikke disse ulovlighetene, da samtykket normalt ikke vil kunne ansees som frivillig etter GDPR art. 7, i en ujevn maktbalanse mellom sensor/institusjon og student.
I utgangspunktet er forskning om og utvikling av KI-systemer unntatt fra virkeområdet til KI-forordningen, men ikke testing under virkelige forhold (med ekte eksamensbesvarelser i en reell eksamenssituasjon), jf. KI-forordningen art. 2 nr. 8. For testing av høyrisikosystemer under virkelige forhold gjelder det egne regler, inkludert et informert samtykke fra studenter, se KI-forordningen art. 60–61. Det er også mulig å teste innenfor regulatoriske sandkasser for KI, se KI-forordningen art. 57–59.
Den skiller seg fra den generelle retten ved at karakterbegrunnelsen ikke må gis samtidig med vedtaket, men etter at studenten har bedt om det.
Dette gjelder selv om automatisering innebærer krav til menneskelig kontroll – det er fortsatt vidt forskjellig fra menneskelig ansvar.
Se rett til forklaring nedenfor etter ny forvaltningslov § 12. I tillegg inneholder KI-forordningen krav til det overordnede KI-systemets forklarbarhet, se Boks 4.3.
Et annet argument er at en dårlig begrunnelse kan være tegn på en dårlig karaktersetting, og dermed gi grunn til omgjøring av karaktervedtaket jf. ny forvaltningslov § 71.
Det er gjerne tolkningen av «betydelig påvirker» som blir avgjørende. Rettspraksis på dette feltet er under utvikling.
Merk at retten til forklaring etter ny forvaltningslov § 12 andre ledd skal følge med en automatisert avgjørelse (her: en KI-begrunnelse). Kravene til forklaringens innhold vil i stor grad overlappe med kravene til begrunnelse etter ny forvaltningslov § 57, slik at begrunnelsen i stor grad vil ivareta retten til forklaring (Prop. 79 L (2024–2025), pkt. 8.5.3.3).
For bruk av KI-systemer som beslutningsstøtte til karakterbegrunnelser, er det mindre tydelig om dette er omfattet av høyrisikoklassifiseringen. At systemet brukes som beslutningsstøtte gir i utgangspunktet ikke unntak (jf. kap. 7.11.1.2). På grunn av den særnorske konstruksjonen der karakterbegrunnelser er frikoblet sensurvedtaket, kan det likevel argumenteres for at KI-systemer til støtte for utvikling av karakterbegrunnelser kan unntas høyrisikoklassifisering, men dette er usikkert.
Loggene skal oppbevares og legge til rette for internkontroll. Kravene for idriftsettere om å oppbevare loggen gjelder kun for logger under deres kontroll, og det vil avhenge av hvilket system som brukes. En teknisk standard for loggføring er under utvikling.
Ved bruk av KI-system til karakterbegrunnelser, både som hjelpemiddel og ved automatisering, er det påbudt å gjennomføre en personvernkonsekvensvudering etter personvernforordningen art. 35 nr. 1, fordi det innebærer bruk av ny teknologi. Se også kap. 4.3.3.
Med utdanningsrelevant KI-system menes her KI-systemer som institusjonen bruker selv eller tilbyr studentene i forbindelse med undervisning, læring og vurdering. Det omfatter også løsninger hvor KI er integrert eller utgjør en tilleggsmodul.
H100 ekvivalent tilsvarer regnekraften til en GPU (grafikkprosessor) fra Nvidia.
Med «skygge-KI» menes studenters og ansattes bruk av KI-systemer som ikke er godkjent av institusjonen.
RAG (Retrieval-Augmented Generation) er en teknikk hvor man kan koble en KI-modell til en ekstern database, for eksempel for å gi mer nøyaktige og pålitelige svar innenfor en gitt brukskontekst.
Avtalen gjør det mulig å bruke opphavsrettsbeskyttet materiale på en enkel og lovlig måte. Den gir trygghet for brukerne og sikrer samtidig at de som har skapt og utgitt innholdet, får betalt når verkene deres kopieres og brukes.
Utvalget forutsetter at det går utover universitets- og høyskolesektorens samfunnsoppdrag og finansielle evne å utvikle store KI-modeller fra grunnen av. Det utelukker ikke å utvikle andre KI-systemer, eller å videretrene og finjustere store KI-modeller for å tilpasse dem til å løse oppgaver i sektoren.
Arbeidstiden man må anslå at karakterbegrunnelser tar, er ikke bare en funksjon av hvor lang tid det tar å utarbeide dem når kravene kommer – sensor kan ha lagt inn en større innsats på notater under karaktersettingen, for å komme behovet i forkjøpet.